# WinServer运维
# windows server 2022用命令行为raid5磁盘联机并分区格式化
打开cmd。输入命令:
diskpart
list disk
select disk <磁盘编号>
online disk
PowerShell命令:
配置为GPT:Initialize-Disk -Number 0 -PartitionStyle GPT
分区:New-Partition -DiskNumber 0 -UseMaximumSize -AssignDriveLetter
格式化:Format-Volume -DriveLetter F -FileSystem NTFS -NewFileSystemLabel "HDD-RAID5" -Confirm
# Windows Installer 服务无法访问 解决方法
Windows Installer 服务无法访问。这只在如果您在安全模式中运行Windows,或者是如果 Windows Installer 未正确安装才发生。请联系您的支持人员获取援助。 如果排查是否中病毒或系统故障导致
ChatGPT 说:
Windows Installer 服务无法访问的错误,通常由以下几种原因导致:
Windows Installer 服务未启动或损坏
系统文件损坏(可能由病毒、恶意软件或系统异常引起)
权限问题(注册表或组策略导致 Windows Installer 无法正常运行)
安全模式限制(在安全模式下,Windows Installer 默认是禁用的)
🛠 排查步骤
1️⃣ 检查 Windows Installer 服务是否运行
按 Win + R,输入 services.msc 回车
在 服务 窗口中找到 Windows Installer(服务名称:msiserver)
右键 → 属性
查看“启动类型”:
如果是 “禁用” → 改为 “手动” 或 “自动”
如果未运行,点击“启动”
📌 如果启动时报错,继续执行下面的步骤。
2️⃣ 重新注册 Windows Installer
按 Win + R,输入 cmd,按 Ctrl + Shift + Enter 以管理员身份运行命令提示符
依次执行以下命令:
msiexec /unregister
msiexec /regserver
重启计算机,然后尝试重新安装软件。
3️⃣ 运行 Windows 组件修复
打开命令提示符(管理员模式)
执行以下命令,修复 Windows 组件:
sfc /scannow
等待扫描完成,检查是否有损坏的系统文件。
如果 sfc 找到了问题但无法修复,请运行:
dism /online /cleanup-image /restorehealth
这将从 Windows 更新中获取缺失的文件并修复系统。
4️⃣ 检查 Windows Installer 相关注册表
📌 如果你怀疑病毒或系统损坏导致注册表异常,可以检查并修复相关项
按 Win + R,输入 regedit,回车
找到以下路径:
HKEY_LOCAL_MACHINE\SYSTEM\CurrentControlSet\Services\msiserver
在右侧窗口,找到 Start 键值
如果 Start 的值不是 2,则双击修改为 2(十进制)
关闭注册表,重启计算机。
5️⃣ 在“安全模式”中启用 Windows Installer
📌 如果你是在 安全模式 下安装软件,默认 Windows Installer 是禁用的,你需要手动启用它。
按 Win + R,输入 cmd,按 Ctrl + Shift + Enter 运行命令提示符
执行以下命令:
net start msiserver
如果提示 服务无法启动,手动修改注册表:
打开注册表编辑器 (regedit)
进入:
HKEY_LOCAL_MACHINE\SYSTEM\CurrentControlSet\Control\SafeBoot\Minimal\
新建一个键,命名为 MSIServer
修改默认值为 Service
重启计算机,重新尝试安装软件。
6️⃣ 检查是否中了病毒
如果问题仍然存在,可能是病毒或恶意软件修改了 Windows Installer 相关组件:
使用 Windows Defender 进行全盘扫描
下载第三方杀毒软件(如 Malwarebytes、火绒等)进行深度扫描
检查任务管理器 (Ctrl + Shift + Esc) 是否有可疑进程占用 CPU
📌 总结
先检查 Windows Installer 服务是否启动
尝试重新注册 Windows Installer (msiexec /regserver)
运行 SFC 和 DISM 以修复系统文件
检查注册表 (HKEY_LOCAL_MACHINE\SYSTEM\CurrentControlSet\Services\msiserver)
如果在安全模式安装软件,需手动启用 Windows Installer
如果所有方法都试过了还是不行,可能需要 系统修复(如重置 Windows)。你可以尝试使用 Windows 修复模式(WinRE),执行“系统还原”或“重置此电脑”。
# 额外域控服务器,更新补丁后,启动时卡在 请等候 Group Policy Client
在额外域控制器上更新补丁后,如果系统启动时卡在“请等候 Group Policy Client”,通常是由于组策略客户端服务 (gpsvc) 出现问题,或者某些更新引发了服务冲突。以下是一些常见的排查方法及解决方案:
1. 检查组策略客户端服务 (GPSVC) 的状态
进入安全模式:
如果服务器无法正常启动,你可以尝试在 安全模式 下启动系统。启动系统时,按 F8 或 Shift + F8(取决于硬件配置)进入高级启动选项,选择 安全模式 启动。
检查组策略客户端服务:
按 Win + R,输入 services.msc,回车进入服务管理器。
找到 Group Policy Client 服务 (GPSVC) 并检查其状态。如果服务未启动,可以尝试启动它。
确保该服务的 启动类型 为 自动。
手动启动 GPSVC 服务:
打开命令提示符(以管理员身份),运行以下命令启动服务:
bash
net start gpsvc
2. 重置组策略
有时组策略设置可能导致问题,重置组策略可能有助于解决问题。
重置计算机的本地组策略: 在命令提示符下运行以下命令以重置所有本地组策略:
bash
gpupdate /force
如果系统允许启动,重置组策略后重启服务器,看看问题是否解决。
删除缓存的组策略:
进入文件管理器,导航到以下路径:
makefile
C:\Windows\System32\GroupPolicy\
删除该文件夹下的所有内容(不要删除文件夹本身)。
重启服务器,系统会重新生成默认的组策略文件。
3. 卸载更新
如果你认为问题是由最近的补丁引起的,可以尝试卸载最近安装的更新:
通过命令提示符卸载补丁: 在安全模式下或通过恢复环境进入命令提示符,使用以下命令列出最近的更新:
bash
wmic qfe list brief /format:table
找到最近安装的更新,记下对应的 KB 编号。
卸载更新: 使用以下命令卸载更新:
bash
wusa /uninstall /kb:<KB编号>
例如,卸载 KB5005568:
bash
wusa /uninstall /kb:5005568
4. 检查磁盘和文件系统问题
有时磁盘或文件系统的损坏也可能导致服务挂起。可以尝试检查和修复磁盘:
进入恢复环境:
重启服务器,进入恢复模式,选择命令提示符。
运行磁盘检查: 在命令提示符下运行以下命令以修复文件系统问题:
bash
chkdsk /f /r
这将检查并修复磁盘上的错误,可能需要重启以完成修复过程。
5. 禁用不必要的启动项和服务
有时第三方服务或应用程序可能会与组策略服务发生冲突。你可以禁用非必要的启动项来排查问题。
进入安全模式。
使用 msconfig 工具:
按 Win + R,输入 msconfig 并按回车。
在 服务 选项卡下,勾选 隐藏所有 Microsoft 服务,然后点击 全部禁用。
在 启动 选项卡下,禁用所有第三方启动项。
重启服务器,检查问题是否解决。
6. 还原系统状态或恢复系统
如果以上方法都无效,且问题是在更新补丁后发生的,考虑还原系统到更新前的状态。
使用系统还原点:
如果启用了系统还原,你可以通过 恢复环境 选择 系统还原,回滚到更新前的系统状态。
还原 Active Directory 系统状态:
如果你有 Active Directory 系统状态备份,可以考虑使用备份恢复到稳定状态。
使用 Windows Server Backup 还原系统状态,确保 Active Directory 数据库未受损。
7. 重建域控制器
如果上述所有方法都未能解决问题,且此额外域控制器无法恢复正常工作,可能需要考虑重建该域控制器。
从域中删除问题服务器:
使用 dcpromo 将该服务器降级为成员服务器。
检查域内其他域控制器是否正常工作。
重新加入域并提升为额外域控制器:
清理该服务器上与 Active Directory 相关的旧数据。
重新将服务器加入域,并使用 dcpromo 再次将其提升为域控制器。
总结
“请等候 Group Policy Client”问题通常与组策略客户端服务(GPSVC)有关。你可以通过检查服务状态、重置组策略、卸载补丁或修复文件系统等方法排查和解决问题。如果问题严重,可以考虑还原系统状态或重建域控制器。
# 为windows开启winrm service, 以便进行远程管理
winrm service: 是windows 一种方便远程管理的服务;开启winrm service,便于在日常工作中,远程管理服务器,或通过脚本,同时管理多台服务器,来提高工作效率;
工具/原料
windows server
方法/步骤
winrm service 默认都是未启用的状态,先查看状态;如无返回信息,则是没有启动;
winrm enumerate winrm/config/listener
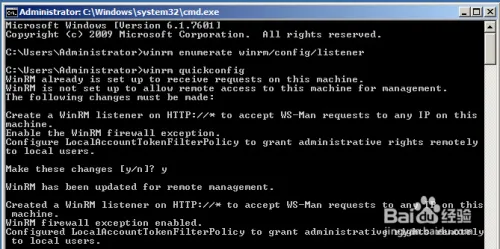
针对winrm service 进行基础配置:
winrm quickconfig
[](https://bost.lesrec.cn/uploads/images/gallery/2025-05/ysVZwt5EiYYxjauX-vlPimage.png)
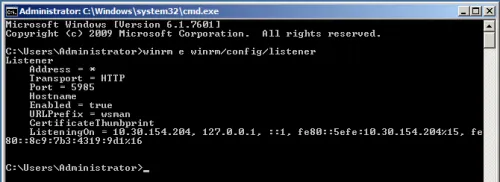
查看winrm service listener:
winrm e winrm/config/listener
[](https://bost.lesrec.cn/uploads/images/gallery/2025-05/Jy7KbKyHH2C935uc-TrFimage.png)
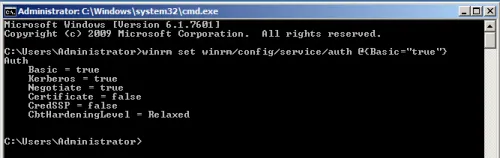
为winrm service 配置auth:
winrm set winrm/config/service/auth @{Basic="true"}
[](https://bost.lesrec.cn/uploads/images/gallery/2025-05/kpIqvoRbasmo63rl-YlSimage.png)
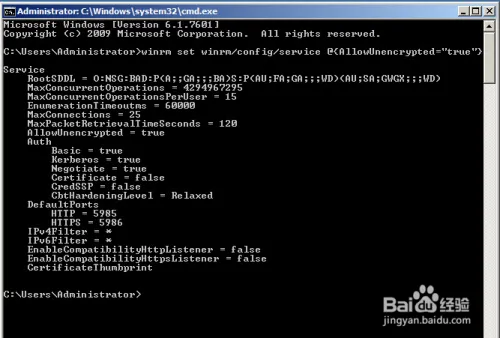
为winrm service 配置加密方式为允许非加密:
winrm set winrm/config/service @{AllowUnencrypted="true"}
[](https://bost.lesrec.cn/uploads/images/gallery/2025-05/WppYuMUVHIdcghg1-Oqrimage.png)
6
至此,winrm service 已经启用,可以正常使用;
# 批量重启含“veeam”关键字的所有服务的命令
在 Windows Server 操作系统上,你可以使用 PowerShell 来批量重启包含特定关键字的服务。假设你要重启所有包含 "veeam" 关键字的服务,你可以执行以下命令
Get-Service | Where-Object { $_.DisplayName -like "*veeam*" } | Restart-Service -Force
要关闭包含特定关键字的所有服务,你可以使用类似的 PowerShell 命令。以下是关闭所有包含 "veeam" 关键字的服务的命令:
powershell
Copy code
Get-Service | Where-Object { $_.DisplayName -like "*veeam*" } | Stop-Service -Force
这个命令与之前的命令相似,不同之处在于它使用了 Stop-Service 来停止服务而不是重启服务。
解释一下这个命令:
Get-Service:获取系统中的所有服务。
Where-Object { $_.DisplayName -like "*veeam*" }:过滤包含 "veeam" 关键字的服务。
Stop-Service -Force:对过滤出来的服务执行强制停止操作。
同样,请确保以管理员权限运行 PowerShell,以便执行服务关闭操作
# SCVMM服务器修复SQL server损坏数据库
`❗ VirtualManagerDB = SUSPECT` 状态,说明 **VMM 的数据库已损坏或启动失败**,这是导致你 SCVMM 无法启动的根本原因。
---
## ❗ 什么是 SUSPECT 状态?
当 SQL Server 启动数据库时,如果发现:
- 日志或数据文件不一致;
- 上次关闭未正确;
- 数据库文件损坏或磁盘I/O异常;
就会把数据库标记为 `SUSPECT`,**阻止连接以保护数据完整性**。
---
## ✅ 恢复 SUSPECT 数据库的方法(紧急修复)
以下操作为标准修复流程,请在 **SQL Server Management Studio (SSMS)** 中用 **管理员账号执行**:
---
### 🔧 1. 设置数据库为紧急模式
```sql
USE master;
ALTER DATABASE VirtualManagerDB SET EMERGENCY;
```
> EMERGENCY 模式允许仅限管理员访问,并绕过部分一致性检查。
---
### 🔍 2. 设置为单用户模式
```sql
ALTER DATABASE VirtualManagerDB SET SINGLE_USER;
```
---
### 🔁 3. 执行数据库修复
```sql
DBCC CHECKDB (VirtualManagerDB, REPAIR_ALLOW_DATA_LOSS);
```
> ⚠️ 警告:此操作可能会**丢失部分损坏数据页**,但能恢复数据库可用状态。
---
### 🔄 4. 恢复多用户模式
```sql
ALTER DATABASE VirtualManagerDB SET MULTI_USER;
```
---
### ▶️ 5. 检查是否恢复成功
执行:
```sql
SELECT name, state_desc FROM sys.databases WHERE name = 'VirtualManagerDB';
```
应显示:`ONLINE`
---
### ✅ 6. 启动 VMM 服务验证
```powershell
Start-Service SCVMMService
```
并观察服务是否正常启动。此时 `Zabbix 控制台 / 管理员界面` 也应能连接。
---
## ✅ 修复成功后建议操作:
1. **立即备份数据库**:
```sql
BACKUP DATABASE VirtualManagerDB TO DISK = 'C:\backup\VirtualManagerDB.bak'
```
2. 定期设置自动备份和 SQL 检查计划(DBCC CHECKDB)
3. 检查存储硬盘 SMART 状态,防止物理故障导致后续再次损坏
---
## ❗ 如果修复失败或数据极其重要
可尝试以下方案:
- 使用最近的 `.bak` 备份还原数据库
- 使用专业 SQL 数据恢复工具(如 ApexSQL Recover)
- 联系 Microsoft 支持进行 SQL 数据库恢复服务
---
## ✅ 总结恢复流程
| 步骤 | 命令 | 说明 |
|---|
| 1 | `ALTER DATABASE ... SET EMERGENCY` | 允许管理员访问 |
| 2 | `SET SINGLE_USER` | 进入修复模式 |
| 3 | `DBCC CHECKDB ... REPAIR_ALLOW_DATA_LOSS` | 修复损坏页 |
| 4 | `SET MULTI_USER` | 恢复正常 |
| 5 | 启动 VMM 服务 | 测试恢复结果 |
---
你是否需要我为你生成以上命令的一键 SQL 脚本?是否存在近期 `.bak` 备份?是否考虑备份数据后再修复?可以协助你制定风险最低的方案。
# SAS机械硬盘组raid5读写速度计算
在由 \*\*8块SAS 14TB 7200转 512MB缓存\*\* 硬盘组成的 \*\*RAID 5\*\* 阵列中,硬盘读写速度的计算涉及 \*\*单盘性能、RAID 5 特性、缓存影响\*\* 等多个因素。以下是详细分析:
\---
\## \*\*1. 单块硬盘的理论性能\*\*
\- \*\*接口类型\*\*:SAS 12Gbps(理论带宽 \*\*1.2GB/s\*\*,实际受硬盘限制)。
\- \*\*转速\*\*:7200 RPM(影响随机IOPS,顺序读写依赖接口和缓存)。
\- \*\*缓存\*\*:512MB(提升突发读写性能)。
\- \*\*典型顺序读写速度\*\*(SAS 7200 RPM):
\- \*\*读速度\*\*:\*\*180~220 MB/s\*\*(受寻道时间和接口限制)。
\- \*\*写速度\*\*:\*\*160~200 MB/s\*\*(受写入策略影响)。
\---
\## \*\*2. RAID 5 对性能的影响\*\*
RAID 5 采用 \*\*条带化(Striping)+ 奇偶校验(Parity)\*\*,特点:
\- \*\*读性能\*\*:接近所有磁盘的聚合带宽(N-1 块盘有效)。
\- \*\*写性能\*\*:受“写惩罚”(Write Penalty)影响,每次写入需计算并写入奇偶校验,导致额外开销。
\### \*\*RAID 5 性能计算公式\*\*
| \*\*操作\*\* | \*\*计算公式\*\* | \*\*8盘RAID 5 估算\*\* |
|----------|------------|------------------|
| \*\*顺序读\*\* | `(N-1) × 单盘读速度` | `7 × 200 MB/s ≈ \*\*1,400 MB/s\*\*` |
| \*\*顺序写\*\* | `(N-1) / 4 × 单盘写速度` | `7 / 4 × 180 MB/s ≈ \*\*315 MB/s\*\*` |
| \*\*随机读(IOPS)\*\* | `(N-1) × 单盘IOPS` | `7 × 150 ≈ \*\*1,050 IOPS\*\*` |
| \*\*随机写(IOPS)\*\* | `(N-1) / 4 × 单盘IOPS` | `7 / 4 × 150 ≈ \*\*262 IOPS\*\*` |
> \*\*注\*\*:
> - \*\*N = 8\*\*(8块盘),RAID 5 可用容量 = `(N-1) × 单盘容量 = 7 × 14TB = 98TB`。
> - \*\*写惩罚(Write Penalty)= 4\*\*(RAID 5 每次写入需 \*\*读旧数据 + 读奇偶校验 + 写新数据 + 写新校验\*\*)。
> - 实际性能受 \*\*RAID控制器、缓存策略、负载类型\*\* 影响。
\---
\## \*\*3. RAID 控制器缓存的影响\*\*
\- \*\*512MB 缓存(Write-Back模式)\*\*:
\- \*\*提升随机写入性能\*\*(缓存吸收小IO请求,延迟刷入磁盘)。
\- \*\*突发写入速度可能接近接口极限(1.2GB/s)\*\*,但持续写入仍受硬盘限制。
\- \*\*缓存策略\*\*:
\- \*\*Write-Back(推荐)\*\*:写入先到缓存,再异步写入磁盘 → \*\*更高写入速度,但断电可能丢数据\*\*。
\- \*\*Write-Through\*\*:直接写入磁盘 → \*\*更安全,但速度慢\*\*。
\---
\## \*\*4. 实际场景性能估算\*\*
| \*\*场景\*\* | \*\*理论速度(RAID 5)\*\* | \*\*实际可能速度(考虑开销)\*\* |
|----------|----------------|------------------|
| \*\*大文件顺序读\*\* | 1,400 MB/s | \*\*1,000~1,300 MB/s\*\* |
| \*\*大文件顺序写\*\* | 315 MB/s | \*\*250~300 MB/s\*\* |
| \*\*4K 随机读(IOPS)\*\* | 1,050 IOPS | \*\*800~1,000 IOPS\*\* |
| \*\*4K 随机写(IOPS)\*\* | 262 IOPS | \*\*200~250 IOPS\*\* |
> \*\*关键瓶颈\*\*:
> - \*\*顺序读写\*\*:受硬盘接口和RAID 5 校验计算限制。
> - \*\*随机IOPS\*\*:受硬盘寻道时间(7200 RPM 约 \*\*4~6ms\*\*)和RAID 5 写惩罚影响。
\---
\## \*\*5. 优化建议\*\*
1\. \*\*更换RAID级别(如RAID 10)\*\*:
\- \*\*写性能提升\*\*(无写惩罚,随机写IOPS ≈ `N/2 × 单盘IOPS`)。
\- 但容量减半(8盘RAID 10 = 4 × 14TB = 56TB)。
2\. \*\*升级硬件\*\*:
\- 使用 \*\*SSD缓存(如RAID卡带CacheCade)\*\* 加速随机IO。
\- 选择 \*\*更高转速硬盘(如10K/15K SAS)\*\* 提升IOPS。
3\. \*\*调整RAID参数\*\*:
\- \*\*条带大小(Stripe Size)\*\* 匹配应用(如数据库用64KB,视频存储用256KB)。
\- 启用 \*\*预读(Read-Ahead)\*\* 优化顺序读。
\---
\## \*\*总结\*\*
\- \*\*8盘SAS RAID 5 理论性能\*\*:
\- \*\*顺序读\*\*:\*\*1,000~1,400 MB/s\*\*
\- \*\*顺序写\*\*:\*\*250~350 MB/s\*\*
\- \*\*随机4K写\*\*:\*\*200~250 IOPS\*\*
\- \*\*实际速度可能低20%~30%\*\*(受控制器、负载、缓存策略影响)。
\- \*\*如需更高写入性能\*\*,建议改用 \*\*RAID 10\*\* 或 \*\*增加SSD缓存\*\*。
如果需要更精确的测试,可以使用 \*\*fio\*\* 或 \*\*CrystalDiskMark\*\* 在真实环境中基准测试。
# ZeroSSL 申请免费SSL证书的方法
ZeroSSL 是一家提供免费SSL证书的服务商,其免费证书有效期为90天,适合个人博客、小型网站或测试环境使用。下面是在ZeroSSL官网申请免费SSL证书的步骤。
\### 📌 ZeroSSL 免费SSL证书主要特点
在开始申请之前,我们先通过一个表格快速了解 ZeroSSL 免费证书的主要特点:
| 特性 | 说明 |
| :----------- | :----------------------------------------- |
| \*\*证书类型\*\* | 单域名、多域名、通配符(泛域名)、IP证书 |
| \*\*有效期\*\* | 90天 |
| \*\*续期\*\* | 支持免费续期,可手动或通过ACME自动化 |
| \*\*验证方式\*\* | DNS解析、HTTP文件上传、邮箱验证 |
| \*\*自动续期\*\* | 通过ACME工具(如acme.sh)支持 |
\### 📝 在ZeroSSL官网申请免费SSL证书
如果你想通过ZeroSSL官网申请,主要步骤如下图所示:
```mermaid
flowchart TD
A\[访问ZeroSSL官网并注册账号\] --> B\[创建新证书并填写域名\]
B --> C\[选择90天免费证书\]
C --> D\[选择验证方式\]
D --> D1\[DNS验证\]
D --> D2\[HTTP文件验证\]
D --> D3\[邮箱验证\]
D1 --> E\[完成域名所有权验证\]
D2 --> E
D3 --> E
E --> F\[下载证书文件\]
F --> G\[在服务器上安装证书\]
```
下面是各环节的具体操作说明:
1\. \*\*注册ZeroSSL账号\*\*:
\* 访问 ZeroSSL 官网 (\[https://zerossl.com\](https://zerossl.com))。
\* 点击“Get Free SSL”或“Sign Up”注册新账号,通常需要使用邮箱进行注册。
2\. \*\*创建新证书\*\*:
\* 登录后,在控制面板点击“\*\*New Certificate\*\*”。
\* 输入你需要申请证书的\*\*域名\*\*。如果你想为纯IP地址申请SSL证书,也可以在此输入IP地址。
3\. \*\*选择证书类型\*\*:
\* 在证书类型页面,选择“\*\*90-Day Certificate\*\*”(90天证书),这是免费的选项。
4\. \*\*生成CSR(证书签名请求)\*\*:
\* 通常可以选择“\*\*Auto-Generate CSR\*\*”(自动生成CSR),让ZeroSSL为你处理。CSR包含了你的域名和组织信息(如所在地和国家)。
5\. \*\*选择验证方式\*\*:
\* 验证域名所有权是必须的步骤。ZeroSSL主要提供三种方式:
\* \*\*HTTP文件上传验证\*\*:下载验证文件并上传到服务器指定目录,确保可通过HTTP访问。
\* \*\*DNS解析验证\*\*:在域名DNS管理后台添加指定的TXT或CNAME记录。
\* \*\*邮箱验证\*\*:选择域名管理员邮箱(如admin@, webmaster@等),接收验证邮件并点击链接或输入验证码完成验证。这是比较快速和简单的方法。
6\. \*\*完成验证并下载证书\*\*:
\* 验证通过后,状态会更新。点击“\*\*Install Certificate\*\*”即可下载证书文件。
\* 证书通常以ZIP格式提供,包含以下文件:
\* `certificate.crt`:域名证书
\* `ca\_bundle.crt`:中间证书链
\* `private.key`:私钥(请务必安全保管)
\### ⚙️ 在服务器上安装证书
下载证书后,需要将其安装到你的Web服务器上。以Nginx为例:
1\. \*\*上传证书文件\*\*:将下载的证书文件(`certificate.crt`、`ca\_bundle.crt` 和 `private.key`)上传到服务器上的一个目录,例如 `/etc/ssl/your\_domain\_name/`。
2\. \*\*合并证书文件(针对Nginx)\*\*:Nginx需要将 `certificate.crt` 和 `ca\_bundle.crt` 合并为一个文件(例如 `zerossl\_combined.crt`或`fullchain.pem`):
```bash
sudo bash -c 'cat /etc/ssl/your\_domain\_name/certificate.crt /etc/ssl/your\_domain\_name/ca\_bundle.crt >> /etc/ssl/your\_domain\_name/zerossl\_combined.crt'
```
3\. \*\*配置Nginx\*\*:编辑Nginx的虚拟主机配置文件(通常在 `/etc/nginx/sites-available/` 或类似路径),修改SSL相关配置指向你的证书和私钥:
```nginx
server {
listen 443 ssl;
server\_name your\_domain.com www.your\_domain.com;
ssl\_certificate /etc/ssl/your\_domain\_name/zerossl\_combined.crt;
ssl\_certificate\_key /etc/ssl/your\_domain\_name/private.key;
# 其他配置...
}
```
同时,建议配置HTTP到HTTPS的重定向:
```nginx
server {
listen 80;
server\_name your\_domain.com www.your\_domain.com;
return 301 https://$server\_name$request\_uri;
}
```
4\. \*\*重启Nginx\*\*:检查配置是否正确并重启Nginx使更改生效:
```bash
sudo nginx -t # 测试配置
sudo systemctl restart nginx # 重启Nginx
```
\### 🔄 证书续期与管理
ZeroSSL的免费证书有效期为90天,到期前需要续期。
\* \*\*手动续期\*\*:你可以登录ZeroSSL账户,在证书到期前(ZeroSSL会在到期前14天发邮件提醒你)重新进行验证和下载安装。
\* \*\*自动续期(推荐)\*\*:使用支持ACME协议的工具(如\*\*acme.sh\*\*)可以自动化续期过程。
\* \*\*安装acme.sh\*\*:
```bash
curl https://get.acme.sh | sh
source ~/.bashrc
```
\* \*\*设置ZeroSSL为默认CA\*\*并配置EAB凭证(在ZeroSSL控制面板生成):
```bash
acme.sh --set-default-ca --server zerossl
export ZERO\_EAB\_KEY="你的\_eab\_key"
export ZERO\_EAB\_HMAC="你的\_eab\_hmac"
```
\* \*\*颁发证书\*\*(例如使用DNS API自动验证):
```bash
export DP\_Id="你的\_DNS\_API\_ID"
export DP\_Key="你的\_DNS\_API\_Key"
acme.sh --issue --dns dns\_dp -d your\_domain.com -d \*.your\_domain.com
```
\* \*\*安装证书\*\*并配置自动重载Web服务器:
```bash
acme.sh --install-cert -d your\_domain.com \\
\--key-file /etc/ssl/your\_domain.com/private.key \\
\--fullchain-file /etc/ssl/your\_domain.com/fullchain.cer \\
\--reloadcmd "systemctl reload nginx"
```
acme.sh会自动添加cron任务每天检查证书是否需续期。
\### 💎 主要注意事项
\* \*\*免费证书限制\*\*:ZeroSSL的免费计划每个账户通常有\*\*3个免费证书的限制\*\*。
\* \*\*验证方式选择\*\*:
\* \*\*DNS验证\*\*:适合无法直接操作服务器但能管理DNS记录的情况,也是自动化(如acme.sh)的首选。
\* \*\*HTTP验证\*\*:需要能操作Web服务器目录,上传验证文件。
\* \*\*邮箱验证\*\*:相对简单,但需确保能收到指定管理员邮箱的邮件。
\* \*\*私钥安全\*\*:私钥(`.key`文件)务必保密,切勿泄露。
\* \*\*证书链\*\*:配置Web服务器时,确保使用合并后的完整证书链(如Nginx的`zerossl\_combined.crt`),否则可能导致某些浏览器不信任。
\* \*\*IP证书\*\*:ZeroSSL支持为纯IP地址申请SSL证书,这比较少见,验证时通常需选择HTTP文件上传方式。
希望这些详细的步骤能帮助你成功申请和安装ZeroSSL的免费SSL证书。如果你在过程中遇到任何问题,可以查阅ZeroSSL官方文档或帮助中心。
ZeroSSL 是一家提供免费SSL证书的服务商,其免费证书有效期为90天,适合个人博客、小型网站或测试环境使用。下面是在ZeroSSL官网申请免费SSL证书的步骤。
\### 📌 ZeroSSL 免费SSL证书主要特点
在开始申请之前,我们先通过一个表格快速了解 ZeroSSL 免费证书的主要特点:
| 特性 | 说明 |
| :----------- | :----------------------------------------- |
| \*\*证书类型\*\* | 单域名、多域名、通配符(泛域名)、IP证书 |
| \*\*有效期\*\* | 90天 |
| \*\*续期\*\* | 支持免费续期,可手动或通过ACME自动化 |
| \*\*验证方式\*\* | DNS解析、HTTP文件上传、邮箱验证 |
| \*\*自动续期\*\* | 通过ACME工具(如acme.sh)支持 |
\### 📝 在ZeroSSL官网申请免费SSL证书
如果你想通过ZeroSSL官网申请,主要步骤如下图所示:
```mermaid
flowchart TD
A\[访问ZeroSSL官网并注册账号\] --> B\[创建新证书并填写域名\]
B --> C\[选择90天免费证书\]
C --> D\[选择验证方式\]
D --> D1\[DNS验证\]
D --> D2\[HTTP文件验证\]
D --> D3\[邮箱验证\]
D1 --> E\[完成域名所有权验证\]
D2 --> E
D3 --> E
E --> F\[下载证书文件\]
F --> G\[在服务器上安装证书\]
```
下面是各环节的具体操作说明:
1\. \*\*注册ZeroSSL账号\*\*:
\* 访问 ZeroSSL 官网 (\[https://zerossl.com\](https://zerossl.com))。
\* 点击“Get Free SSL”或“Sign Up”注册新账号,通常需要使用邮箱进行注册。
2\. \*\*创建新证书\*\*:
\* 登录后,在控制面板点击“\*\*New Certificate\*\*”。
\* 输入你需要申请证书的\*\*域名\*\*。如果你想为纯IP地址申请SSL证书,也可以在此输入IP地址。
3\. \*\*选择证书类型\*\*:
\* 在证书类型页面,选择“\*\*90-Day Certificate\*\*”(90天证书),这是免费的选项。
4\. \*\*生成CSR(证书签名请求)\*\*:
\* 通常可以选择“\*\*Auto-Generate CSR\*\*”(自动生成CSR),让ZeroSSL为你处理。CSR包含了你的域名和组织信息(如所在地和国家)。
5\. \*\*选择验证方式\*\*:
\* 验证域名所有权是必须的步骤。ZeroSSL主要提供三种方式:
\* \*\*HTTP文件上传验证\*\*:下载验证文件并上传到服务器指定目录,确保可通过HTTP访问。
\* \*\*DNS解析验证\*\*:在域名DNS管理后台添加指定的TXT或CNAME记录。
\* \*\*邮箱验证\*\*:选择域名管理员邮箱(如admin@, webmaster@等),接收验证邮件并点击链接或输入验证码完成验证。这是比较快速和简单的方法。
6\. \*\*完成验证并下载证书\*\*:
\* 验证通过后,状态会更新。点击“\*\*Install Certificate\*\*”即可下载证书文件。
\* 证书通常以ZIP格式提供,包含以下文件:
\* `certificate.crt`:域名证书
\* `ca\_bundle.crt`:中间证书链
\* `private.key`:私钥(请务必安全保管)
\### ⚙️ 在服务器上安装证书
下载证书后,需要将其安装到你的Web服务器上。以Nginx为例:
1\. \*\*上传证书文件\*\*:将下载的证书文件(`certificate.crt`、`ca\_bundle.crt` 和 `private.key`)上传到服务器上的一个目录,例如 `/etc/ssl/your\_domain\_name/`。
2\. \*\*合并证书文件(针对Nginx)\*\*:Nginx需要将 `certificate.crt` 和 `ca\_bundle.crt` 合并为一个文件(例如 `zerossl\_combined.crt`或`fullchain.pem`):
```bash
sudo bash -c 'cat /etc/ssl/your\_domain\_name/certificate.crt /etc/ssl/your\_domain\_name/ca\_bundle.crt >> /etc/ssl/your\_domain\_name/zerossl\_combined.crt'
sudo bash -c 'cat /data/ssl\_lesrec/certificate.crt /data/ssl\_lesrec/ca\_bundle.crt >> /data/ssl\_lesrec/bbs.lesrec.cn.pem'
实测不能合并,会导致pem与key文件md5不同,只要把certificate.crt拷贝为bbs.lesrec.cn.pem即可
验证方法:
openssl rsa -noout -modulus -in /data/ssl\_lesrec/bbs.lesrec.cn.key | openssl md5
openssl x509 -noout -modulus -in /data/ssl\_lesrec/bbs.lesrec.cn.pem | openssl md5
```
3\. \*\*配置Nginx\*\*:编辑Nginx的虚拟主机配置文件(通常在 `/etc/nginx/sites-available/` 或类似路径),修改SSL相关配置指向你的证书和私钥:
```nginx
server {
listen 443 ssl;
server\_name your\_domain.com www.your\_domain.com;
ssl\_certificate /etc/ssl/your\_domain\_name/zerossl\_combined.crt;
ssl\_certificate\_key /etc/ssl/your\_domain\_name/private.key;
# 其他配置...
}
```
同时,建议配置HTTP到HTTPS的重定向:
```nginx
server {
listen 80;
server\_name your\_domain.com www.your\_domain.com;
return 301 https://$server\_name$request\_uri;
}
```
4\. \*\*重启Nginx\*\*:检查配置是否正确并重启Nginx使更改生效:
```bash
sudo nginx -t # 测试配置
sudo systemctl restart nginx # 重启Nginx
```
\### 🔄 证书续期与管理
ZeroSSL的免费证书有效期为90天,到期前需要续期。
\* \*\*手动续期\*\*:你可以登录ZeroSSL账户,在证书到期前(ZeroSSL会在到期前14天发邮件提醒你)重新进行验证和下载安装。
\* \*\*自动续期(推荐)\*\*:使用支持ACME协议的工具(如\*\*acme.sh\*\*)可以自动化续期过程。
\* \*\*安装acme.sh\*\*:
```bash
curl https://get.acme.sh | sh
source ~/.bashrc
```
\* \*\*设置ZeroSSL为默认CA\*\*并配置EAB凭证(在ZeroSSL控制面板生成):
```bash
acme.sh --set-default-ca --server zerossl
export ZERO\_EAB\_KEY="你的\_eab\_key"
export ZERO\_EAB\_HMAC="你的\_eab\_hmac"
```
\* \*\*颁发证书\*\*(例如使用DNS API自动验证):
```bash
export DP\_Id="你的\_DNS\_API\_ID"
export DP\_Key="你的\_DNS\_API\_Key"
acme.sh --issue --dns dns\_dp -d your\_domain.com -d \*.your\_domain.com
```
\* \*\*安装证书\*\*并配置自动重载Web服务器:
```bash
acme.sh --install-cert -d your\_domain.com \\
\--key-file /etc/ssl/your\_domain.com/private.key \\
\--fullchain-file /etc/ssl/your\_domain.com/fullchain.cer \\
\--reloadcmd "systemctl reload nginx"
```
acme.sh会自动添加cron任务每天检查证书是否需续期。
\### 💎 主要注意事项
\* \*\*免费证书限制\*\*:ZeroSSL的免费计划每个账户通常有\*\*3个免费证书的限制\*\*。
\* \*\*验证方式选择\*\*:
\* \*\*DNS验证\*\*:适合无法直接操作服务器但能管理DNS记录的情况,也是自动化(如acme.sh)的首选。
\* \*\*HTTP验证\*\*:需要能操作Web服务器目录,上传验证文件。
\* \*\*邮箱验证\*\*:相对简单,但需确保能收到指定管理员邮箱的邮件。
\* \*\*私钥安全\*\*:私钥(`.key`文件)务必保密,切勿泄露。
\* \*\*证书链\*\*:配置Web服务器时,确保使用合并后的完整证书链(如Nginx的`zerossl\_combined.crt`),否则可能导致某些浏览器不信任。
\* \*\*IP证书\*\*:ZeroSSL支持为纯IP地址申请SSL证书,这比较少见,验证时通常需选择HTTP文件上传方式。
希望这些详细的步骤能帮助你成功申请和安装ZeroSSL的免费SSL证书。如果你在过程中遇到任何问题,可以查阅ZeroSSL官方文档或帮助中心。
# Windows Server 2022 下用命令行删除整个 E 盘(RAID5 动态卷)
你要在 **Windows Server 2022** 下用命令行删除整个 **E 盘(RAID5 动态卷)**,可以通过 **diskpart** 工具来完成。下面是完整步骤(⚠️危险操作,执行前确认数据已备份):
---
### 1. 打开命令行
以 **管理员身份** 打开 **命令提示符 (cmd)** 或 **PowerShell**。
---
### 2. 启动 `diskpart`
```cmd
diskpart
```
---
### 3. 查看卷列表
```cmd
list volume
```
找到 `E:` 所对应的卷号(比如 `Volume 3`)。
---
### 4. 选择该卷
```cmd
select volume 3
```
(这里 `3` 替换成实际的卷号)
---
### 5. 删除卷
```cmd
delete volume
```
这样会删除 **E 盘卷**,卷号将消失。
---
### ⚠️ 特殊情况:如果是动态磁盘的 RAID5
- Windows 的 **软件 RAID5** 是建立在动态磁盘上的。
- 删除卷时可能需要先 **删除虚拟磁盘**(RAID5 卷),否则只会删除盘符,底层动态磁盘结构还在。
如果 `delete volume` 提示失败,可以用以下步骤:
```cmd
list disk
select disk X (选择动态磁盘)
detail disk (确认有 RAID5 卷信息)
delete volume (删除对应卷)
```
---
### 6. 退出
```cmd
exit
```
---
✅ **注意事项:**
- 这会 **彻底删除 RAID5 卷**,数据不可恢复。
- 如果 RAID5 是 **硬件阵列卡创建的阵列**,需要在 **RAID 控制卡 BIOS 或管理工具(如 MegaCli、HP Smart Array、Dell OMSA)** 中删除阵列,而不是在 Windows 内删除。
---
要帮你区分一下吗:你的 **E 盘 RAID5** 是 **Windows 动态磁盘软件阵列** 还是 **RAID 控制卡硬件阵列**?
在 **Windows Server 2022** 上,可以使用 **diskpart** 命令行工具来对新硬盘进行 **分区、格式化、分配盘符**。下面给你完整的标准流程(假设你要操作的是一块新硬盘):
---
## 操作步骤
### 1. 打开命令行
以 **管理员身份** 打开 PowerShell 或 CMD,然后输入:
```cmd
diskpart
```
---
### 2. 查看所有磁盘
```cmd
list disk
```
你会看到类似:
```
Disk ### Status Size Free Dyn Gpt
-------- ---------- ------- ------- --- ---
Disk 0 Online 100 GB 0 B
Disk 1 Online 500 GB 500 GB
```
假设要操作的是 `Disk 1`。
---
### 3. 选择硬盘
```cmd
select disk 1
```
---
### 4. 清除硬盘(可选)
如果是新硬盘,建议清理一下:
```cmd
clean
```
⚠️ **注意:这会清空硬盘上的所有数据!**
---
### 5. 转换分区表(可选)
- 如果是大于 2TB 的硬盘,建议使用 GPT:
```cmd
convert gpt
```
- 小于 2TB 也可以使用 MBR:
```cmd
convert mbr
```
---
### 6. 创建分区
例如创建一个占满磁盘的主分区:
```cmd
create partition primary
```
如果只想创建指定大小的分区(比如 100GB):
```cmd
create partition primary size=102400
```
(单位是 MB)
---
### 7. 格式化分区
格式化为 NTFS 并快速格式化:
```cmd
format fs=ntfs quick label=Data
```
如果想用 ReFS(Server 2022 支持),可以:
```cmd
format fs=refs quick label=Data
```
---
### 8. 分配盘符
比如分配为 `E:`:
```cmd
assign letter=E
```
---
### 9. 退出
```cmd
exit
```
---
## 最终结果
此时 `E:` 就是一个新的分区,可以在资源管理器中使用了。
---
要不要我帮你写一个 **一键批处理脚本**(比如自动选择 `Disk 1` → 清理 → GPT → 创建分区 → 格式化 → 分配盘符),这样你直接运行就能完成全流程?
# win server 2025 部署PPTP VPN教程
好的 👍 我来帮你梳理 **Windows Server 2025 自带 PPTP VPN 部署过程**。
(⚠️ 注意:PPTP 协议已经比较老,不推荐在生产环境用来对外暴露,因为加密较弱,安全性差。如果只是内部环境或者临时需求,可以使用。)
---
## 1. 安装远程访问服务(RRAS)
1. 打开 **服务器管理器** → 点击 **添加角色和功能**。
2. 在 **基于角色的安装** 中选择本机服务器。
3. 在角色中勾选:
- **远程访问**
4. 继续下一步,在功能中默认即可。
5. 在 **角色服务** 选择:
- **DirectAccess 和 VPN(RAS)**
- (可选)**路由**
6. 完成安装并重启。
---
## 2. 配置 RRAS 以启用 PPTP VPN
1. 打开 **服务器管理器** → **工具** → **路由和远程访问**。
2. 右键服务器名称 → 选择 **配置并启用路由和远程访问**。
3. 选择 **自定义配置** → 勾选 **VPN 访问**(可选勾路由)。
4. 完成后启动服务。
---
## 3. 配置 PPTP 协议
1. 在 RRAS 控制台 → 展开服务器 → 右键 **端口** → 属性。
2. 找到 **WAN Miniport (PPTP)** → 点击配置 → 勾选 **启用 VPN 访问**,设置允许的并发连接数(如 10)。
3. 点击确定保存。
---
## 4. 配置用户 VPN 权限
1. 打开 **计算机管理** → **本地用户和组** → 用户。
2. 新建或选择一个用户 → 右键属性 → **拨入** → 勾选 **允许访问**。
---
## 5. 配置防火墙与端口转发
- 确认服务器 **防火墙允许 1723/TCP**(PPTP 端口)。
- 同时,PPTP 还需要 **GRE 协议(协议号 47)**。
- 如果服务器后面有路由器或防火墙,要确保 GRE 协议能通过。
---
## 6. 客户端连接
- Windows 客户端 → 打开 **VPN 设置** → 新建 VPN 连接:
- 服务器地址:填写 Win Server 2025 的公网 IP / 域名。
- VPN 类型:PPTP。
- 用户名 / 密码:就是刚才启用拨入权限的账号。
- 保存后连接即可。
---
## 7. 验证
在服务器上可以用命令行查看 RRAS 状态:
```powershell
Get-Service RemoteAccess
```
查看当前 VPN 会话:
```powershell
netsh ras show connections
```
---
⚠️ 再次提醒:PPTP **仅适合测试 / 内网使用**,如果你要放到公网,建议用 **L2TP/IPsec 或 OpenVPN/WireGuard** 替代。
要不要我帮你写一个 **更安全的 L2TP/IPsec(Windows Server 2025 自带)部署步骤**,可以和 AD 或普通账号配合?
# Windows Server 2025 RRAS + L2TP/IPsec + AD 域认证 部署指南
好的 👍 我来帮你整理一份 **Windows Server 2025 上 RRAS + L2TP/IPsec + AD 域认证的完整部署步骤**。
这个方案是微软官方推荐的比 PPTP 更安全的 VPN 方式,并且可以直接用 **AD 域用户账号密码**进行认证。
---
# 🔧 Windows Server 2025 RRAS + L2TP/IPsec + AD 域认证 部署指南
## 1️⃣ 前置条件
1. 已经有 **AD 域控制器**(例如 `ad.example.com`)。
2. VPN 服务器(Windows Server 2025,建议已加入 AD 域)。
3. 一张公网 IP(供外网用户访问 VPN)。
4. 一个合格的 **服务器证书**(VPN 服务器需要证书,推荐用企业内部 CA 或公网 CA)。
---
## 2️⃣ 安装角色和功能
在 VPN 服务器上执行:
1. 打开 **Server Manager** → `Add Roles and Features`。
2. 选择:
- **Remote Access** 角色
- 勾选 **DirectAccess and VPN (RAS)**
- 自动勾选 **Routing**
3. 安装完成后,不要关闭向导,选择 **Open the Getting Started Wizard**。
---
## 3️⃣ 配置 RRAS(启用 VPN)
1. 打开 **Server Manager → Tools → Routing and Remote Access**。
2. 右键服务器名 → `Configure and Enable Routing and Remote Access`。
3. 选择 **Custom configuration** → 勾选 **VPN access**。
4. 完成后启动 RRAS 服务。
---
## 4️⃣ 配置 L2TP/IPsec
1. 在 RRAS 管理器中,右键服务器 → 属性:
- **Security** 标签页 → 选中 **Allow custom IPsec policy for L2TP connections**。
- 输入一个 **预共享密钥(Pre-Shared Key,PSK)**,例如:`MySecureKey@2025`。
2. (推荐做法)如果你有证书:
- 在 **RRAS → Properties → Security → SSL Certificate Binding** 里选择服务器证书(而不是 PSK)。
---
## 5️⃣ 配置 NPS(与 AD 集成)
1. 打开 **Server Manager → Tools → Network Policy Server (NPS)**。
2. 在左侧导航栏选择 **RADIUS Clients and Servers → RADIUS Clients** → 新建:
- Name: `RRAS-VPN`
- Address: `127.0.0.1` 或 VPN 服务器 IP
- Shared secret: 随便设置(RRAS 会用到)。
3. 在 **Policies → Network Policies** 新建策略:
- 名称:`VPN Access`
- 条件:`Windows Groups` → 添加一个 AD 用户组(比如 `VPN_Users`)。
- 权限:**Access Granted**。
- 认证方式:启用 **MS-CHAPv2**(默认即可)。
---
## 6️⃣ 在 RRAS 中绑定 NPS
1. 在 **RRAS 管理器**,右键服务器 → 属性。
2. **Security → Authentication provider**,选择 **RADIUS Authentication**。
3. 添加本机的 NPS 服务器:
- Address:`127.0.0.1`
- Shared secret:和上一步设置的一致。
---
## 7️⃣ 配置防火墙
在 VPN 服务器上放行以下端口:
- UDP 500(IKE)
- UDP 4500(NAT-T)
- UDP 1701(L2TP)
- TCP 443(如果未来考虑 SSTP)
同时确保公网 IP 已正确映射到该服务器。
---
## 8️⃣ 客户端连接(Windows 10/11)
1. 打开 **设置 → 网络和 Internet → VPN → 添加 VPN**。
2. 填写:
- VPN 提供程序:Windows (内置)
- 连接名称:随意(如 `CompanyVPN`)
- 服务器名称/IP:公网 IP 或 FQDN(如 `vpn.example.com`)
- VPN 类型:L2TP/IPsec with pre-shared key
- 预共享密钥:输入服务器上配置的 PSK(如 `MySecureKey@2025`)
- 登录方式:用户名和密码(AD 域账号,如 `user1` / `Password`)
3. 保存后点击连接。
---
## 9️⃣ 验证
在客户端输入 AD 域用户的账号/密码,成功连上 VPN 后,可以 `ping 内网服务器` 或访问共享资源来确认连通性。
---
# 📌 总结
- **安全性**:比 PPTP 高很多,支持加密和 AD 域账号统一认证。
- **运维便利**:账号密码直接走域控,不需要单独维护 VPN 用户。
- **扩展**:后续可以升级到 **Always On VPN (AOVPN)**,体验更接近内网域机。
---
要不要我帮你再整理一份 **Always On VPN(AOVPN)+ AD 域认证** 的部署方案?这个是微软最新一代 VPN,比 L2TP 更安全、更现代化。
# 在 Windows Server 2025 上部署 PPTP VPN
明白 ✅
你想在 **Windows Server 2025** 上部署 **PPTP VPN**。
虽然微软官方在 Windows Server 2012 R2 之后就一直强调不要再用 PPTP(因为安全性较差,推荐 L2TP/IPsec 或 SSTP),但如果你是做兼容性或临时方案,还是可以部署。
下面给你一个完整的 **Windows Server 2025 PPTP VPN 部署指南**:
---
## 🔹 一、准备工作
1. 已安装 **Windows Server 2025**(Datacenter / Standard)。
2. 配置好公网 IP 或能通过 NAT 转发 TCP 1723 和 GRE 协议(协议号 47)。
3. 确保已加入域(可选,如果需要 AD 账号认证)。
4. 管理员权限。
---
## 🔹 二、安装远程访问角色
1. 打开 **服务器管理器** → **添加角色和功能**。
2. 在角色里选择:
- **远程访问 (Remote Access)**
3. 在角色服务中勾选:
- **DirectAccess 和 VPN (RAS)**
- **路由 (Routing)**
4. 完成安装后,不要重启(系统可能会提示)。
---
## 🔹 三、配置 RRAS(Routing and Remote Access Service)
1. 打开 **服务器管理器** → **工具** → **路由和远程访问**。
2. 在左侧选择本机 → 右键 → **配置并启用路由和远程访问**。
3. 向导中选择:
- **自定义配置**
- 勾选 **VPN 访问** 和(如需要)**NAT**。
4. 完成后,点击 **启动服务**。
---
## 🔹 四、启用 PPTP
1. 在 RRAS 控制台,右键服务器 → 属性。
2. 切换到 **安全性** → **身份验证方法**,勾选:
- **MS-CHAP v2**(建议只启用这个,避免 PAP/CHAP)。
3. 切换到 **IPv4**:
- 选择 **静态地址池**,添加一个地址段(例如 192.168.100.100–192.168.100.200)。
- 或选择 DHCP(如果有现成 DHCP 服务器)。
4. 切换到 **VPN**:
- 确认 **允许的 VPN 协议** 里勾选了 **PPTP**。
---
## 🔹 五、防火墙 & 端口
在防火墙(本机或边界防火墙)放行:
- **TCP 1723**(PPTP 控制通道)
- **GRE 协议 (Protocol 47)**(数据通道,不是 TCP/UDP 端口)
检查命令:
```powershell
netsh advfirewall firewall add rule name="PPTP-1723" protocol=TCP dir=in localport=1723 action=allow
netsh advfirewall firewall add rule name="PPTP-GRE" protocol=47 dir=in action=allow
```
---
## 🔹 六、用户配置
1. 打开 **计算机管理** → **本地用户和组** → 用户。
2. 新建或选择用户 → 右键属性 → **拨入**。
3. 选择 **允许访问**。
如果是域用户,可以在 ADUC 中同样设置。
---
## 🔹 七、客户端连接
- Windows 10/11/Server 客户端:
- 打开 VPN 设置 → 添加 VPN → 类型选 PPTP → 输入服务器公网地址 + 用户名密码。
---
## 🔹 八、验证
在服务端可以用以下命令查看 VPN 连接:
```powershell
Get-RemoteAccessConnectionStatistics
```
---
⚠️ **安全提醒**
PPTP 已知有弱点(MS-CHAPv2 可被暴力破解)。如果是生产环境,建议用 **L2TP/IPsec** 或 **IKEv2**。
---
要不要我帮你整理一份 **同时支持 PPTP + L2TP/IPsec 的部署方案**,这样你兼容老客户端的同时也能提供安全的接入?
# OpenVPN + AD 域账号集成部署教程
👌 好的,你想要 **OpenVPN + AD 域账号集成**的完整部署方案。
下面我给你整理一个基于 **Windows Server 2025 + AD 域**的 OpenVPN 部署教程(也可放在 Linux 上,方法类似)。
---
# 🛠 OpenVPN + AD 域账号集成部署教程
## 一、准备工作
1. 一台 **Windows Server 2025**(可作为 VPN Server)。
- 建议安装在 **非 DC 服务器** 上,避免和 AD 冲突。
- 如果你愿意,也可以用 Linux(CentOS/Ubuntu)作为 VPN Server,思路一样。
2. 已有 **AD 域环境**(例如 `shuncom.local`)。
3. 域用户账号若干(VPN 登录将使用 AD 账号)。
4. 公网 IP 或 NAT 映射端口。
---
## 二、安装 OpenVPN Server
1. 下载 OpenVPN 社区版(免费):
👉 [https://openvpn.net/community-downloads/](https://openvpn.net/community-downloads/)
2. 安装时勾选:
- **EasyRSA**(用于证书生成)
- **OpenVPN Service**(安装为服务)
3. 确认 Windows 防火墙放行:
- **UDP 1194**(默认 OpenVPN 端口)
- 或你自定义的端口
---
## 三、生成证书(CA、Server、Client)
在 `C:\Program Files\OpenVPN\easy-rsa` 下执行:
```powershell
# 初始化 CA
EasyRSA-Start.bat
./easyrsa init-pki
./easyrsa build-ca
# 生成服务器证书
./easyrsa build-server-full server nopass
# 生成客户端证书(例如 user01)
./easyrsa build-client-full user01 nopass
```
证书会在 `pki` 目录生成,复制到 `C:\Program Files\OpenVPN\config`。
---
## 四、配置 OpenVPN 服务端
在 `C:\Program Files\OpenVPN\config\server.ovpn` 添加:
```conf
port 1194
proto udp
dev tun
ca ca.crt
cert server.crt
key server.key
dh dh.pem
server 10.8.0.0 255.255.255.0
ifconfig-pool-persist ipp.txt
push "redirect-gateway def1"
push "dhcp-option DNS 192.168.1.10" # 你的域控/DNS 服务器 IP
keepalive 10 120
cipher AES-256-GCM
auth SHA256
persist-key
persist-tun
verb 3
# 启用 AD 认证
plugin "C:\\Program Files\\OpenVPN\\lib\\openvpn-auth-ldap.dll" "C:\\Program Files\\OpenVPN\\config\\auth-ldap.conf"
```
---
## 五、配置 AD 认证插件
在 `C:\Program Files\OpenVPN\config\auth-ldap.conf` 写入:
```conf
URL ldap://192.168.1.10:389
BindDN CN=vpnbind,OU=ServiceAccounts,DC=shuncom,DC=local
Password YourBindPassword
Timeout 15
FollowReferrals yes
BaseDN "OU=Users,DC=shuncom,DC=local"
SearchFilter "(sAMAccountName=%u)"
RequireGroup false
```
📌 说明:
- `BindDN`:一个有只读权限的域账号(建议新建 vpnbind 专用用户)。
- `BaseDN`:搜索用户的路径,可以指定 OU。
- `SearchFilter`:匹配域用户登录名。
---
## 六、启动 OpenVPN 服务
```powershell
services.msc
```
找到 **OpenVPNService** → 启动。
也可用命令行:
```powershell
net start openvpnservice
```
---
## 七、配置客户端
在客户端(Windows/Linux/Mac)导入 `user01.ovpn`:
```conf
client
dev tun
proto udp
remote vpn.shuncom.org 1194
resolv-retry infinite
nobind
persist-key
persist-tun
ca ca.crt
cert user01.crt
key user01.key
auth-user-pass
cipher AES-256-GCM
auth SHA256
verb 3
```
首次连接会提示输入 **AD 域账号 + 密码**。
---
## 八、验证
在服务端执行:
```powershell
"C:\Program Files\OpenVPN\bin\openvpn.exe" --show-status
```
或查看日志 `C:\Program Files\OpenVPN\log\server.log`。
正常时应能看到:
```
LDAP: User user01 authenticated.
```
---
## 九、加固建议
1. **启用 MFA**(可配合 AD FS + Azure MFA 或 Duo)。
2. 只允许 VPN 用户组成员访问 → 在 `auth-ldap.conf` 里启用 `RequireGroup true`。
3. 考虑使用 **IKEv2 或 WireGuard** 替代 OpenVPN,性能更好。
---
要不要我帮你写一份 **auth-ldap.conf 示例(带指定 AD 安全组控制 VPN 登录权限)**?这样你可以限制只有某个 AD 组的成员才能连 VPN。
# 排查ping不通AD域名思路与过程
你这个情况很典型:**能够 ping 通 AD 域控制器的 IP,也能解析出 DNS 服务器,但 ping 域名却失败**。分析如下:
---
### 1️⃣ nslookup vs ping 的差异
- 你 `nslookup shuncom.local` 返回空:
```
名称: shuncom.local
```
没有解析出具体 IP,这说明 DNS 正常响应,但 **AD 域名本身可能没有 A 记录**。
- `ping shuncom.local` 失败,因为 Windows ping 依赖 **A/AAAA 记录**:
- 如果 DNS 中只存在 NS、SOA 或 SRV 记录,没有 A/AAAA,ping 会失败。
- AD 域名通常只有 SRV 记录(例如 `_ldap._tcp.shuncom.local`),而不是直接给 `shuncom.local` 配置 A 记录。
---
### 2️⃣ 检查 DNS 记录
在 DNS 服务器上运行:
```powershell
nslookup
> set type=A
> shuncom.local
```
- 如果没有返回 IP,就说明没有 A 记录。
- AD 域控制器一般是通过 **域控制器主机名 + SRV 记录** 来定位的,ping 根域名通常不通。
---
### 3️⃣ Windows 客户端配置
- 确保客户端 DNS 设置指向 **AD 域控制器 IP**(你已经是 192.168.0.5)。
- 测试域控制器主机名:
```cmd
ping S-DNS6.shuncom.local
```
如果能 ping 通,说明网络和 DNS 基本没问题。
- 测试服务定位:
```cmd
nslookup -type=SRV _ldap._tcp.shuncom.local
```
能返回 DC 的记录就说明 AD 正常。
---
### 4️⃣ 结论
- **ping shuncom.local 不通属于正常现象**,因为 AD 根域名通常没有 A 记录。
- 正确的做法是:
- ping 域控制器主机名(例如 `S-DNS6.shuncom.local`)
- 确认 AD 服务可以正常访问(`netdiag`, `dcdiag`, `nslookup -type=SRV`)
---
💡 建议:
如果你想让 `ping shuncom.local` 成功,可以在 DNS 上手动创建一个 A 记录:
| Name | Type | IP |
|---|
| shuncom.local | A | 192.168.0.5 |
这样根域名就能 ping 通了,但**不是必需的**,不会影响 AD 认证或域登录。
---
我可以帮你写一条命令,快速在 Windows DNS 或 Ubuntu 上验证根域名是否有 A 记录,并创建它。你希望我写吗?
根据你提供的 `nslookup -type=SRV _ldap._tcp.shuncom.local` 输出,可以确认:
- **AD 域控制器 SRV 记录正常**,客户端可以找到 DC 并通过 LDAP 访问。
- `s-dns6.shuncom.local` 和 `s-dns9.shuncom.local` 都有 A 记录(192.168.0.5 / 192.168.0.6),所以 DC 本身可以访问。
- **根域名 `shuncom.local` 没有 A 记录**,所以 `ping shuncom.local` 失败是正常现象。
---
### 🔹 原因总结
1. Windows ping 根域名需要 **A/AAAA 记录**。
2. AD 域默认只在 DNS 中创建:
- `_ldap._tcp.` SRV 记录
- `hostname.domain` A 记录(即 DC 主机名有 A 记录)
3. 根域名本身(`shuncom.local`)通常没有绑定 IP,因此 ping 不通。
---
### 🔹 验证方法
你可以尝试 ping 域控制器主机名:
```cmd
ping s-dns6.shuncom.local
ping s-dns9.shuncom.local
```
应该可以通。
你也可以测试 LDAP 连接:
```cmd
nltest /dsgetdc:shuncom.local
```
这会返回可用域控制器。
---
### 🔹 可选方案(非必须)
如果你真的希望 `ping shuncom.local` 通,可以在 DNS 服务器上手动添加一个 A 记录:
| 名称 | 类型 | IP 地址 |
|---|
| shuncom.local | A | 192.168.0.5 |
⚠️ 注意:这只是为了 ping 通根域名,不影响 AD 域功能。
---
如果你需要,我可以给你写一个 **在 Windows DNS 上添加根域名 A 记录的操作步骤**,安全且快速。你希望我写吗?
# 将AD域由2022提升为2025部署过程
## 一、192.168.0.4这台win2025 域主机提升为辅助域控
- 当前主域控:**192.168.0.5**(Windows Server 2022)
- 新服务器:**192.168.0.4**(Windows Server 2025),已经加入域,但还不是域控制器
- 目标:将 0.4 提升为 **辅助域控(Additional Domain Controller, ADC)**
下面是详细步骤:
---
## **1.1:检查前提条件**
1. 确保 192.168.0.4 能够解析主域控的 DNS:
```powershell
nslookup shuncom.local
nslookup s-dns6.shuncom.local
```
2. 确保 0.4 与 0.5 网络互通,端口 135、389、636、3268、3269、445 等开放(域控所需端口)。
3. 确保 0.5 上的 Active Directory 状态正常:
```powershell
dcdiag /v /c /e
repadmin /showrepl
```
4. 确保 0.4 的计算机名正确,建议使用 **简短且唯一的主机名**,不要和现有 DC 冲突。
---
## **1. 2:在 192.168.0.4 安装 AD DS 角色**
1. 打开 PowerShell(管理员):
```powershell
Install-WindowsFeature AD-Domain-Services -IncludeManagementTools
```
2. 安装完成后,会提示需要 **配置域控制器**。
---
## **1. 3:使用 `AD DS 配置向导` 提升为辅助域控**
1. 在 192.168.0.4 打开 **服务器管理器 → AD DS → 更多操作 → 将此服务器提升为域控制器**。
2. 选择 **添加到现有域**:
- 域名:`shuncom.local`
- 凭据:使用 **域管理员账户**(如 )
3. 选择 **域控制器选项**:
- **DNS 服务器**(建议勾选)
- **全局目录(GC)**(建议勾选)
- 不要勾选 “只读域控制器(RODC)”,除非需要只读模式
4. 指定 **AD DS 数据库、日志和 SYSVOL 的路径**(默认即可或根据公司策略调整)
5. 输入 **安全还原模式密码(DSRM)**
6. 系统会检查前置条件,如果一切正常,点击 **安装**。
> 安装完成后,服务器会自动重启。
---
## **1. 4:检查提升是否成功**
1. 查看 0.4 是否成为域控:
```powershell
Get-ADDomainController -Filter * | ft Name,IPv4Address,IsGlobalCatalog,Domain,Site
```
2. 检查复制状态:
```powershell
repadmin /showrepl
dcdiag /v /c /e
```
3. 检查 DNS:
```powershell
nslookup
set type=SRV
_ldap._tcp.dc._msdcs.shuncom.local
```
4. 确认 FSMO 角色还在 0.5:
```powershell
netdom query fsmo
```
---
## **1. 5:同步完成后再考虑主域控迁移**
- 0.4 成功成为辅助域控后,FSMO 角色仍在 0.5。
- 之后才可以按照你之前计划,把 0.4 提升为主域控(迁移 FSMO、调整 IP 等)。
---
## 二、 **把 192.168.0.6 这台 Windows Server 2022 域控制器 (辅助域控) 降级退出域**
---
# 2.1、准备工作
1. **确认它是辅助域控**
在任意一台 DC 上执行:
```powershell
netdom query fsmo
```
确认 192.168.0.6 没有持有 FSMO 角色(如果有,要先把 FSMO 角色转移到其他域控)。
2. **确认复制正常**
在 192.168.0.6 上执行:
```powershell
dcdiag /v
repadmin /showrepl
```
确认没有严重错误,避免 AD 数据不一致。
---
# 2.2、降级 192.168.0.6 域控
有 **图形界面** 和 **PowerShell** 两种方式:
### 方法一:图形界面(Server Manager)
1. 登录 192.168.0.6,打开 **Server Manager**。
2. 选择 **Manage → Remove Roles and Features**。
3. 找到 **Active Directory Domain Services (AD DS)**,取消勾选。
4. 系统会提示“降级域控制器 (Demote this domain controller)”,点击进入向导。
5. 在向导里:
- **不要勾选 “This domain controller is the last domain controller in the domain”**(因为还有其他 DC)。
- 输入 DSRM 密码。
6. 完成后系统会自动重启,192.168.0.6 将从 DC 降级为域成员服务器。
---
### 方法二:PowerShell(推荐,简洁)
在 192.168.0.6 上以管理员身份运行 PowerShell:
```powershell
# 安全降级域控
Uninstall-ADDSDomainController `
-DemoteOperationMasterRole:$false `
-RemoveApplicationPartitions `
-Credential (Get-Credential) `
-ForceRemoval:$false `
-LocalAdministratorPassword (ConvertTo-SecureString "YourLocalAdminPassw0rd!" -AsPlainText -Force) `
-Force
```
参数说明:
- `-Credential`:输入有域管理员权限的账号。
- `-LocalAdministratorPassword`:降级后本机会变成本地成员服务器,这里设置本地管理员密码。
- `-ForceRemoval:$false`:正常情况下不强制,保持数据复制一致。
降级完成后,192.168.0.6 会自动重启,回到域成员身份。
---
# 2.3、降级后清理工作
1. **确认 AD 里不再有旧 DC 对象**
在任意剩余 DC 上打开 **Active Directory Users and Computers (ADUC)**,展开 **Domain Controllers**,确认 192.168.0.6 不在里面。
2. **确认 DNS 记录清理**
打开 DNS 管理器,清理 192.168.0.6 的 A 记录、SRV 记录(\_msdcs 子域下)。
3. **检查复制健康**
在主域控上执行:
```powershell
repadmin /replsummary
dcdiag /v
```
确认没有报错。
---
✅ 最终效果:
- 192.168.0.6 从 DC 降级 → 成为域成员服务器(还在域内)。
- 如果你希望它 **完全退出域**,可以再执行:
```powershell
Remove-Computer -UnjoinDomainCredential (Get-Credential) -Verbose -Restart
```
这样它就退出域,成为独立的工作组服务器。
---
## 三、把192.168.0.4 win2025辅助域控提升为主域控
好的 👍,我给你整理一个 **FSMO 角色迁移完整操作手册**,分 **GUI** 和 **PowerShell** 两种方式,适合 Windows Server 2022 域控环境。
---
# 🎯 FSMO 角色迁移完整步骤(Windows Server 2022)
## 3.1、准备工作
1. 确认源域控和目标域控 **均为可用状态**,并且已经同步 Active Directory。
- 可以运行:
```powershell
repadmin /replsummary
```
确认没有严重的复制错误。
2. 确认你登录的账户有 **Enterprise Admins** 或 **Domain Admins** 权限。
3. 确认目标服务器(如 `s-dns1.shuncom.local`)是健康的域控,并且运行正常的 DNS。
---
## 3.2、GUI 方式迁移 FSMO 角色
FSMO 一共有 5 个角色,分两类工具来迁移:
### 1. Schema Master(架构主机)
- 默认不显示,需要先注册 **schmmgmt.dll**:
```powershell
regsvr32 schmmgmt.dll
```
- 打开 **MMC(Microsoft 管理控制台)**:
- Win+R → `mmc`
- 文件 → 添加/删除管理单元 → 添加 **Active Directory Schema**
- 右键 **Active Directory Schema** → **更改 Active Directory 域控制器** → 选择目标 DC(`s-dns1.shuncom.local`)。
- 再右键 **Active Directory Schema** → **操作主机** → 点击 **更改**。
---
### 2. Domain Naming Master(域命名主机)
- 打开 **Active Directory Domains and Trusts(域和信任)**
- 右键顶层节点 → **更改 Active Directory 域控制器** → 选择目标 DC。
- 再右键顶层节点 → **操作主机** → 点击 **更改**。
---
### 3. RID Master / PDC Emulator / Infrastructure Master
- 打开 **Active Directory Users and Computers(用户和计算机)**
- 右键顶层节点 → **更改 Active Directory 域控制器** → 选择目标 DC。
- 再右键顶层节点 → **操作主机** → 在弹出窗口中可切换 3 个角色(RID、PDC、Infrastructure)。
---
## 3.3、PowerShell 方式迁移 FSMO 角色
1. 在目标域控(或能远程管理的管理机上)打开 **Windows PowerShell(管理员权限)**。
2. 查看当前 FSMO 角色分布:
```powershell
netdom query fsmo
```
3. 执行迁移命令(示例迁移到 `s-dns1.shuncom.local`):
```powershell
Move-ADDirectoryServerOperationMasterRole -Identity "s-dns1.shuncom.local" -OperationMasterRole 0,1,2,3,4 -Confirm:$false
```
- 其中参数说明:
- `0` = PDC Emulator
- `1` = RID Master
- `2` = Infrastructure Master
- `3` = Schema Master
- `4` = Domain Naming Master
也可以写成:
```powershell
Move-ADDirectoryServerOperationMasterRole -Identity "s-dns1.shuncom.local" -OperationMasterRole SchemaMaster, DomainNamingMaster, PDCEmulator, RIDMaster, InfrastructureMaster -Confirm:$false
```
4. 验证迁移是否成功:
```powershell
netdom query fsmo
```
确认 5 个角色都在 `s-dns1.shuncom.local` 上。
---
## 3.4、注意事项
- **迁移 (Move)** 和 **强制夺取 (Seize)** 区别:
- 如果原 FSMO 角色持有者 **在线**,建议用 **Move**(正常迁移)。
- 如果原 FSMO 服务器永久损坏,必须用 **Seize**(强制夺取,命令不同)。
- FSMO 角色不能同时存在于两个 DC 上,迁移完成后会唯一存在于目标 DC。
- 建议迁移后,重启目标域控一次,确保 FSMO 服务稳定。
---
要不要我再帮你写一个 **Seize FSMO(强制夺取角色)** 的完整步骤?这样万一旧域控挂掉了,你也能处理。
## **四、互换两台域控的 IP 地址**:
1. 成功将 **FSMO(五大主域角色)** 全部迁移到了 `S-DNS1.shuncom.local`;
2. 然后准备 **互换两台域控的 IP 地址**(即把 `192.168.0.4` ↔ `192.168.0.5` 互换)。
这是可行的操作,但 **AD 与 DNS 对 IP 强依赖**,直接改 IP 后若不做同步修复,可能会导致:
- 域控之间复制中断;
- DNS 记录失效;
- Kerberos 验证失败;
- 客户端无法登录域。
---
## ✅ 一、你当前状态
从输出可见:
```
FSMO 全部在 S-DNS1.shuncom.local(192.168.0.5)
nslookup 显示:
shuncom.local -> 192.168.0.4 和 192.168.0.5
```
这说明目前两个域控(S-DNS1 与 S-DNS6)均在 DNS 中,解析没问题。
接下来你要**交换两台服务器的 IP 地址**。
---
## ✅ 二、换 IP 前必须确认的事项
在更改 IP 之前,请务必:
1. **记下两台 DC 的名称与对应 IP:**
```
S-DNS1 → 192.168.0.5(FSMO持有者)
S-DNS6 → 192.168.0.4(辅助DC)
```
2. **确保两台域控都能访问彼此的主机名:**
```powershell
ping S-DNS1.shuncom.local
ping S-DNS6.shuncom.local
```
3. **确保 DNS 使用静态地址**,且每台 DC 都指向:
- 首选 DNS:对方 DC
- 备用 DNS:自身
举例:
```
S-DNS1:
首选DNS:192.168.0.4
备用DNS:192.168.0.5
S-DNS6:
首选DNS:192.168.0.5
备用DNS:192.168.0.4
```
---
## ✅ 三、交换 IP 的正确步骤
### 步骤 1:暂停复制
在任一 DC 上执行:
```powershell
repadmin /options S-DNS1 +DISABLE_OUTBOUND_REPL
repadmin /options S-DNS6 +DISABLE_OUTBOUND_REPL
```
防止在切换过程中产生复制错误。
---
### 步骤 2:修改两台服务器的 IP 地址
在系统层面分别修改:
#### S-DNS1:
- 改为 **192.168.0.4**
- 同时更新 DNS 地址配置
#### S-DNS6:
- 改为 **192.168.0.5**
- 同步更新 DNS 地址配置
---
### 步骤 3:更新 DNS 记录
1. 打开 DNS 管理控制台;
2. 删除旧 IP 对应的 A 记录;
3. 确认新 IP 已自动注册;
- 若未自动更新,可运行:
```powershell
ipconfig /registerdns
```
- 或手动添加:
- `S-DNS1` → 192.168.0.4
- `S-DNS6` → 192.168.0.5
4. 检查 `_msdcs.shuncom.local` 中的所有 SRV 记录是否都指向正确 IP:
- `_ldap._tcp.dc._msdcs.shuncom.local`
- `_kerberos._tcp.dc._msdcs.shuncom.local`
---
### 步骤 4:验证 AD 复制功能
执行:
```powershell
repadmin /syncall /AdeP
repadmin /replsummary
```
若显示 “0 fails” 即为正常。
---
### 步骤 5:解除复制限制
```powershell
repadmin /options S-DNS1 -DISABLE_OUTBOUND_REPL
repadmin /options S-DNS6 -DISABLE_OUTBOUND_REPL
```
---
### 步骤 6:验证 FSMO 与名称解析
执行以下命令验证迁移后状态:
```powershell
netdom query fsmo
nslookup shuncom.local
nltest /dclist:shuncom.local
```
应显示:
- FSMO 全部仍在 `S-DNS1.shuncom.local`
- DNS 解析正确对应新 IP
- `nltest` 输出两个 DC 都正常
---
## ✅ 四、可选操作(推荐执行)
1. **清理旧的 DNS 缓存**
```powershell
ipconfig /flushdns
```
2. **在两台 DC 上分别执行**
```powershell
dcdiag /test:dns /v
repadmin /showrepl
```
3. **更新反向查找区域**(如果配置了):
- 确认 192.168.0.4 与 192.168.0.5 的 PTR 记录对应正确主机名。
---
## ✅ 五、总结操作顺序(简版)
| 顺序 | 操作 |
|---|
| 1 | 暂停 AD 复制 |
| 2 | 交换 IP 地址 |
| 3 | 更新 DNS 记录(A / SRV / PTR) |
| 4 | `ipconfig /registerdns` |
| 5 | 启用 AD 复制并验证 (`repadmin /syncall /AdeP`) |
| 6 | 检查 `netdom query fsmo`、`nslookup`、`dcdiag` 均正常 |
---
如果你愿意,我可以帮你生成一份完整的\*\*“域控 IP 互换迁移操作文档(含命令)”\*\*(Word 或 PDF 版本)用于留存或内部操作。
是否希望我帮你整理这份文件?
# 测试让禅道开源版集成LDAP功能
好嘞 👍
我帮你写一个 **开源版禅道登录时调用 AD/LDAP 验证的示例**,直接可以插到 `module/user/control.php` 里的 `login` 方法开头。
---
## 🔹 修改思路
1. 用户输入用户名和密码。
2. 先尝试用 LDAP 验证(比如绑定到 AD 域)。
3. 如果 AD 验证成功,就在禅道本地用户表 `zt_user` 中查找对应账号:
- 如果已存在 → 直接登录。
- 如果不存在 → 自动创建一个账号(避免重复维护)。
4. 如果 LDAP 验证失败 → 走禅道原有的本地认证逻辑。
---
## 🔹 PHP 代码示例
在 `module/user/control.php` 的 `login` 方法开头加:
```php
'192.168.0.5', // AD 域控IP (如 S-DNS6)
'port' => 389, // AD LDAP端口 (389/636 LDAPS)
'base_dn' => 'DC=shuncom,DC=local', // 域DN
'domain' => 'shuncom.local', // 域名
'admin_user' => 'administrator@shuncom.local', // 可选: AD管理用户
'admin_pass' => '你的管理密码' // 可选: 管理密码
);
// ===== 从表单获取用户名密码 =====
$username = trim($this->post->account);
$password = trim($this->post->password);
// ===== LDAP 验证 =====
if(!empty($username) && !empty($password))
{
$ldapconn = ldap_connect($ldapConfig['host'], $ldapConfig['port']);
ldap_set_option($ldapconn, LDAP_OPT_PROTOCOL_VERSION, 3);
ldap_set_option($ldapconn, LDAP_OPT_REFERRALS, 0);
if($ldapconn)
{
// 拼接用户 UPN,如 user@domain
$ldapUser = $username . '@' . $ldapConfig['domain'];
if(@ldap_bind($ldapconn, $ldapUser, $password))
{
// LDAP 验证成功
$filter = "(sAMAccountName={$username})";
$search = ldap_search($ldapconn, $ldapConfig['base_dn'], $filter);
$entries = ldap_get_entries($ldapconn, $search);
if($entries['count'] > 0)
{
$displayName = $entries[0]['cn'][0];
$email = isset($entries[0]['mail'][0]) ? $entries[0]['mail'][0] : $username.'@'.$ldapConfig['domain'];
// 检查用户是否已存在禅道库
$user = $this->dao->select('*')->from(TABLE_USER)->where('account')->eq($username)->fetch();
if(!$user)
{
// 自动创建禅道用户
$newUser = new stdclass();
$newUser->account = $username;
$newUser->realname = $displayName;
$newUser->email = $email;
$newUser->password = md5($password); // 禅道存本地密码(可随便填)
$newUser->role = 'dev';
$newUser->dept = 0;
$newUser->gender = 'm';
$this->dao->insert(TABLE_USER)->data($newUser)->exec();
}
// 直接跳过禅道本地密码校验,构造登录态
$user = $this->dao->select('*')->from(TABLE_USER)->where('account')->eq($username)->fetch();
$this->session->set('user', $user);
// 登录成功后跳转
$this->locate($this->createLink('my', 'index'));
exit;
}
}
}
@ldap_close($ldapconn);
}
// 如果LDAP失败,就继续走禅道原来的登录逻辑
```
---
## 🔹 注意事项
1. `ldap_bind` 默认是明文,如果要走 **LDAPS (636)**,需要配置 SSL 证书。
2. 代码里是直接拼接 `$username@domain`,如果你的域用 `CN=user,CN=Users,DC=xx,DC=local` 形式,需要改 `binddn`。
3. 自动创建禅道用户时给了默认角色 `dev`,可以改成 `pm/test/admin`。
4. 这段代码最好放在 **原有 `$this->user->identify()` 之前**,保证先走 LDAP。
---
要不要我帮你改一份 **完整的 `login()` 方法整合版**(原有禅道逻辑 + 上面的 LDAP 插入好位置),这样你直接覆盖就能测试?
好的 👍 我帮你写一个完整的 `login()` 方法,把 **禅道开源版原有的逻辑** 和 **LDAP(AD 域验证)逻辑**融合在一起。这样你可以直接覆盖 `module/user/control.php` 里的 `login()` 方法来测试。
假设你的 AD 域控制器是 `192.168.0.5`,域名是 `shuncom.local`,管理员只需要验证账号密码,不需要复杂的组判断。
---
### 修改后的 `login()` 方法(整合版)
```php
public function login($referer = 0)
{
if(!empty($_POST))
{
$account = trim($this->post->account);
$password = $this->post->password;
$user = null;
$ldapSuccess = false;
$ldapError = '';
/* === 第一步:尝试 LDAP 验证 === */
$ldapconn = @ldap_connect("ldap://192.168.0.5");
if($ldapconn)
{
ldap_set_option($ldapconn, LDAP_OPT_PROTOCOL_VERSION, 3);
ldap_set_option($ldapconn, LDAP_OPT_REFERRALS, 0);
$ldaprdn = $account . '@shuncom.local'; // UPN 格式
$bind = @ldap_bind($ldapconn, $ldaprdn, $password);
if($bind)
{
$ldapSuccess = true;
// 查找用户在 AD 中的 displayName/mail 等信息
$result = @ldap_search($ldapconn, "DC=shuncom,DC=local", "(sAMAccountName={$account})");
$entries = @ldap_get_entries($ldapconn, $result);
if($entries["count"] > 0)
{
$adName = $entries[0]["displayname"][0] ?? $account;
$adEmail = $entries[0]["mail"][0] ?? "{$account}@shuncom.local";
// 检查禅道数据库是否已存在该用户
$user = $this->user->getByAccount($account);
if(!$user)
{
// 自动创建本地用户
$user = new stdClass();
$user->account = $account;
$user->realname = $adName;
$user->email = $adEmail;
$user->password = md5($password);
$this->dao->insert(TABLE_USER)->data($user)->exec();
$user->id = $this->dao->lastInsertID();
}
}
}
else
{
$ldapError = ldap_error($ldapconn);
}
@ldap_close($ldapconn);
}
/* === 第二步:如果 LDAP 验证失败,走禅道本地逻辑 === */
if(!$ldapSuccess)
{
$user = $this->user->identify($account, $password);
}
/* === 第三步:检查用户结果 === */
if(!$user)
{
$this->view->reason = $ldapError ? "LDAP 验证失败: {$ldapError}" : $this->lang->user->loginFailed;
return $this->display();
}
if($user->deleted == 1)
{
$this->view->reason = $this->lang->user->loginFailed;
return $this->display();
}
/* === 第四步:写入 session,记录登录日志 === */
$this->session->set('user', $user);
$this->user->cleanLocked($account);
$this->loadModel('action')->create('user', $user->id, 'login');
/* === 第五步:重定向 === */
if($referer) $this->locate($referer);
if($this->session->user->last) $this->locate($this->session->user->last);
$this->locate($this->createLink('my', 'index'));
}
$this->display();
}
```
---
✅ **逻辑说明:**
1. 优先调用 **LDAP 验证**,成功后自动同步用户到禅道数据库(不存在就创建)。
2. 如果 LDAP 验证失败,继续走 **禅道本地数据库逻辑**。
3. 登录成功后,写入 session 并跳转。
4. 保留了禅道原有的 `$this->user->identify()`、`$this->session->set()`、`action->create()` 等逻辑。
---
要不要我帮你做一个 **配置开关**(比如 `config->ldap->enable`),这样可以灵活选择走 AD 还是本地?
# win server 2022 辅助域降级失败强制降级步骤
明白,你现在需要对 **192.168.0.4 辅助域控制器**(Secondary DC)进行 **强制降级**,因为正常降级失败。下面我帮你整理一份 **详细、安全的步骤**,包括 Windows Server 2022 环境(如果是其他版本,请告知,我会调整步骤)。
---
# 🔹 Windows 辅助域控制器强制降级步骤
> **注意**:强制降级会删除该 DC 上的 AD 数据。必须确保 **其他 DC(0.5 主域)正常且可用**,以避免域损坏。
---
## 1️⃣ 确认环境
1. 在主域 0.5 上确认:
- 所有 FSMO 角色在主 DC 上,辅助 DC 没有持有任何 FSMO 角色
- Active Directory 健康状态正常:
```powershell
dcdiag /v /c /d /e > C:\dcdiag.log
repadmin /replsummary
```
2. 确认 0.4 无其他重要服务(如 DNS、DHCP)依赖
---
## 2️⃣ 尝试正常降级(如果还没尝试)
1. 打开 **Server Manager → Manage → Remove Roles and Features**
2. 取消 **Active Directory Domain Services (AD DS)**
3. 按提示降级 DC
4. 如果出现错误提示“无法联系其他域控制器或复制失败”,就进入 **强制降级步骤**
---
## 3️⃣ 强制降级步骤(当正常降级失败)
### 方法 1:使用 `dcpromo` 强制降级(旧版兼容)
> Windows Server 2012 之后 dcpromo GUI 已废弃,但可通过命令行仍可执行。
1. 打开 **命令提示符(管理员)**
2. 执行:
```cmd
dcpromo /forceremoval /unattend /AdministratorPassword:你的本地管理员密码
```
- `/forceremoval`:强制降级 DC
- `/unattend`:跳过向导
- `/AdministratorPassword`:降级后本地管理员密码
3. 系统会提示强制降级 AD 数据并重启
---
### 方法 2:使用 **Server Manager GUI 强制降级**
1. 打开 **Server Manager → Remove Roles and Features → AD DS → Remove**
2. 如果提示无法降级:
- 选择 **“Force the removal of this domain controller”**
- 设置本地管理员密码
- 系统将自动删除 AD DS 并重启
---
## 4️⃣ 删除 DNS / 清理元数据
1. 如果该 DC 执行了 DNS 服务,需要手动清理 **AD DS 中的 DNS 条目**
2. 在 **主 DC 0.5** 上执行:
```powershell
ntdsutil
metadata cleanup
```
- 选择 **Remove selected server** → 输入 0.4 的名称 → 完成元数据清理
3. 确认 **AD Sites and Services** 中 0.4 已移除
4. 确认 **DNS 管理**中不存在 0.4 的 SRV 记录
---
## 5️⃣ 网络和客户端清理
- 客户端和服务器不再指向 0.4 作为 DNS
- VPN / LDAP 配置中删除 0.4
---
## 6️⃣ 验证
1. 在主 DC 上运行:
```powershell
dcdiag /v /c /d /e
repadmin /replsummary
```
确认没有错误
2. 确认 0.4 已成功从域移除
---
💡 **注意事项**:
- **强制降级**会导致 0.4 上的 AD 数据丢失,请确保备份
- 降级前 **FSMO 必须在主 DC**
- 强制降级后必须 **清理 DNS / 元数据**,否则域可能报错
---
如果你需要,我可以帮你写一份 **完整命令和步骤脚本化操作清单**,确保 **0.4 强制降级 + 元数据清理** 一次性完成,无遗漏。
你希望我帮你整理吗?
# 手动创建 NETLOGON/ SYSVOL 共享
明白了,你现在的输出说明了几个关键问题:
1. **`Get-DfsrGroup` 和 `Get-DfsrReplicatedFolder` 仍然无法识别**
- 在 Windows Server 2022/2025 上,这些 cmdlet 可能不在标准 PowerShell 模块里,或者 RSAT-DFS 工具不完整。
- 你能用的 cmdlet 仅有 `Get-DfsrMember`,而且显示状态为 **Invalid**,说明 DFS-R **复制组在新主域 S-DNS1 上没有正常配置**。
2. **现有 DFS-R 状态**
```text
GroupName : 复制组01
State : Invalid
```
- 这表示 DFS-R 复制组存在数据,但新主域没有注册为有效成员
- SYSVOL 文件夹在 S-DNS1 上仍然是空的
---
### 根本原因
- 新主域 DC 夺取 FSMO 后,**DFS-R 没有被正确初始化 SYSVOL**
- DFS-R 复制组在 S-DNS1 上无效 → 不能通过 DFS-R 同步 SYSVOL → 所以没有 NETLOGON/ SYSVOL 共享
- 夺取 FSMO 并不会自动把旧 DC 的 SYSVOL 复制过来
---
### 建议的安全修复方案(最稳妥)
#### 方法:手动从旧 DC 复制 SYSVOL 内容到新主域
1. **在旧主域 S-DNS6 上确认 SYSVOL 完整性**
```cmd
dir C:\Windows\SYSVOL\domain
dir C:\Windows\SYSVOL\sysvol
```
- 确保包含 `Policies`、`Scripts` 等文件夹
2. **在 S-DNS1 上停止 DFS-R 服务**
```powershell
Stop-Service DFSR
```
3. **从 S-DNS6 复制 SYSVOL 内容到 S-DNS1**
```cmd
robocopy \\S-DNS6\SYSVOL\shuncom.local C:\Windows\SYSVOL\domain /MIR /COPYALL /R:1 /W:1
robocopy \\S-DNS6\SYSVOL\sysvol C:\Windows\SYSVOL\sysvol /MIR /COPYALL /R:1 /W:1
```
4. **设置正确权限**
- NTFS 权限:
- SYSTEM → 完全控制
- Domain Admins → 完全控制
- Authenticated Users → 读取
5. **发布共享**
```cmd
net share SYSVOL=C:\Windows\SYSVOL\sysvol /GRANT:"Domain Admins",FULL
net share NETLOGON=C:\Windows\SYSVOL\domain\scripts /GRANT:"Domain Admins",FULL
```
6. **启动 DFS-R 服务**
```powershell
Start-Service DFSR
```
7. **验证共享和访问**
```cmd
net share
\\S-DNS1\SYSVOL
\\S-DNS1\NETLOGON
```
---
✅ **效果**:
- 新主域 S-DNS1 立即拥有完整的 SYSVOL 内容
- NETLOGON 和 SYSVOL 共享正常
- DFS-R 后续可以用作自动同步(可选,确保旧 DC 内容为主)
---
非常好,这个输出表明你的 **主域控制器 S-DNS1(192.168.0.5)** 现在已经能正常承担 **PDC 仿真器(PDC Emulator)和全局编录(GC)** 功能,核心域控服务工作是正常的。
我们逐项分析一下这个结果的意义 👇
---
### 🧩 1. `nltest /dcname:shuncom.local` 报错
```
NetGetDCName 失败: Status = 2453 0x995 NERR_DCNotFound
```
这一条说明:
- **NetGetDCName API 暂时没能返回域控制器信息**。
- 原因可能是 **DNS 缓存或 Netlogon 服务尚未完全同步更新**,尤其在你刚调整或清理 SRV 记录后。
- 但不影响后续,因为 `nltest /dsgetdc` 返回是正常的。
---
### ✅ 2. `nltest /dsgetdc:shuncom.local /pdc` 返回结果正常
```
DC: \\S-DNS1.shuncom.local
地址: \\192.168.0.5
标志: PDC GC DS LDAP KDC TIMESERV GTIMESERV WRITABLE DNS_DC DNS_DOMAIN DNS_FOREST CLOSE_SITE FULL_SECRET ...
```
这说明:
- 当前 **PDC 仿真器已定位为 S-DNS1**;
- 该 DC 具有:
- **GC(全局编录)**
- **DS(目录服务)**
- **LDAP、Kerberos、KDC、DNS 集成**
- **WRITABLE(可写域控)**
- 网络站点识别一致:`Default-First-Site-Name`
- 所有标志(`PDC`, `KDC`, `DNS_DC` 等)都表明 AD 功能完备。
> ✅ **结论**:S-DNS1 已成为功能完整、正常工作的域控制器。
---
### 🔍 3. 接下来建议执行的验证步骤
请依次执行以下命令来确认各项域服务完全恢复:
```powershell
# 检查 SYSVOL 是否共享正常
net share | findstr SYSVOL
net share | findstr NETLOGON
# 检查 SYSVOL/Netlogon 访问
dir \\s-dns1\SYSVOL
dir \\s-dns1\netlogon
# 检查 DFSR 状态
dfsrdiag pollad
dfsrdiag backlog /rgname:"Domain System Volume" /rfname:"SYSVOL Share" /smem:s-dns1 /rmem:s-dns1
# 检查 AD 复制状态
repadmin /replsummary
repadmin /showrepl
repadmin /syncall /AdeP
# 检查 DC 广告状态
dcdiag /test:advertising /test:sysvol /test:netlogons
```
---
### ⚙️ 4. 如果 `SYSVOL` 或 `NETLOGON` 没有共享
可执行以下命令重新发布:
```powershell
net share SYSVOL=C:\Windows\SYSVOL\sysvol /grant:"Domain Admins",full
net share NETLOGON=C:\Windows\SYSVOL\domain\scripts /grant:"Domain Admins",full
```
---
### 🧱 5. 如果仍出现“找不到 DC”的情况
执行以下步骤清理缓存:
```powershell
ipconfig /flushdns
nltest /dsregdns
net stop netlogon
net start netlogon
```
> 这将强制重新注册域控 SRV 记录。
---
是否希望我帮你出一份
✅ **“确认域控恢复正常的完整检查清单(含命令+预期结果说明)”**?
这样你可以系统地验证 S-DNS1 的所有 FSMO 与 SYSVOL 功能是否都完全恢复。
# 完整操作步骤表,目的是彻底清理 S-DNS6 的残留 SRV 记录,并让 S-DNS1 全权承管 SYSVOL/NETLOGON
好的,我帮你整理一个 **完整操作步骤表**,目的是彻底清理 S-DNS6 的残留 SRV 记录,并让 S-DNS1 全权承管 SYSVOL/NETLOGON,同时保证 DFSR、Netlogon 和 DNS 正常。整个流程分为 **准备阶段、清理阶段、确认阶段、修复阶段** 四大步骤。
---
## **一、准备阶段(确认环境)**
1. **确认 S-DNS1 和 S-DNS6 的状态**
- 在 S-DNS1 上:
```powershell
nltest /dsgetdc:shuncom.local /pdc
repadmin /replsummary
dfsrdiag /getglobalstate
```
- 在 S-DNS6 上:
```powershell
net stop netlogon
dfsrdiag /getglobalstate
repadmin /replsummary
```
- 确认 DFSR 全局状态和复制状态。**S-DNS6 停止 Netlogon,不参与注册 SRV。**
2. **备份 DNS 和 SYSVOL**
- DNS:导出 `shuncom.local` 区域。
- SYSVOL:复制 `C:\Windows\SYSVOL\sysvol` 和 `C:\Windows\SYSVOL\domain\scripts` 到安全位置。
---
## **二、清理 S-DNS6 残留 SRV 记录**
> 目标:让 S-DNS6 不再出现在 \_ldap、\_kerberos、\_gc 等 SRV 记录中,但不删除其他 DC 信息。
1. **在 S-DNS1 上打开 DNS 管理器**:
- 打开 `DNS -> shuncom.local -> _msdcs.shuncom.local`
- 查找涉及 `s-dns6.shuncom.local` 的 SRV 记录:
- `_ldap._tcp.dc._msdcs.shuncom.local`
- `_kerberos._tcp.dc._msdcs.shuncom.local`
- `_gc._tcp.shuncom.local`
- `_ldap._tcp.gc._msdcs.shuncom.local`
- **修改记录的优先级为高或权重为 0**(Windows DNS 不支持“禁用”,可以手动降低优先级,使 S-DNS1 优先)。
- 可考虑 **将 S-DNS6 SRV 移至其他备用站点** 或在 DNS 上设置 **禁止注册 DC 记录**(在 S-DNS6 上注册表:`HKLM\SYSTEM\CurrentControlSet\Services\Netlogon\Parameters\DnsAvoidRegisterRecords`)。
2. **在 S-DNS6 上禁止注册 SRV**:
```reg
reg add "HKLM\SYSTEM\CurrentControlSet\Services\Netlogon\Parameters" /v DnsAvoidRegisterRecords /t REG_MULTI_SZ /d "_ldap._tcp._sites._tcp._gc" /f
net stop netlogon
net start netlogon
```
- 可指定多条记录防止注册。
3. **清理 DNS 缓存并强制刷新**:
- 在 S-DNS1:
```powershell
dnscmd /clearcache
ipconfig /flushdns
```
- 强制注册 DNS:
```powershell
nltest /dsregdns /server:s-dns1.shuncom.local
```
- 检查 SRV:
```powershell
nslookup -type=SRV _ldap._tcp.dc._msdcs.shuncom.local
nslookup -type=SRV _kerberos._tcp.dc._msdcs.shuncom.local
nslookup -type=SRV _gc._tcp.shuncom.local
```
---
## **三、确保 S-DNS1 承管 SYSVOL/NETLOGON**
1. **检查 DFSR 状态**(S-DNS1 上):
```powershell
dfsrdiag /getglobalstate
dfsrdiag backlog /rgname:"Domain System Volume" /rfname:"SYSVOL Share" /smem:s-dns1 /rmem:s-dns1
```
- 确认无 backlog,状态为 `已消除` 或 `开始`。
2. **启动 Netlogon 并注册共享**:
```powershell
net start netlogon
nltest /dsregdns /server:s-dns1.shuncom.local
```
- 确认 SYSVOL/NETLOGON 共享:
```powershell
net share
dir \\s-dns1\SYSVOL
dir \\s-dns1\NETLOGON
```
- 如果共享消失,手动创建:
```powershell
net share SYSVOL=C:\Windows\SYSVOL\sysvol /GRANT:"Domain Admins",FULL
net share NETLOGON=C:\Windows\SYSVOL\domain\scripts /GRANT:"Domain Admins",FULL
```
3. **强制 DFSR AD 同步**(S-DNS1 → S-DNS6):
```powershell
repadmin /syncall /AdeP
repadmin /showrepl
```
---
## **四、验证阶段**
1. **检查 AD 健康**:
```powershell
dcdiag /test:advertising /test:netlogons /test:sysvol
```
- 确认 S-DNS1 通过所有测试。
- 确认 S-DNS6 不再出现在主要 SRV 记录列表中。
2. **检查 SRV 注册**:
```powershell
nslookup -type=SRV _ldap._tcp.dc._msdcs.shuncom.local
nslookup -type=SRV _kerberos._tcp.dc._msdcs.shuncom.local
nslookup -type=SRV _gc._tcp.shuncom.local
```
- S-DNS1 应为主注册 DC。
- S-DNS6 可保留,但权重最低或不注册。
3. **确认 SYSVOL/NETLOGON 可用**:
- 从其他 DC 或客户端访问:
```
\\s-dns1\SYSVOL
\\s-dns1\netlogon
```
---
✅ **注意事项**
- S-DNS6 停止 Netlogon 并不删除 AD 内对象,只是避免注册 SRV。
- 手动共享可作为临时补救,但长期依赖 Netlogon。
- 所有 DNS 改动建议在业务低峰进行。
- 完成后可在 S-DNS1 上强制刷新 AD 和 DNS:
```powershell
repadmin /syncall /AdeP
nltest /dsregdns /server:s-dns1.shuncom.local
ipconfig /registerdns
```
---
明白了,你现在遇到的状况是:
- **DFSRDIAG 无法联系 S-DNS1 和 S-DNS6**,报错 1355 / 1717,这说明 **域控制器定位失败或者 Netlogon 注册异常**。
- **Netlogon 服务已经启动**,但 SYSVOL/NETLOGON 共享不稳定,ipconfig /registerdns 之后共享会消失。
这说明 DFSR、DNS 和 Netlogon 三者之间的关系尚未彻底理顺,S-DNS1 还未完全“接管” PDC/SYSVOL/NETLOGON。
---
## 🔹 原因分析
1. **S-DNS6 已停用 Netlogon** → 但 AD、DNS 中可能仍有它的 SRV 记录残留。
2. **S-DNS1 DFSR 配置未完全激活** → `ReplicationState` 和 `Backlog` 无法访问。
3. **DNS SRV 记录混乱** → DsGetDcName 可能仍返回 S-DNS6,导致 DFSR/Netlogon 定位失败。
4. **Netlogon 注册顺序问题** → 如果 S-DNS1 注册 DNS 时,AD 中仍存在 S-DNS6 信息,SYSVOL/NETLOGON 共享可能被 DFSR 冻结或删除。
---
## 🔹 建议解决方案(彻底清理 + 全权承管)
### **步骤 1:完全停止 S-DNS6 Netlogon**
```powershell
# S-DNS6 上执行
net stop netlogon
sc config netlogon start= disabled
```
- 禁止自动启动,避免残留 SRV 注册。
### **步骤 2:清理 DNS 中 S-DNS6 SRV**
- 打开 **DNS 管理器 → 正向查找区 → \_msdcs.shuncom.local**
- 删除所有指向 S-DNS6 的 SRV 记录:
- `_ldap._tcp.dc._msdcs.shuncom.local`
- `_kerberos._tcp.dc._msdcs.shuncom.local`
- `_gc._tcp.shuncom.local`
- 可使用 PowerShell 批量删除:
```powershell
Import-Module DNSServer
Remove-DnsServerResourceRecord -ZoneName "_msdcs.shuncom.local" -Name "_ldap._tcp.dc._msdcs.shuncom.local" -RRType "SRV" -ComputerName S-DNS1
```
### **步骤 3:在 S-DNS1 强制注册 Netlogon / SYSVOL**
```powershell
# 停止再启动 Netlogon
net stop netlogon
net start netlogon
# 强制注册 DC SRV
nltest /dsregdns /server:S-DNS1.shuncom.local
```
- 验证 SYSVOL / NETLOGON 共享:
```powershell
net share
dir \\S-DNS1\SYSVOL
dir \\S-DNS1\netlogon
```
- 如果缺失,手动创建:
```powershell
net share SYSVOL=C:\Windows\SYSVOL\sysvol /GRANT:"Domain Admins",FULL
net share NETLOGON=C:\Windows\SYSVOL\domain\scripts /GRANT:"Domain Admins",FULL
```
### **步骤 4:检查 DFSR 状态**
- 由于 DFSRDIAG 无法联系 DC,你必须先确保 **S-DNS1 DNS 注册正常且可以解析自己**:
```powershell
nslookup s-dns1.shuncom.local
ping s-dns1.shuncom.local
```
- 然后触发 AD 与 DFSR 同步:
```powershell
dfsrdiag PollAD
```
- 若仍无法访问 DFSRDIAG,可考虑 **强制重建 DFSR SYSVOL**(在 PDC 上执行):
```powershell
# 强制 S-DNS1 成为 SYSVOL 主
dfsrdiag PollAD
# 若必要,使用 PDC FSMO 角色的系统状态备份/恢复
```
### **步骤 5:验证 AD / DNS / SYSVOL 健康**
```powershell
# 检查 AD 同步
repadmin /showrepl
repadmin /replsummary
# 检查 DC 健康
dcdiag /test:advertising /test:netlogons /test:sysvol
# 验证 DNS SRV
nslookup -type=SRV _ldap._tcp.dc._msdcs.shuncom.local
nslookup -type=SRV _kerberos._tcp.dc._msdcs.shuncom.local
```
- 确认返回均为 **S-DNS1**,S-DNS6 不再出现。
---
💡 **关键点**:
1. **彻底禁用 S-DNS6 Netlogon 并清理 DNS SRV**。
2. **S-DNS1 必须注册自身 DC SRV 并启动 SYSVOL/NETLOGON 共享**。
3. **DNS SRV 清理顺序在 Netlogon 注册之前**,避免 DFSR/SYSVOL 被覆盖。
4. **DFSRDIAG 和 repadmin 操作依赖 DNS 正确解析和 Netlogon 注册**。
---
如果你同意,我可以帮你整理一个 **可直接执行的命令顺序表(包含 S-DNS6 停用、DNS SRV 清理、S-DNS1 注册 SYSVOL/NETLOGON、DFSR 验证、健康检查)**,保证一步到位不报错。
你希望我直接帮你整理吗?
# 检查+修复 S-DNS1 域控制器健康度
非常关键的状态描述 👍。
你现在的域环境情况可以总结如下,这也是很多 AD 故障转移或清理过程中常见的“半健康状态”:
---
## 🧩 一、当前结构判断
| 项目 | 状态 |
|---|
| 域控制器 1 | **S-DNS1.shuncom.local(192.168.0.5)** — 存活、主域控制器(FSMO) |
| 域控制器 2 | **S-DNS6.shuncom.local(192.168.0.4)** — 存活、辅助 DC(但 SYSVOL/Netlogon 复制异常) |
| 客户端表现 | 域登录、DNS、GPO、认证等功能正常(因为 S-DNS6 仍在运行) |
| 问题 | 当关闭 S-DNS6 并删除相关 SRV 记录后,客户端找不到 DC,域登录与认证中断 |
---
## 🚨 二、问题的根本原因
这说明:
> 当前整个域中,**S-DNS1 并没有完整地“对外发布”自己是一个可用 DC**。
> 客户端的 DC 定位逻辑(DC Locator)仍依赖 **S-DNS6**。
换句话说:
- DNS SRV 记录 `_ldap._tcp.dc._msdcs.shuncom.local`、`_kerberos._tcp.dc._msdcs.shuncom.local` 仍把 S-DNS6 作为首选;
- S-DNS1 的 **Netlogon 注册信息未完整写入 DNS**;
- 甚至可能 SYSVOL 没有正确共享(或 DFSR 未完成初始同步),导致客户端通过 DC 定位后仍判定 S-DNS1 “不适合”。
---
## 🔍 三、验证思路(不要急着关机 S-DNS6)
在清理前,先验证 S-DNS1 是否具备“完整 DC 功能”。
依次执行以下命令,分析结果:
### **1️⃣ 验证 SYSVOL / NETLOGON 共享**
```powershell
net share
```
输出应包含:
```
NETLOGON C:\Windows\SYSVOL\sysvol\shuncom.local\SCRIPTS
SYSVOL C:\Windows\SYSVOL\sysvol
```
若缺失,则 S-DNS1 无法提供组策略和登录脚本服务,客户端认为该 DC “不健康”。
---
### **2️⃣ 验证 DFSR 状态**
```powershell
Get-CimInstance -Namespace "root\MicrosoftDFS" -ClassName DfsrReplicatedFolderInfo |
Select ReplicationGroupName, ReplicatedFolderName, State
```
正常状态下 `state` 应为 `4 (正常)`。
若无输出或状态为 `2`、`3`,说明 DFSR 未同步完毕或配置异常。
---
### **3️⃣ 验证 Netlogon 动态注册**
重新注册并查看 DNS SRV:
```powershell
net stop netlogon
ipconfig /flushdns
ipconfig /registerdns
net start netlogon
nslookup -type=SRV _ldap._tcp.dc._msdcs.shuncom.local
```
👉 如果结果中不含 `s-dns1.shuncom.local`,说明 Netlogon 注册失败(通常由于 SYSVOL/DFSR 问题)。
---
### **4️⃣ 验证 DC 广告状态**
```powershell
dcdiag /test:advertising
```
如果看到:
```
S-DNS1 没有通过测试 Advertising
```
那就意味着客户端不会选择它作为 DC。
---
## 🧰 四、恢复正确顺序(让 S-DNS1 成为唯一权威 DC)
以下是逐步过渡方案(安全执行,无需马上关机 S-DNS6):
---
### **① 让 S-DNS1 修复 DFSR 状态**
在 **S-DNS1** 上执行:
```powershell
dfsrdiag pollad
wmic /namespace:\\root\microsoftdfs path dfsrmachineconfig get replicationgroupconfigpresent
```
如果输出为 `FALSE`,则注册 DFSR 配置:
```powershell
wmic /namespace:\\root\microsoftdfs path dfsrmachineconfig call PollAD
```
再执行:
```powershell
dfsrdiag ReplicationState
```
若仍无法查询,可能需要重新初始化 SYSVOL(我们后续可生成 safe rebuild 步骤)。
---
### **② 验证 S-DNS1 的 SYSVOL 共享恢复**
```powershell
net share
```
确认 `SYSVOL` 和 `NETLOGON` 出现。
---
### **③ 在 DNS 中删除 S-DNS6 SRV 前,确保 S-DNS1 注册成功**
再次执行:
```powershell
nltest /dsregdns
nslookup -type=SRV _ldap._tcp.dc._msdcs.shuncom.local
```
若结果只包含 `s-dns1.shuncom.local`,说明注册成功。
---
### **④ 验证客户端能定位 S-DNS1**
在一台域客户端执行:
```powershell
nltest /dsgetdc:shuncom.local /force
nltest /dcname:shuncom.local
```
返回:
```
DC: \\S-DNS1.shuncom.local
地址: \\192.168.0.5
```
✅ 域控制功能恢复,才能安全下线 S-DNS6。
---
## 🧩 五、S-DNS6 下线步骤(在确认上面全部通过后)
1. 在 S-DNS6 上:
```powershell
net stop netlogon
net stop dfsr
dcpromo /demote
```
将其降级为普通成员服务器。
2. 在 S-DNS1 上清理元数据:
```powershell
ntdsutil
metadata cleanup
remove selected server S-DNS6
quit
quit
```
3. 清除 DNS 中所有与 `S-DNS6` 相关的 A / SRV 记录。
4. 最后执行:
```powershell
nltest /dsregdns
repadmin /syncall /AdeP
```
---
## ✅ 六、总结
你现在的现象说明:
> 域功能正常仅因为 S-DNS6 仍在运行,S-DNS1 尚未“完全被广告为域控制器”。
重点在于:
- 修复 S-DNS1 的 SYSVOL/DFSR;
- 让 Netlogon 注册生效;
- 验证 `dcdiag /test:advertising` 通过;
- 再清除 DNS 的旧记录并下线 S-DNS6。
---
这个错误的根本原因是:
> **Windows 10 / Windows Server 2022 及之后的版本已移除 `wmic.exe` 工具**,因此系统无法识别 `wmic` 命令。
---
### ✅ 一、替代方案:用 PowerShell 查询 DFSR 状态(推荐)
可以使用 **PowerShell 的 WMI / CIM 命令** 代替 `wmic`:
```powershell
# 获取 DFSR 复制文件夹状态
Get-WmiObject -Namespace "root\MicrosoftDFS" -Class DfsrReplicatedFolderInfo |
Select-Object ReplicationGroupName, ReplicatedFolderName, State
```
或使用较新的 `Get-CimInstance`(建议在 Windows Server 2019/2022 用):
```powershell
Get-CimInstance -Namespace "root\MicrosoftDFS" -ClassName DfsrReplicatedFolderInfo |
Select ReplicationGroupName, ReplicatedFolderName, State
```
输出中:
- **State = 4** → 表示 *“已就绪 (Normal)”*。
- 其他值如 2、3 表示正在初始化或同步中。
---
### ✅ 二、若要查看 DFSR 服务状态
```powershell
Get-Service DFSR
```
应显示:
```
Status Name DisplayName
------ ---- -----------
Running DFSR DFS Replication
```
---
### ✅ 三、查看 DFSR 的连接伙伴状态
```powershell
Get-WmiObject -Namespace "root\MicrosoftDFS" -Class DfsrConnectionInfo |
Select-Object ConnectionName, PartnerName, Enabled
```
---
### ✅ 四、进一步验证 SYSVOL 是否由 DFSR 管理
```powershell
dfsrdiag pollad
dfsrdiag replicationstate
```
如报错可确认 DFSR 尚未正确注册或服务未启动。
---
### ✅ 五、如果 DFSR 仍不正常,可做以下检查
1. **服务检查**:`services.msc` → 确认 “DFS Replication” 已启动。
2. **事件日志**:查看:
```
事件查看器 → 应用程序和服务日志 → DFS Replication
```
重点关注事件 ID:
- **4112**:开始复制
- **4114**:复制暂停(例如 SYSVOL 停止共享)
- **4602**:SYSVOL 已完成迁移(健康)
3. **域控制器同步状态**:
```powershell
repadmin /replsummary
repadmin /showrepl
```
---
### ✅ 六、如果你只需要确认 SYSVOL 是否正常共享
```powershell
net share
```
应能看到:
```
Share name Resource
---------- --------
NETLOGON C:\Windows\SYSVOL\sysvol\shuncom.local\SCRIPTS
SYSVOL C:\Windows\SYSVOL\sysvol
```
---
非常好,这组输出信息非常关键,我们可以完整地判断当前 **S-DNS1 的 DFSR 与 SYSVOL 复制状态**。
下面是你的状态诊断结果 + 后续建议操作表。
---
## 🧩 一、当前状态诊断汇总
| 检查项 | 当前结果 | 说明 |
|---|
| **DFSR 服务状态** | ✅ Running | 服务正常运行 |
| **DFSR 管理的 SYSVOL 状态** | ⚠️ `State = 2` | 表示 DFSR 处于 **“初始化中 (Initialization)”**,SYSVOL 尚未完全进入 “正常复制 (State=4)” |
| **DFSR 伙伴关系** | ⚠️ Partner = `S-DNS6` | 当前 DFSR 的复制伙伴仍是旧的辅助域 `S-DNS6` |
| **出站 / 入站复制连接** | ⚠️ 均为 0 | 表示目前没有复制活动进行(因为唯一伙伴 S-DNS6 可能不可达或未启用) |
| **SYSVOL / NETLOGON 共享** | ✅ 均存在 | 本地共享已可用,说明 SYSVOL 树结构本地健康 |
---
## 🧠 结论分析
- 当前 **S-DNS1 的 SYSVOL 共享功能正常,但 DFSR 仍认为它有个复制伙伴 S-DNS6**。
- 因此,如果关闭或移除 S-DNS6,而不先清理 DFSR 元数据,S-DNS1 的 DFSR 服务会认为复制集异常(即仍处于初始化状态),进而影响域控制器广告、组策略分发、脚本同步等。
- 你看到的 `State=2` 就是 DFSR 尚未进入健康的 “正常” 状态的直接信号。
---
## ✅ 二、彻底清理旧伙伴 S-DNS6 并让 S-DNS1 独立承管 SYSVOL 的操作步骤表
### **步骤 1:确认当前唯一有效 DC 是 S-DNS1**
```powershell
netdom query fsmo
```
应全部指向 `S-DNS1.shuncom.local`。
---
### **步骤 2:从 AD 元数据中删除 S-DNS6**
在任意健康 DC(此处即 S-DNS1)上执行:
```powershell
ntdsutil
metadata cleanup
connections
connect to server S-DNS1
quit
select operation target
list domains
select domain <你的域编号>
list sites
select site <你的站点编号>
list servers in site
select server
quit
remove selected server
quit
```
确认后在 AD 用户与计算机中不再出现 `S-DNS6`。
---
### **步骤 3:清理 DNS 中 S-DNS6 的 SRV / A 记录**
在 `DNS 管理器` → `shuncom.local` → `_msdcs`、`_sites`、`_tcp`、`_udp` 下手动删除以下记录:
- `_ldap._tcp.dc._msdcs.shuncom.local`
- `_kerberos._tcp.dc._msdcs.shuncom.local`
- `_ldap._tcp.Default-First-Site-Name._sites.dc._msdcs.shuncom.local`
- 以及 S-DNS6 对应的 `主机(A)` 记录。
---
### **步骤 4:清理 DFSR 元数据中的 S-DNS6 链接**
在 S-DNS1 上运行:
```powershell
dfsmgmt.msc
```
- 展开 **“Replication” → “Domain System Volume”**
- 删除与 S-DNS6 相关的 **连接对象 (Connections)**
若图形界面操作不可行,可强制清理:
```powershell
dfsrdiag dumpadcfg > C:\dfsr_before.txt
```
查找其中的 `` 节点中包含 `S-DNS6` 的条目,然后:
- 打开 **ADSIEdit.msc**
- 连接到命名上下文:`CN=DFSR-GlobalSettings,CN=System,DC=shuncom,DC=local`
- 删除包含 `S-DNS6` 的连接对象。
---
### **步骤 5:强制刷新 DFSR 配置**
```powershell
dfsrdiag pollad
```
然后重启 DFSR 服务:
```powershell
Restart-Service DFSR
```
---
### **步骤 6:验证 DFSR 状态是否恢复正常**
再次执行:
```powershell
Get-CimInstance -Namespace "root\MicrosoftDFS" -ClassName DfsrReplicatedFolderInfo |
Select ReplicationGroupName, ReplicatedFolderName, State
```
若显示:
```
Domain System Volume SYSVOL Share 4
```
✅ 表示 DFSR 状态“正常(Normal)”,S-DNS1 已独立管理 SYSVOL。
---
### **步骤 7:验证 Netlogon 和 DNS 注册**
1. 强制重新注册 Netlogon 记录:
```powershell
net stop netlogon
net start netlogon
```
2. 检查 DNS 是否自动刷新:
```powershell
nslookup -type=SRV _ldap._tcp.dc._msdcs.shuncom.local
```
应仅返回 `S-DNS1`。
3. 验证客户端域加入 / 登录:
```cmd
nltest /dsgetdc:shuncom.local
```
应能正常返回 `S-DNS1`。
---
## ✅ 三、可选:DFSR 状态检查脚本(简化)
```powershell
Write-Host "=== DFSR Replicated Folder Info ==="
Get-CimInstance -Namespace "root\MicrosoftDFS" -ClassName DfsrReplicatedFolderInfo |
Select ReplicationGroupName, ReplicatedFolderName, State
Write-Host "`n=== DFSR Connection Info ==="
Get-CimInstance -Namespace "root\MicrosoftDFS" -ClassName DfsrConnectionInfo |
Select ConnectionName, PartnerName, Enabled
Write-Host "`n=== SYSVOL/NETLOGON Shares ==="
net share | findstr "SYSVOL NETLOGON"
```
---
是否希望我帮你把上述操作步骤整理成一份 **表格化的执行手册(Word/PDF)**?包括命令行、图形界面路径、预期结果和恢复步骤,方便操作时逐项打勾确认。
# AD系统升级到Server 2025后DFSR错误引起的ADDS不能正常播发
项目背景:生产环境承载AD服务的所有Windows Server操作系统升级到Windows Server 2025。
项目要求:现有名为DC和DC02…DC0?的若干台DC服务器,FSMO由DC承担。各DC操作系统从Windows Server 2012到Windows Server 2022都有,dcdiag健康检查全部通过。要求将所有Windows Server系统升级到Windows Server 2025,把一台新服务器取名为DC01,完成后承担FSMO,原DC降级退域。
升级过程此篇不表,升级后的两个错误如下:
事件ID:5012
[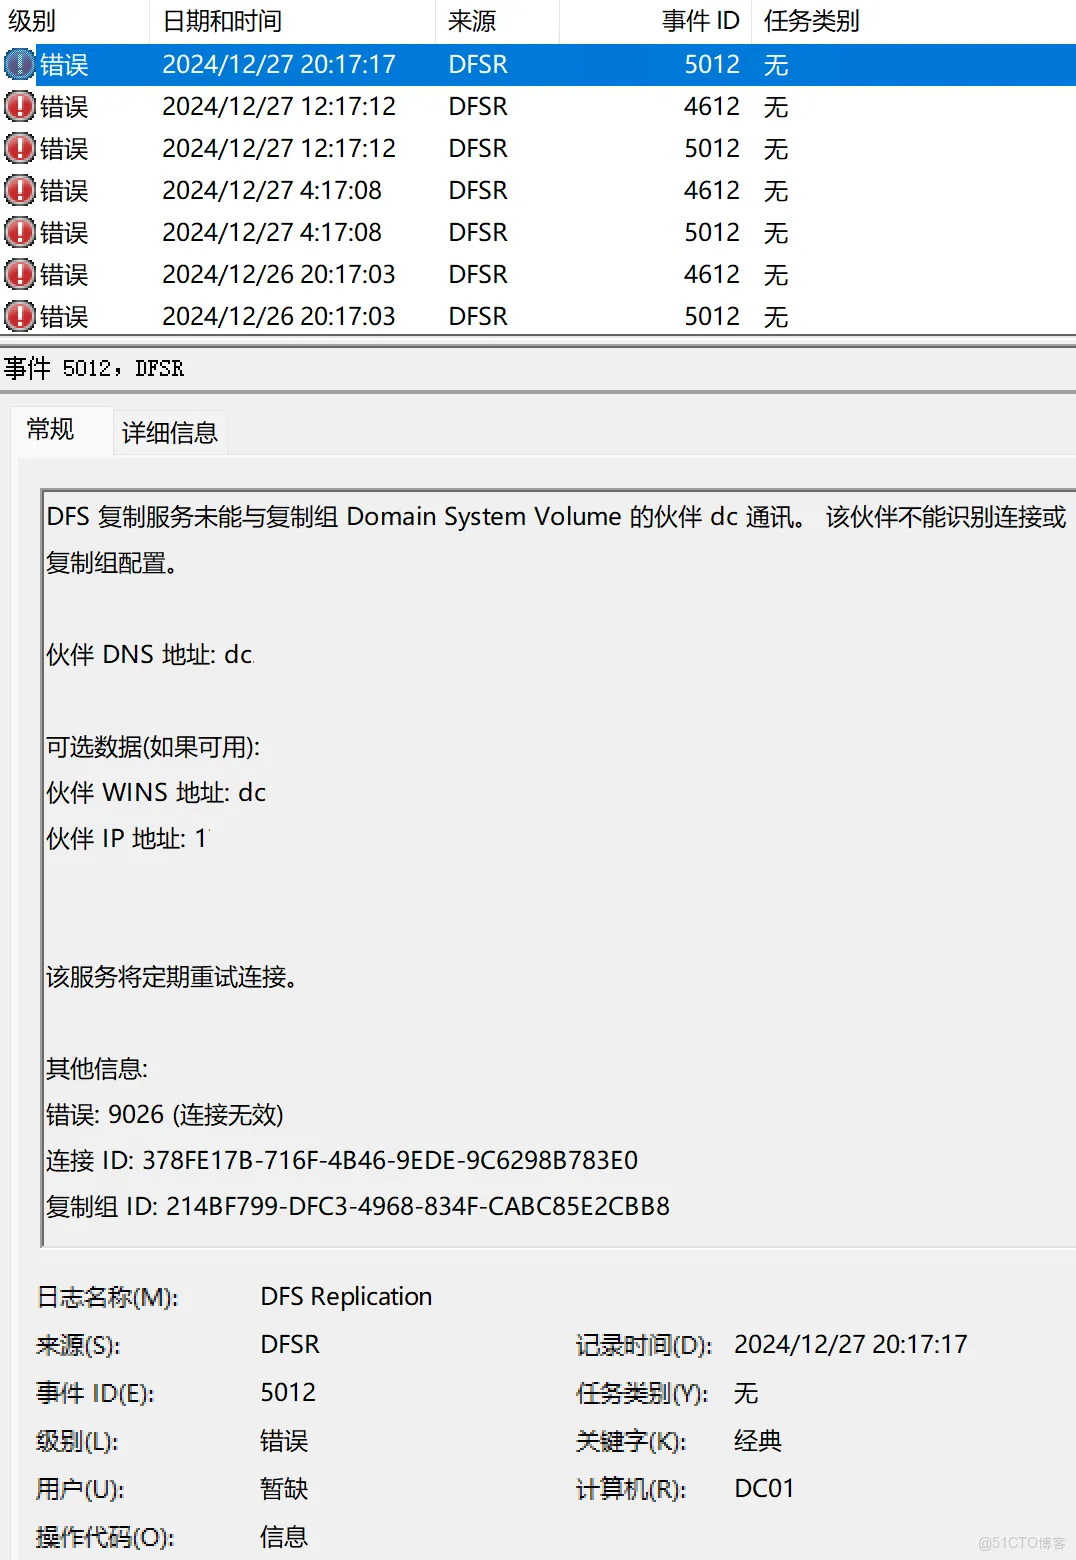](https://bost.lesrec.cn/uploads/images/gallery/2025-10/iKni4xkaTqAzQfbY-101.png)
事件ID:4612
[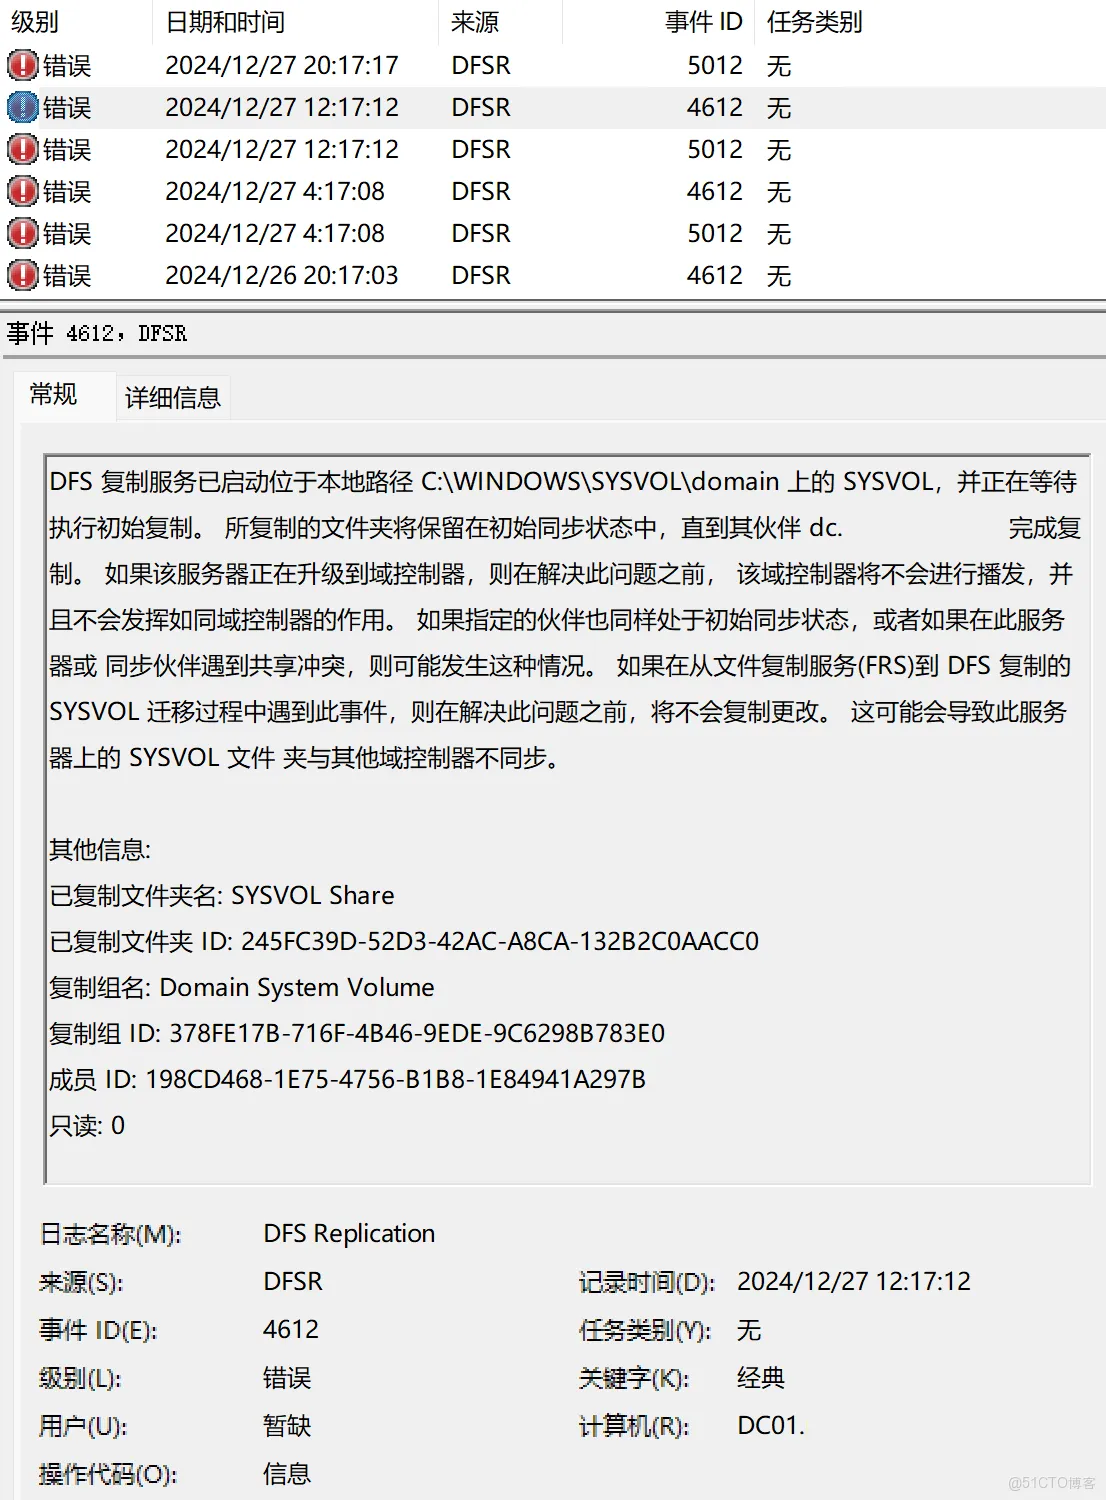](https://bost.lesrec.cn/uploads/images/gallery/2025-10/ASzSHSug7pxxFieR-102.png)
 错误影响:升级完成后的DC01,没有共享出SYSVOL目录,客户端计算机读取失败。事件ID 4612表明正在玩命从已经退役的DC上复制数据,可以确认的是ntds数据库中,元数据已经没有DC这台域控制器了。下面是微软对新升级的域控制器在完成 DCpromo 后可能无法播发的一个排错思路,然并卵。非要说有什么参考意义,就是其中提到了源域控制器“父计算机”注册表项。
[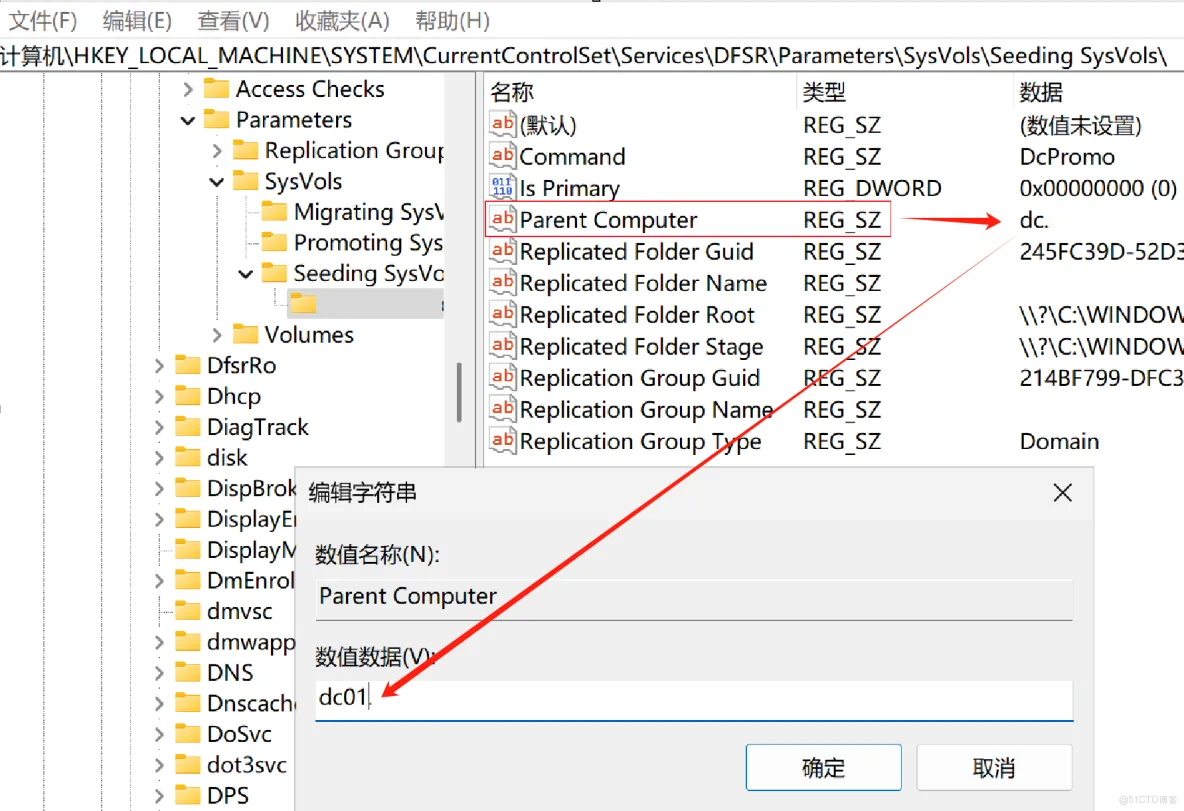](https://bost.lesrec.cn/uploads/images/gallery/2025-10/hibapgXaRrlWdCpB-103.png)

[ 新升级的域控制器在完成 DCpromo 后可能无法播发 - Windows Server | Microsoft Learn](https://learn.microsoft.com/zh-cn/troubleshoot/windows-server/active-directory/newly-promoted-domain-controller-fail-advertise)
原因分析:DFSR 执行 SYSVOL 数据的权威同步,这些数据在 DC 之间复制,DC 上必须存在的 SYSVOL 文件夹层次结构,用于存储两组重要数据:
1、组策略模板文件:它们存储在 \\\\SYSVOL\\<domain>\\Policies 下的单独文件夹中。
2、域中计算机使用的登录、注销、启动和关闭脚本:它们存储在 \\\\SYSVOL\\<domain>\\scripts 中。脚本文件夹本身作为 NETLOGON 共享。
微软有提到:
[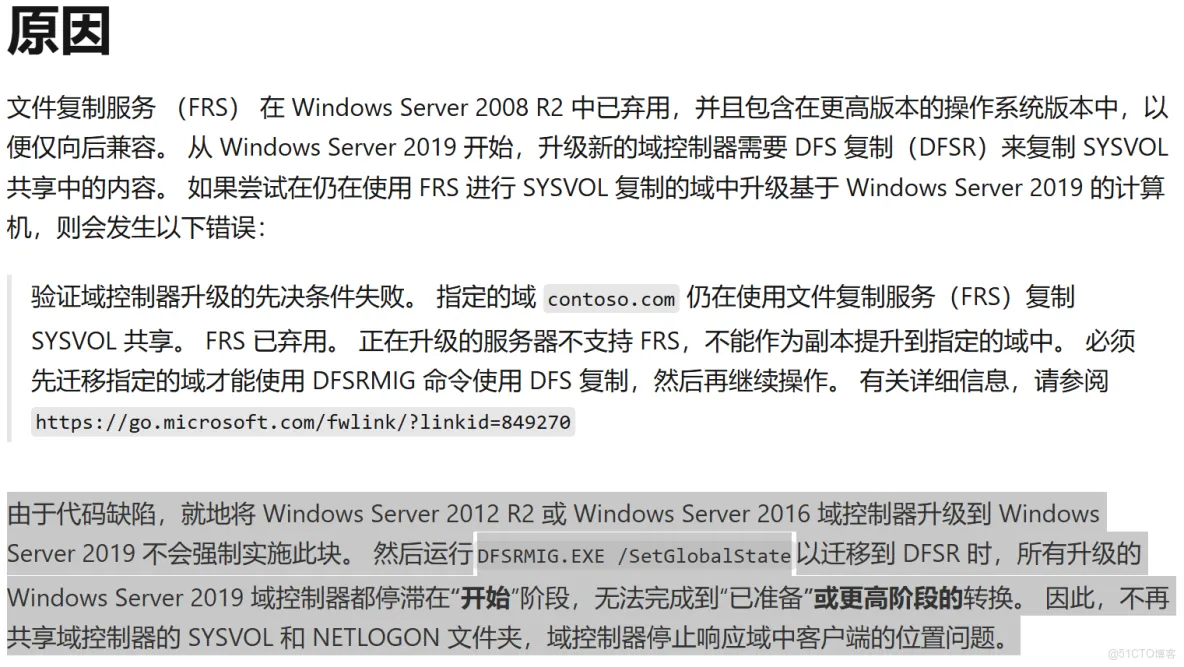](https://bost.lesrec.cn/uploads/images/gallery/2025-10/KJEqwBlJRtT9diFo-104.png)
 题外话:这里需要厘清一个概念,SYSVOL 复制与 Active Directory 复制是分开进行的两码事。一个可能正常,而另一个可能会失败。 Active Directory 复制情况可以使用repadmin检查,如repadmin /showrepl。因生产环境不方便贴图,读者请自行尝试或者脑补,可以确认的是,本环境中Active Directory 复制完全正常,dfsdiag /testdcs检查复制状态也都是一致的:
[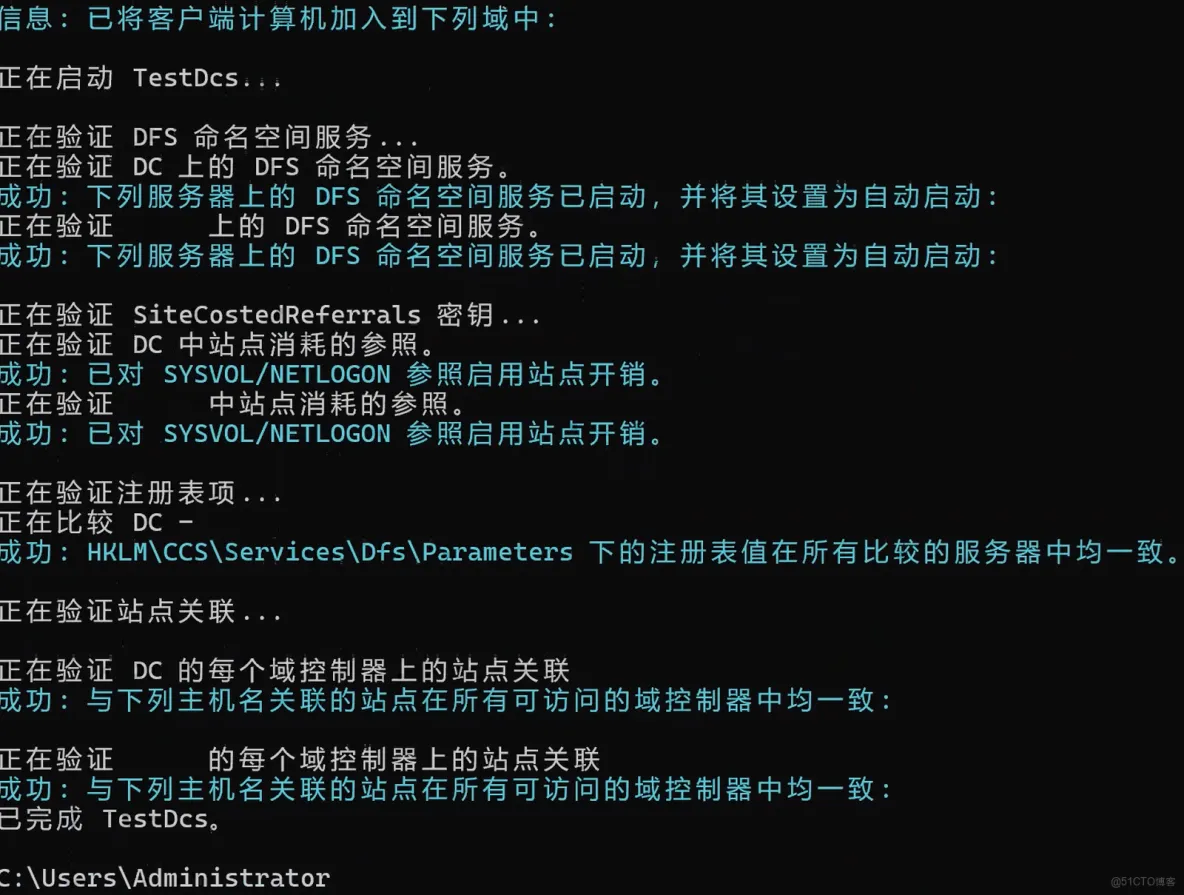](https://bost.lesrec.cn/uploads/images/gallery/2025-10/3qTBTBtpwrAQk9G9-105.png)
 奇怪的是,SYSVOL文件夹下面的数据,并不会被同步到副本DC。承担FSMO的域控制器不能正常播发,如果SYSVOL 复制一直失败,不进行手动干预解决,后面可能会无法恢复,甚至造成灾难性后果。
解决方案:升级AD前,我们备份好了SYSVOL文件夹。将其还原至DC01同位置,然后指定DC01 作为权威机构,让DFSR 使用 DC01 自己的 SYSVOL 数据副本初始化 SYSVOL成为域的 SYSVOL 源拷贝从而进行授权同步。
[ 强制同步分布式文件系统复制 (DFSR) 复制的 sysvol 复制 - Windows Server | Microsoft Learn](https://learn.microsoft.com/zh-cn/troubleshoot/windows-server/group-policy/force-authoritative-non-authoritative-synchronization)
参考微软的链接,以下为实现步骤:
1、在承担FSMO的DC01 上,adsiedit.msc启动 ADSI 编辑控制台,连接到默认命名上下文,展开到DC=domain > OU=Domain Controllers,所有的域控制器都将出现在这里。继续展开承担FSMO的DC01,CN=DC01 > CN=DFSR-LocalSettings > CN=Domain System Volume;
[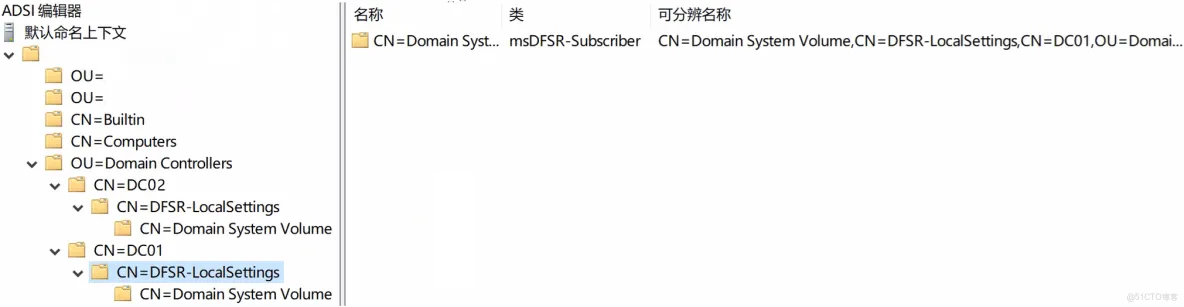](https://bost.lesrec.cn/uploads/images/gallery/2025-10/A2HreE4uJamAQoVe-106.png)
 2、右键单击 CN=SYSVOL Subscription ,然后选择属性。弹出的窗口中双击“msDFSR-Enabled”属性并将其值设置为 FALSE。双击”msDFSR-Options“属性并将其值设置为 1。 单击”确定“关闭属性窗口;
[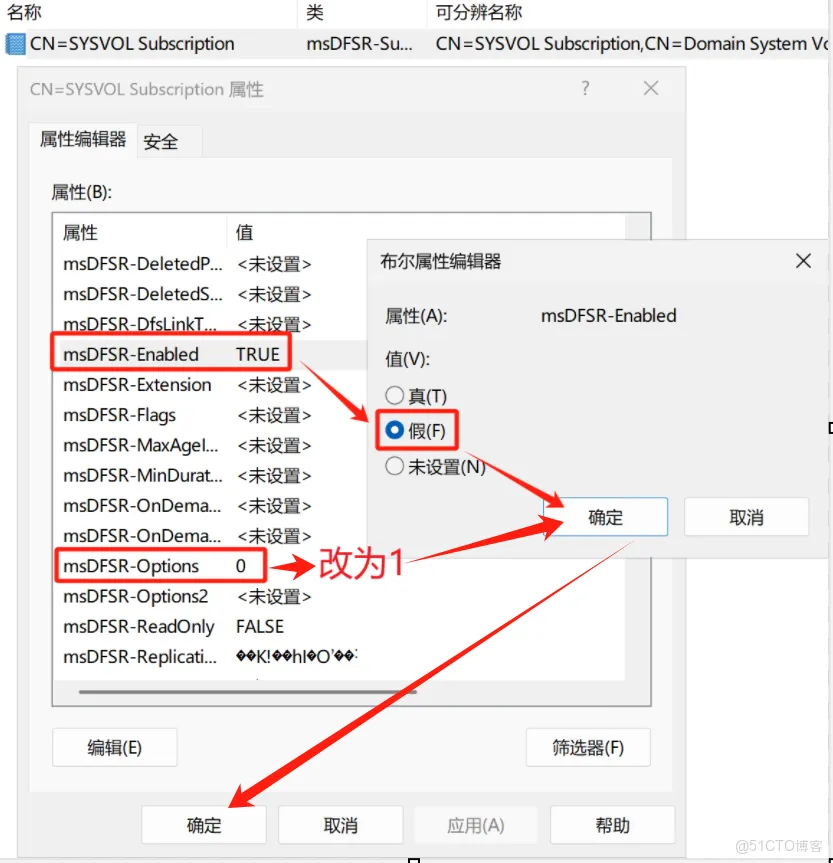](https://bost.lesrec.cn/uploads/images/gallery/2025-10/joTk1Njh8OpPzys0-107.png)
 3、同样方法,展开其余每一个DC 的 CN=SYSVOL Subscription属性,修改”msDFSR-Enabled“属性,设置为”FALSE”;
[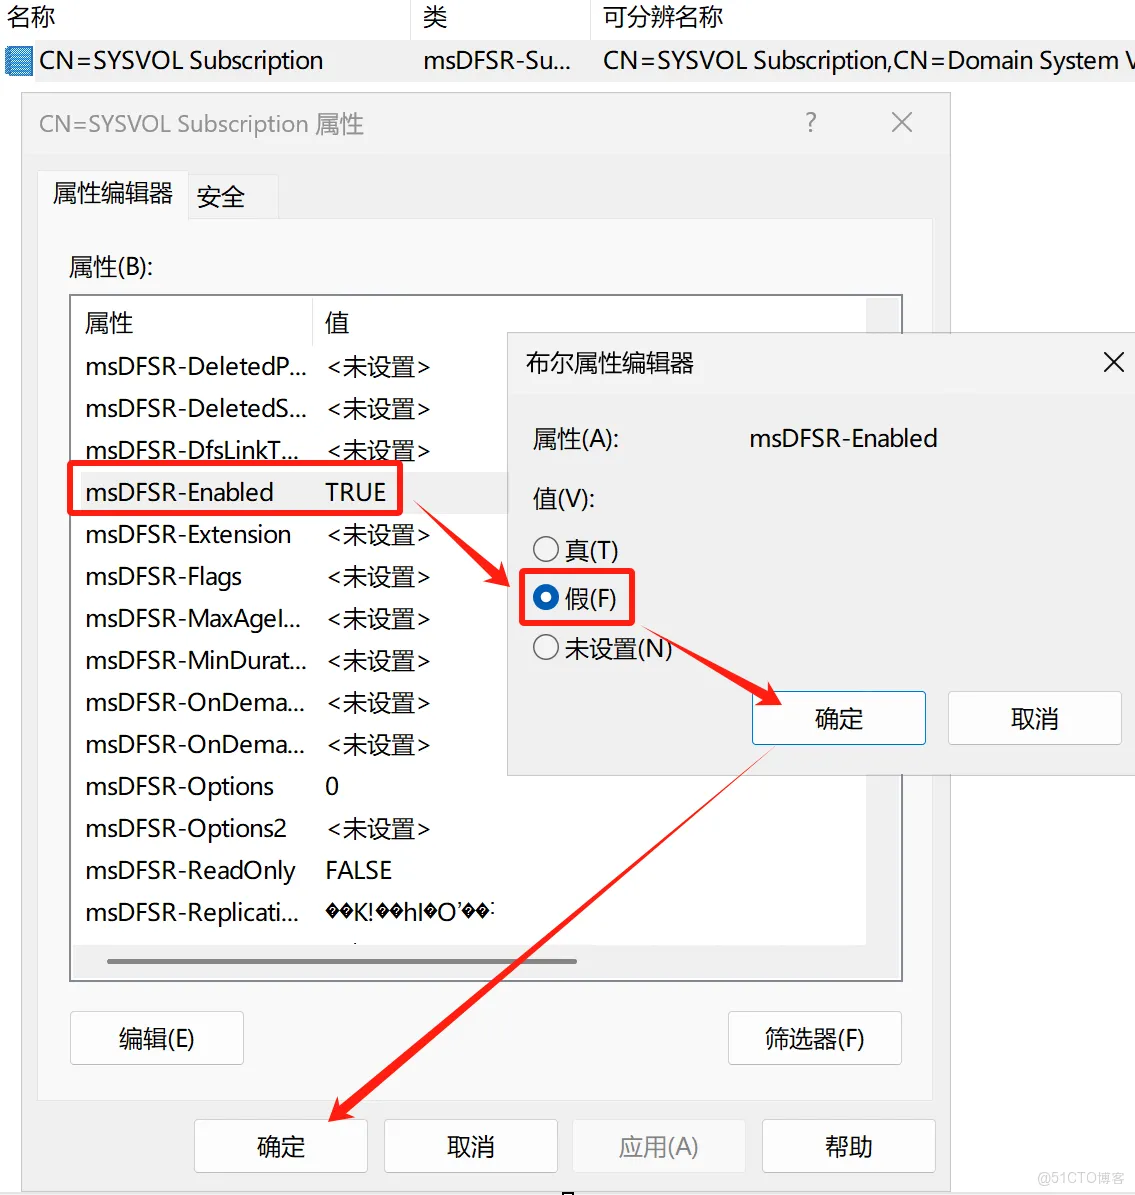](https://bost.lesrec.cn/uploads/images/gallery/2025-10/hOgUjw1IaXUlKF48-108.png)
 4、先额外DC,再权威 DC(FSMO DC,本文DC01),运行repadmin /syncall /force强制在整个域中复制 Active Directory。这可能需要一些时间,也许要15分钟或更久,具体取决于域的大小和复制拓扑;
5、等上足够时间后,在每个额外DC 上,运行 dfsrdiag pollad。在权威 DC上,启动事件查看器并确认事件日志包含事件 4114,表示不再复制 SYSVOL,此事件将出现在所有 DC 上;
[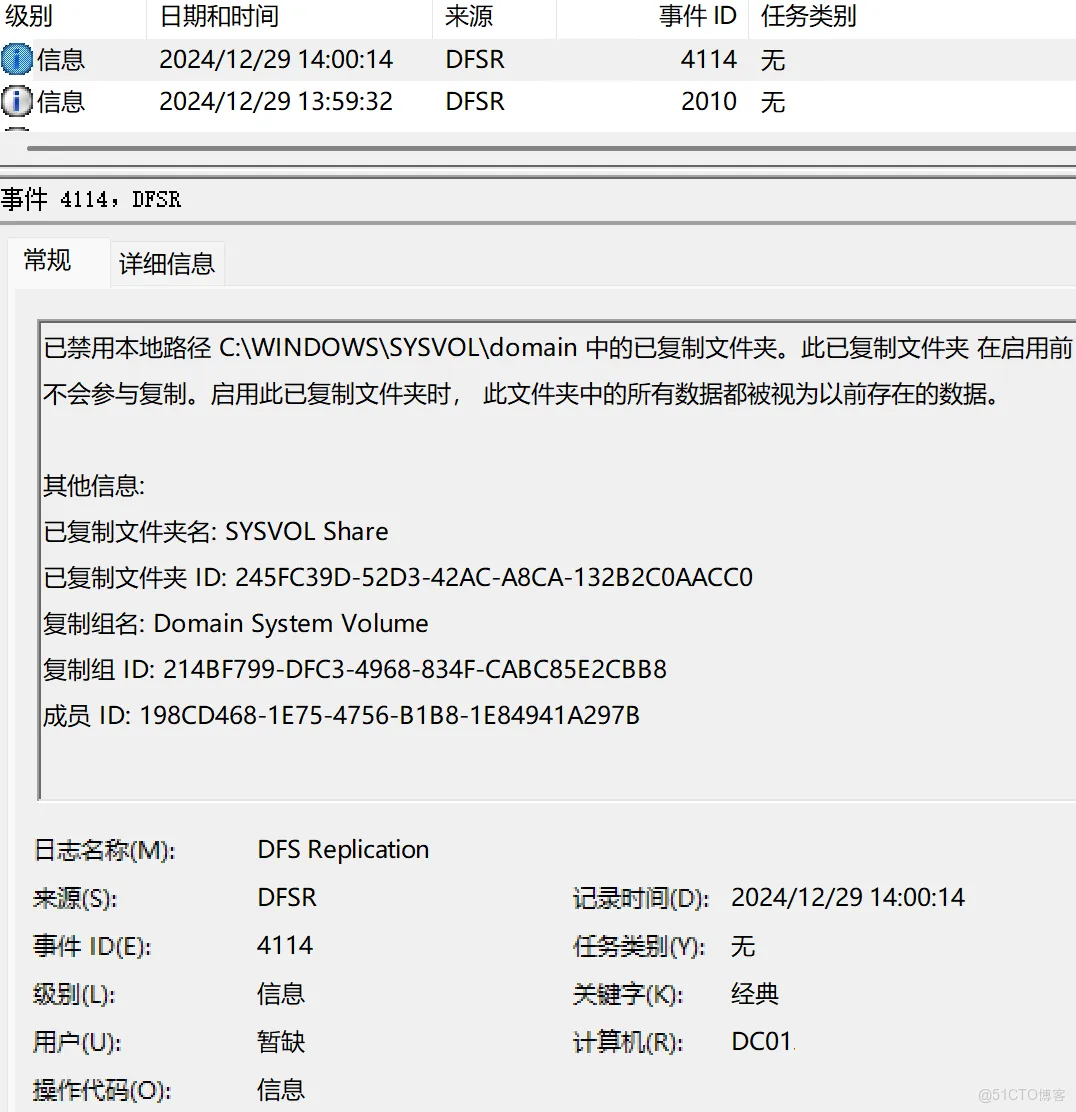](https://bost.lesrec.cn/uploads/images/gallery/2025-10/2szve5ibj24evQj1-109.png)
 6、在权威域控制器上ADSI 编辑控制台中,浏览到步骤 3 中的位置,将权威域控制器“msDFSR-Enabled”属性值从“FALSE”设置为“TURE”;
[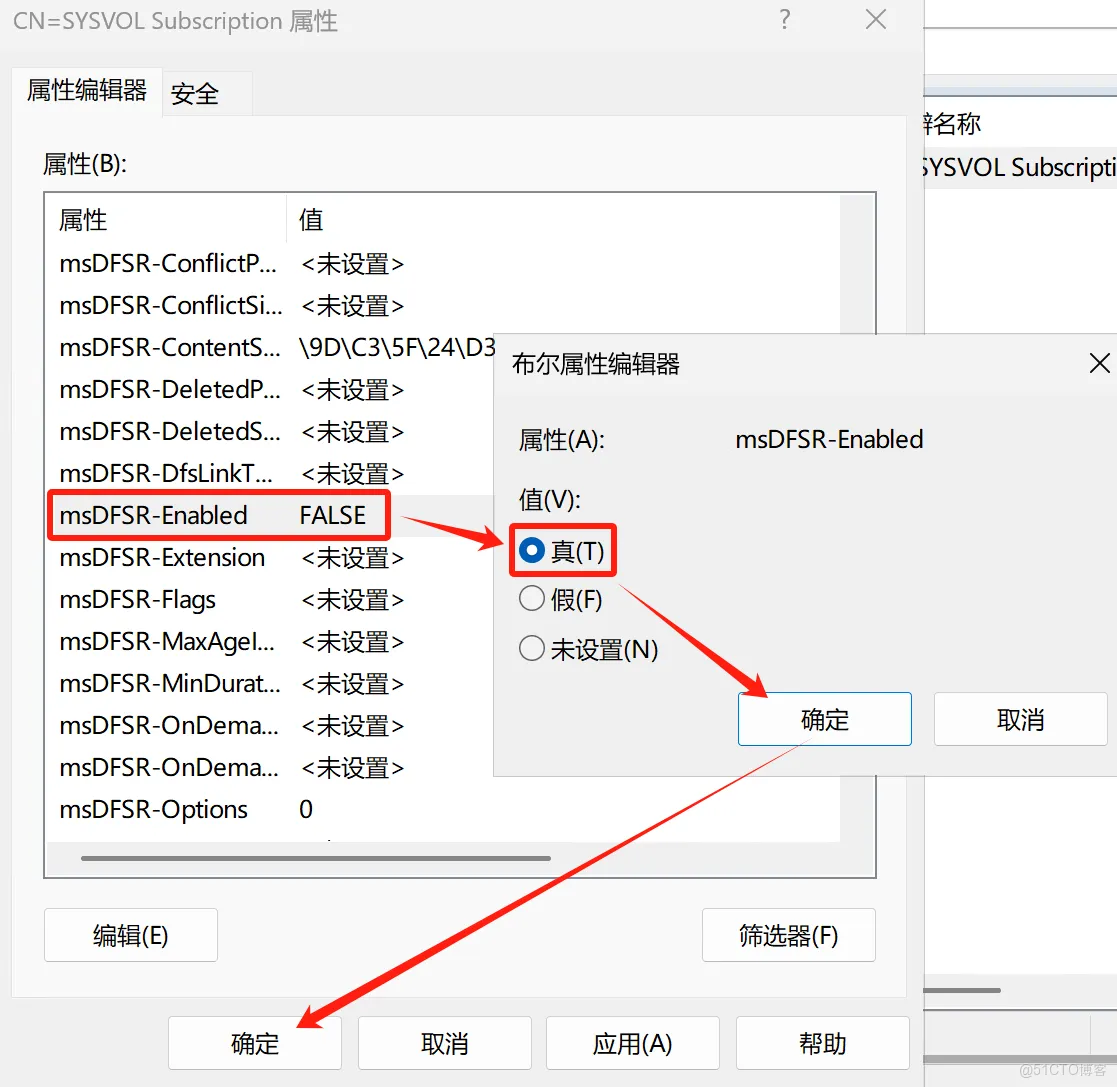](https://bost.lesrec.cn/uploads/images/gallery/2025-10/n0LpIhzXbmnvAmff-110.png)
 7、权威域控制器上运行dfsrdiag pollad,启动事件查看器并确认事件日志包含事件4602,此事件确认此域控制器上已发生 SYSVOL 的权威同步;
[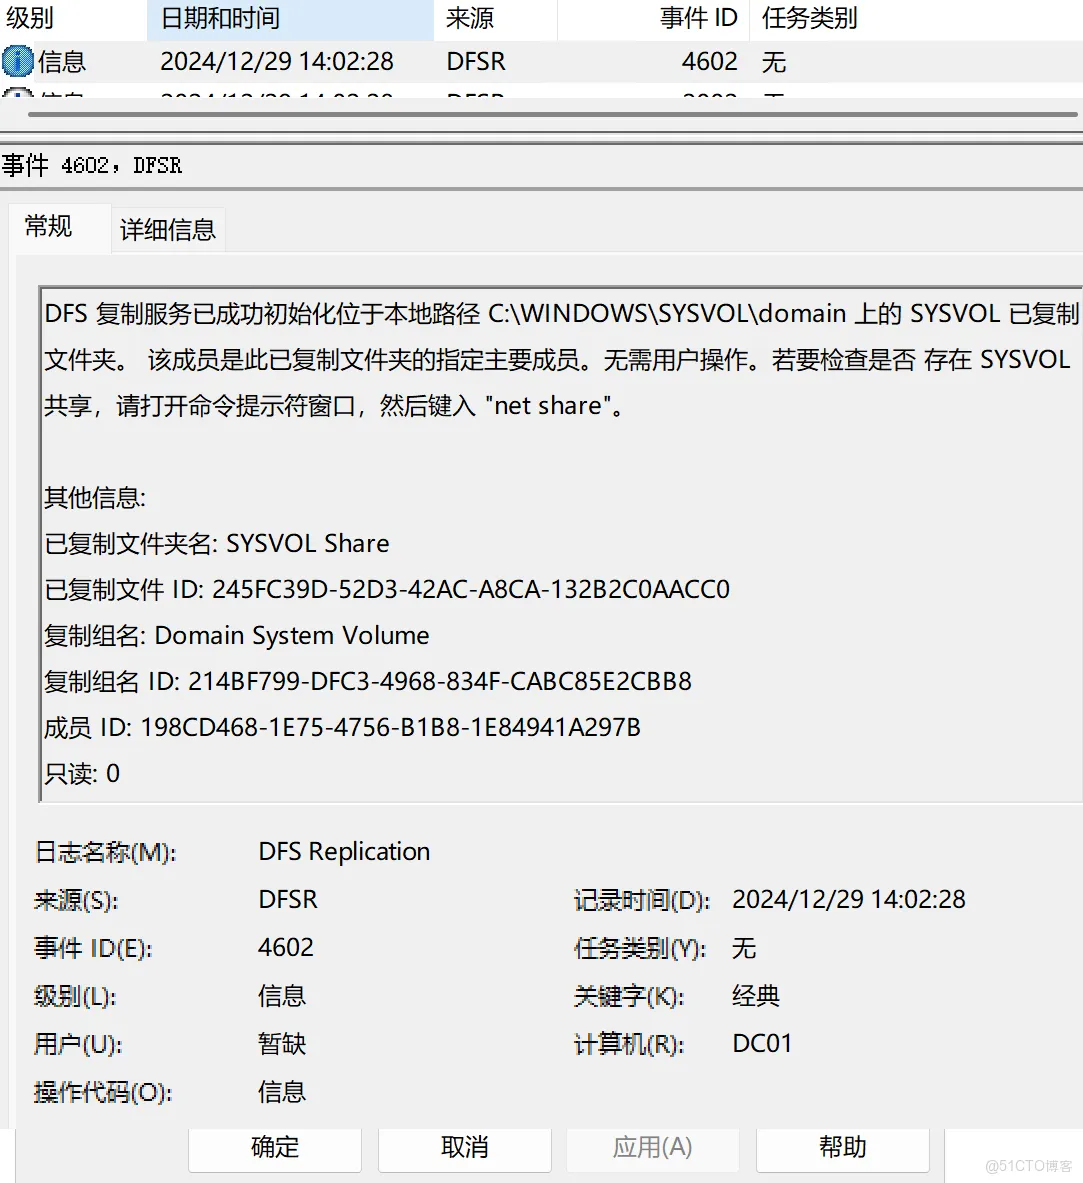](https://bost.lesrec.cn/uploads/images/gallery/2025-10/LlJ4nMlqHucBemCf-111.png)
 8、将所有DC 的“msDFSR-Enabled”属性设置为“TRUE”,并强制在整个域中复制,最后在除权威 DC 以外的每个 DC 上,运行一次dfsrdiag pollad;
9、在非授权 DC 上,确认事件 4614 和 4604 出现在 DFS 复制事件日志中。
至此,排错完成。
Windows Server 2025 删除或修改了一些功能,现产品在实际应用中,比如LDAP/NLA/Time/DHCP/DNS/KLDC服务,对老旧架构的影响还是比较大的,不知道微软后续会不会做出改进?
# 检查及修复PDA DNS缺少SRV记录gc._msdcs.shuncom.local
根据你提供的 **PDC (S-DNS1)** dcdiag 测试结果,结合 repadmin 信息,可以总结如下:
---
## 🔹 主要现象
1. **警告信息**
```
DNS 服务器 192.168.0.5 上缺少 SRV 记录: _ldap._tcp.gc._msdcs.shuncom.local
DNS 服务器 192.168.0.5 上缺少 A 记录: gc._msdcs.shuncom.local
```
但随后又发现:
```
Matching SRV record found at DNS server 192.168.0.5: _gc._tcp.Default-First-Site-Name._sites.shuncom.local
Matching SRV record found at DNS server 192.168.0.5: _ldap._tcp.Default-First-Site-Name._sites.gc._msdcs.shuncom.local
```
说明:**缺少全局 GC 根域记录 (\_msdcs) 的警告**,但实际在站点范围内注册的 SRV 记录存在。
2. **Netlogon 和 SYSVOL**
- Netlogon 服务正常运行
- SYSVOL 正常
- 复制(repadmin /showrepl & /replsummary)没有失败
✅ 核心 AD 功能正常,PDC 与其他 DC(S-DNS6)之间复制无错误。
3. **DNS 测试**
- `dcdiag /test:dns` 显示 S-DNS1 基本功能正常,但 S-DNS1 的外部 RReg 检查失败
- S-DNS6 测试失败,说明其他 DC 的 DNS 注册存在轻微问题
4. **Authentication / Locator / FSMO / Intersite**
全部 PASS,说明客户端定位 DC 和 FSMO 角色查找均正常。
---
## 🔹 结论
1. **核心 AD 服务健康**
- 复制正常,FSMO 角色、GC、Netlogon、SYSVOL 都正常
- 客户端通过 LDAP/Kerberos 可以访问 DC
2. **警告原因**
- `_ldap._tcp.gc._msdcs.shuncom.local` 和 `gc._msdcs.shuncom.local` 缺失 → 属于 **全局 GC 根域记录**,可能是:
- Netlogon 注册时未同步 `_msdcs` 子域的 A/SRV 记录
- S-DNS1 可能曾经还原或重建过,导致 `_msdcs` 根域记录未动态注册
- 由于站点范围的 SRV 记录存在,所以绝大多数客户端不会受影响
3. **对业务影响**
- 警告不会影响现有 AD 功能
- 只有依赖 **全局 GC 根域记录** 的客户端查询(极少情况)可能收到延迟
---
## 🔹 建议修复步骤
为了消除警告和确保 `_msdcs` 记录完整:
1. **在 PDC 上强制 Netlogon 重新注册 SRV/A 记录**:
```powershell
net stop netlogon
ipconfig /flushdns
ipconfig /registerdns
net start netlogon
```
2. **检查 DNS 是否注册完整**:
```powershell
dcdiag /test:dns /v /s:S-DNS1.shuncom.local /DnsBasic
```
3. **可选:手动检查 `_msdcs` 区域**
在 DNS 管理器 → Forward Lookup Zones → `_msdcs.shuncom.local`,确认:
- A 记录:gc、PDC
- SRV 记录:\_ldap, \_kerberos, \_gc
4. **确认 S-DNS6 同步**
- S-DNS6 上 `_msdcs` 区域与 PDC `_msdcs` 区域一致
- 必要时在 S-DNS6 执行:
```powershell
repadmin /syncall /AeD
```
---
### 🔹 总结
- **核心问题**:PDC 上 `_msdcs` 根域 A/SRV 记录缺失 → 警告
- **AD 健康**:复制、Netlogon、SYSVOL、FSMO 全部正常 → 对业务影响小
- **推荐操作**:强制注册 DNS 记录 + 检查 `_msdcs` 区域
---
如果你需要,我可以帮你写一份 **一键刷新 `_msdcs` SRV/A 记录的操作脚本**,确保 PDC 和其他 DC 的 DNS 完全同步。
你希望我写吗?
# 磁盘I/O瓶颈检测实例
非常好的问题 👍。
在 **MySQL 从库(replica)写入非常慢** 的情况下,最关键是区分问题出在:
> 💡 是 **MySQL 层复制线程延迟**?
> 还是 **系统层磁盘/IO瓶颈**?
> 还是 **InnoDB flush / fsync 压力**?
下面我帮你分阶段系统地分析和排查 —— 这套方法是运维工程师在生产环境常用的标准步骤。
---
## 🧩 一、明确现象
你提到的“**从库写入非常缓慢**”通常表现为:
- `Seconds_Behind_Master` 持续增长;
- `Relay_Log_Space` 增长快、`Exec_Master_Log_Pos` 落后;
- 磁盘 IO 高、%util 高;
- CPU 并不高。
---
## 🧱 二、定位 MySQL 层延迟来源
### 1️⃣ 查看复制线程状态
```sql
SHOW SLAVE STATUS\G
```
重点关注以下字段:
| 字段 | 含义 | 分析 |
|---|
| **Seconds\_Behind\_Master** | 延迟秒数 | 持续增长说明执行线程跟不上 |
| **Slave\_IO\_Running / Slave\_SQL\_Running** | 是否正常 | 若任一为 No,说明复制中断 |
| **Read\_Master\_Log\_Pos / Exec\_Master\_Log\_Pos** | 差距 | 差距大说明 SQL 执行太慢 |
| **Relay\_Log\_Space** | relay log 累积量 | 快速增加表示写入落后 |
**结论:**
如果 IO 正常但延迟高 → SQL 执行线程(SQL\_THREAD)慢;
如果 relay log 写入慢 → IO\_THREAD 或磁盘 I/O 慢。
---
## ⚙️ 三、查看执行线程压力
### 2️⃣ 查看 SQL\_THREAD 当前执行情况
```sql
SHOW PROCESSLIST;
```
- 如果看到大量 `"Update"`, `"Insert"` 在执行,说明复制 SQL 正在重放大量事务;
- 若状态常停留在 `"Waiting for semi-sync ACK"` → 主从半同步阻塞;
- 若 `"Waiting for master to send event"` → 主库发送慢或网络慢;
- 若 `"Reading event from the relay log"` 长时间存在 → 从库磁盘IO瓶颈。
---
## 🔍 四、系统层面 I/O 性能分析
### 3️⃣ 运行 iostat 检查磁盘状态
```bash
iostat -dxm 1 10
```
关注:
- `%util` > 90%:磁盘已饱和;
- `w_await` > 5~10ms:写入延迟高;
- `r/s`, `w/s` 持续高:I/O 并发大。
> 你前面贴的 sdb 数据中 `%util` 达 95%,`w_await=2.5ms`,说明 I/O 已满载但还算快(可能是 HDD)。
---
### 4️⃣ 使用 iotop 查看写入源
```bash
iotop -oPa
```
如果看到:
```
mysqld --defaults-file=/etc/my.cnf
[jbd2/sdb1-8]
```
→ 说明 MySQL 正在大量刷写磁盘 + 文件系统 journaling 压力大。
---
## 💽 五、InnoDB 层瓶颈分析
### 5️⃣ 查看 InnoDB 内部状态
```sql
SHOW ENGINE INNODB STATUS\G
```
关注关键段:
- **Log sequence number / Log flushed up to**
- 如果两者差距大,说明日志 flush 不及时;
- **Pending writes** / **OS file reads/writes**
- 若 pending writes 很多,说明磁盘写跟不上;
- **Buffer pool hit rate**
- 若低于 99%,说明内存不足导致频繁 I/O。
---
## 🧠 六、系统参数层面分析
### 6️⃣ 确认文件系统挂载参数
```bash
mount | grep sdb
```
`relatime, data=ordered` → 安全但写入性能差。
建议修改为:
```bash
noatime,nodiratime,data=writeback
```
### 7️⃣ 检查磁盘类型
```bash
lsblk -d -o NAME,ROTA
```
- ROTA=1 → 机械盘;
- ROTA=0 → SSD。
HDD 在高写入量(relay log replay)时通常无法承受持续 fsync。
---
## 🚀 七、针对从库写慢的优化方向
| 优化方向 | 配置项 | 建议值 | 说明 |
|---|
| 日志刷新频率 | `innodb_flush_log_at_trx_commit` | 2 | 异步写,显著降低 I/O |
| 二进制日志同步 | `sync_binlog` | 0 | 延迟写,减少 fsync |
| InnoDB 缓冲区 | `innodb_buffer_pool_size` | 内存 60%–70% | 减少物理 I/O |
| InnoDB 日志文件 | `innodb_log_file_size` | ≥512M | 减少 checkpoint flush |
| 文件系统 | ext4 | `noatime,nodiratime,data=writeback` | 减少 metadata 写入 |
| I/O 调度器 | `mq-deadline` | | 更适合数据库随机 I/O |
| 从库延迟处理 | `slave_parallel_workers` | ≥4(MySQL5.7+) | 启用多线程复制 |
---
## 🔧 八、实用排查命令小结
| 场景 | 命令 |
|---|
| 查看复制延迟 | `SHOW SLAVE STATUS\G` |
| 查看磁盘I/O延迟 | `iostat -dxm 1` |
| 查看写入来源 | `iotop -oPa` |
| 查看InnoDB flush状态 | `SHOW ENGINE INNODB STATUS\G` |
| 查看内核磁盘调度器 | `cat /sys/block/sdb/queue/scheduler` |
| 检查读写命中率 | `SHOW GLOBAL STATUS LIKE 'Innodb_buffer_pool%';` |
---
## ✅ 九、总结结论
| 层面 | 是否可能瓶颈 | 检测方法 |
|---|
| MySQL复制线程 | ✅ | `SHOW SLAVE STATUS` |
| 磁盘I/O | ✅(从前面%util=95%看) | `iostat` / `iotop` |
| InnoDB flush | ✅ | `SHOW ENGINE INNODB STATUS` |
| 网络 | ❌(仅IO慢,不影响relay下载) | — |
🟢 **初步判断:**
你的从库 I/O 已经接近瓶颈(磁盘利用率高、ext4 journaling 占用高),再叠加 MySQL 同步刷盘策略(默认同步写) → 导致复制延迟与写入缓慢。
---
非常好,这份 `iostat` 输出对分析瓶颈很有帮助。
我们可以看到你从库的关键磁盘设备是 **sdb**,它承担了主要的写入负载。
让我们来一步步分析。
---
### 🔍 一、关键指标解读(针对 sdb)
| 指标 | 含义 | 当前值 | 说明 |
|---|
| `%util` | 设备利用率 | **94–96%** | 接近满载,磁盘写 I/O 饱和,是主要瓶颈! |
| `w/s` | 每秒写请求数 | 约 **370–380** | 写入频繁,符合从库持续接收 binlog 的特征 |
| `wMB/s` | 每秒写入量 | 约 **2.8–3.0 MB/s** | 吞吐量不算高,但已让设备饱和,说明磁盘性能较弱(可能是 SATA HDD) |
| `w_await` | 写请求平均等待时间 | **2.5–2.7 ms** | 单次写延迟还可以,但持续高负载下会拖慢事务提交 |
| `wrqm/s` | 合并写请求数 | **约 300/s** | 系统正在努力合并写请求(说明写队列很长) |
| `aqu-sz` | 平均等待队列长度 | **约 1.0** | 队列中一直有请求在等待 |
📊 **结论:**
> sdb 磁盘 I/O 已成为瓶颈,MySQL 从库的写入(relay log 应用)被 I/O 阻塞导致写入速度慢。
---
### ⚙️ 二、进一步确认瓶颈原因的方向
#### 1️⃣ 检查 MySQL 层写入延迟来源
执行:
```sql
SHOW SLAVE STATUS\G
```
重点关注:
- `Seconds_Behind_Master` —— 延迟秒数
- `Slave_IO_Running` / `Slave_SQL_Running` —— 是否都为 Yes
- `Relay_Log_Space` —— relay log 占用空间是否持续增长
如果 **IO线程正常但SQL线程延迟大**,说明是从库执行慢(即 I/O 或写入性能不足)。
---
#### 2️⃣ 检查 MySQL 的 InnoDB 写入行为
```sql
SHOW ENGINE INNODB STATUS\G
```
查看以下字段:
- `Log sequence number` 与 `Last checkpoint at` 差值是否过大 → 表示刷盘太慢
- `I/O thread`、`pending writes` 是否积压
- `Buffer pool` 命中率、`Dirty pages` 比例是否过高
---
#### 3️⃣ 检查系统层 I/O 能力
可以用以下命令测试:
```bash
fio --name=write_test --filename=/home/shuncom/mysql/data/testfile --size=2G --bs=16k --rw=write --ioengine=libaio --direct=1 --numjobs=1 --runtime=60 --group_reporting
```
这可以测试裸写性能(MB/s 与 IOPS),确认磁盘性能是否太弱。
---
### 🧠 三、可能的优化建议
#### 🧩 1. MySQL 参数优化
在 `/etc/mysql/mysql.conf.d/mysqld.cnf` 或 `/etc/my.cnf`:
```ini
innodb_flush_log_at_trx_commit = 2
sync_binlog = 0
innodb_doublewrite = 0
innodb_flush_method = O_DIRECT
```
> ⚠️ 这些设置会降低数据持久性,但在从库(可重建)上可安全启用,大幅提升写入速度。
#### 🧩 2. Relay log 与数据文件分盘
如果可能,将:
- `/var/lib/mysql`(数据目录)
- `relay-log`(中继日志)
放在不同磁盘(或 SSD)上,减少写竞争。
#### 🧩 3. 文件系统/内核优化
```bash
mount -o noatime,nodiratime,barrier=0 /dev/sdb /home/shuncom/mysql/data
```
并调整 I/O 调度器:
```bash
cat /sys/block/sdb/queue/scheduler
echo deadline > /sys/block/sdb/queue/scheduler
```
#### 🧩 4. 硬件方向
如果是机械盘(HDD),强烈建议迁移到 SSD 或 NVMe,从库写入性能会提升 5~10 倍。
---
### ✅ 四、下一步建议
请提供以下补充信息,我可以帮你进一步定位:
1. `SHOW SLAVE STATUS\G` 输出
2. `SHOW ENGINE INNODB STATUS\G` 中 “Log sequence number” 部分
3. `lsblk` 或 `df -h` 输出(确认 sdb 是否单盘)
4. MySQL 的 `innodb_flush_log_at_trx_commit` 当前设置值
---
非常好,这份 `SHOW SLAVE STATUS\G` 信息非常关键。
我们可以据此确认你的 **从库复制延迟和写入瓶颈的根本原因**。
下面是详细分析 👇
---
## 🧩 一、核心状态总结
| 项目 | 当前值 | 说明 |
|---|
| **Slave\_IO\_Running** | Yes | 从库能正常接收主库 binlog |
| **Slave\_SQL\_Running** | Yes | SQL 线程正在执行 relay log |
| **Slave\_SQL\_Running\_State** | `waiting for handler commit` | SQL 线程正在等待事务提交(commit),通常表示磁盘 fsync 慢 |
| **Seconds\_Behind\_Master** | **5,495,423 秒 (~63 天)** 😱 | 严重复制延迟,SQL 线程远远落后主库 |
| **Relay\_Log\_Space** | **618,787,289,903 bytes (~576 GB)** | Relay log 已积压约 576GB 数据 |
| **Read\_Master\_Log\_Pos vs Exec\_Master\_Log\_Pos** | 差距约 50GB+ | SQL 线程执行明显跟不上 |
| **SQL\_Delay** | 3600 | 配置了 1 小时延迟复制(手动延迟),但当前延迟远超预期,说明性能瓶颈 |
| **Slave\_SQL\_Running\_State** | `waiting for handler commit` | **关键瓶颈点:I/O(fsync)或 InnoDB flush 慢** |
---
## 🚨 二、结论(瓶颈定位)
> ✅ 主从连接、网络、I/O 线程都正常;
> 🚫 SQL 执行线程(SQL\_THREAD)在持续阻塞于事务提交阶段;
> 💾 “waiting for handler commit” 几乎 100% 表示 **InnoDB 写入 + fsync 太慢**。
换句话说:
> **主库产生的 binlog 已经成功发送到从库,但从库磁盘性能不足以快速执行事务重放(apply relay log)**。
---
## ⚙️ 三、根本原因(结合你前面的 iostat)
- `iostat` 显示 sdb `%util≈95%` → 磁盘接近满载;
- `wMB/s≈2.8~3MB/s`,吞吐极低(正常 SSD 应达百MB/s);
- `[jbd2/sdb1-8]` 活跃说明 ext4 日志写入频繁;
- Relay log 积压 500+ GB;
- SQL\_THREAD “waiting for handler commit”。
🧠 综上:这是一个典型的 **磁盘 I/O 写入瓶颈导致复制重放卡顿** 的场景。
---
## 🧰 四、验证方式(你可以确认)
1️⃣ 查看正在执行的事务
```sql
SHOW PROCESSLIST;
```
你会看到一个或几个 `Slave_SQL` 线程长时间处于
`waiting for handler commit` 状态。
2️⃣ 查看 InnoDB flush 状态
```sql
SHOW ENGINE INNODB STATUS\G
```
在 “LOG” 段中如果看到:
```
Log sequence number .....
Log flushed up to .....
Last checkpoint at .....
```
如果前两者差距很大(几十MB~GB),说明刷盘跟不上。
---
## ⚙️ 五、优化方案(针对从库写入缓慢)
以下优化**专为从库环境**(无业务查询,只做复制):
### 🧩 1. 放宽刷盘策略(极大提升性能)
在 `/etc/mysql/mysql.conf.d/mysqld.cnf` 或 `/etc/my.cnf`:
```ini
[mysqld]
# 从库安全可放宽持久性
innodb_flush_log_at_trx_commit = 2
sync_binlog = 0
innodb_doublewrite = 0
innodb_flush_method = O_DIRECT
```
> ⚠️ 注意:这些参数可能在宕机时导致极小概率数据丢失,但对从库安全无影响(可重建)。
---
### 🧩 2. 优化文件系统挂载参数
查看:
```bash
mount | grep sdb
```
修改 `/etc/fstab`:
```bash
/dev/sdb1 /home ext4 defaults,noatime,nodiratime,barrier=0,data=writeback 0 2
```
然后:
```bash
mount -o remount /home
```
这将显著减少 journal 写入次数。
---
### 🧩 3. 确保使用合适的 I/O 调度器
```bash
cat /sys/block/sdb/queue/scheduler
echo deadline > /sys/block/sdb/queue/scheduler
```
或者在 `/etc/default/grub`:
```
GRUB_CMDLINE_LINUX_DEFAULT="quiet splash elevator=deadline"
update-grub && reboot
```
---
### 🧩 4. 检查 relay log 的位置和存储
Relay log 写入速度受磁盘影响,可迁移到更快的设备:
```ini
relay_log = /mnt/fastdisk/relay-log
relay_log_info_repository = TABLE
relay_log_recovery = ON
```
---
### 🧩 5. 启用多线程复制(MySQL 5.7+)
```sql
STOP SLAVE;
SET GLOBAL slave_parallel_workers = 8;
START SLAVE;
```
并确保配置文件中:
```ini
slave_parallel_type = LOGICAL_CLOCK
slave_parallel_workers = 8
```
> 从库可以同时重放多个事务,大幅减少延迟。
---
### 🧩 6. 如果是 HDD,建议:
- 迁移 relay log 到 SSD;
- 或将整个 MySQL 数据目录迁移至 SSD;
- 若仅机械盘可用,则尽量增加内存并扩大 `innodb_buffer_pool_size`(占总内存 60–70%)。
---
## ✅ 六、最终诊断结论表
| 层面 | 结论 | 建议 |
|---|
| 主从网络 | 正常 | 无需处理 |
| 从库 SQL 线程 | **waiting for handler commit** | I/O flush 太慢 |
| Relay log 积压 | 576GB | 表示从库执行落后 |
| 磁盘 I/O | **%util≈95%** | 已饱和,需优化或换 SSD |
| 参数 | 默认同步写 | 改为异步写(见上配置) |
---
是否方便我帮你生成一个
**MySQL 从库性能诊断脚本(shell + SQL 一体化)**?
执行后可直接输出:
- 当前复制延迟
- I/O 状态
- relay log 大小
- InnoDB flush 情况
- 并给出针对你机器的优化建议。
非常好,这一整段信息已经足够定位 **MySQL 从库延迟、写入慢** 的瓶颈核心。
我来帮你一步步分析——当前你的从库的主要瓶颈在 **InnoDB I/O(磁盘刷新)+ replication SQL thread 提交阶段(fsync等待)**。
---
## 🔍 一、关键现象总结
| 指标 | 当前状态 | 分析 |
|---|
| `Seconds_Behind_Master: 5495423` | 延迟约 **63 天** | 从库严重落后主库,IO线程正常,SQL线程在等待提交 |
| `Slave_SQL_Running_State: waiting for handler commit` | SQL线程在等待事务提交(fsync) | 表示 I/O 写入或事务提交极慢 |
| `Pending flushes (fsync) log: 1; buffer pool: 97886` | **fsync 队列高达 97,886** | 明确的磁盘 I/O 瓶颈信号 |
| `OS file writes: 8,575,785,215` | 写入量非常高 | 从库正在不断尝试追主 |
| `Log flushed up to` 落后 `Added dirty pages up to` | log buffer flush不及时 | redo 日志同步慢 |
| `jbd2/sdb1-8` 占用高 I/O | ext4 日志层卡顿 | 文件系统同步提交太频繁 |
---
## 🧠 二、瓶颈核心机制
在 MySQL 复制中,从库执行 SQL 日志时会:
1. 每个事务执行完 → 提交 (`commit`)
2. InnoDB 会执行一次 `fsync()`,将 redo log 写入磁盘
3. 如果磁盘 I/O 太慢,SQL 线程就会卡在 “waiting for handler commit”
也就是:
> **redo log 写入(fsync)阻塞了复制 SQL 线程 → 导致延迟越来越大。**
---
## 📉 三、验证瓶颈的命令
在从库上继续执行几条命令,可以确认是 fsync 阻塞:
```bash
# 查看磁盘 I/O 等待时间
iostat -x 1 10
# 如果 %util 长期接近100%,await 很高(>20ms)说明磁盘性能不足
# 查看 InnoDB 等待fsync线程
mysql> SHOW ENGINE INNODB STATUS\G | grep -i 'Pending flushes'
```
---
## ⚙️ 四、性能优化方向
### ✅ 1. 确认磁盘类型
执行:
```bash
lsblk -d -o NAME,ROTA,MODEL
```
- ROTA=1 → 机械盘(HDD)
- ROTA=0 → SSD
如果是 HDD,fsync 性能极差(每秒几十次提交就会卡)。
👉 **建议将 MySQL 数据目录 `/home/shuncom/mysql/data` 挂载到 SSD。**
---
### ✅ 2. InnoDB 日志参数优化
修改 `/etc/my.cnf`:
```ini
[mysqld]
innodb_flush_log_at_trx_commit = 2
sync_binlog = 0
innodb_flush_method = O_DIRECT
innodb_io_capacity = 2000
innodb_io_capacity_max = 4000
```
说明:
| 参数 | 含义 | 建议值 |
|---|
| `innodb_flush_log_at_trx_commit` | 控制redo log的同步策略 | 改为 2,表示每秒flush一次,不每次commit都flush |
| `sync_binlog` | 控制binlog同步磁盘 | 从库可设为0 |
| `innodb_flush_method` | 控制I/O方式 | `O_DIRECT` 避免双缓存 |
| `innodb_io_capacity(_max)` | I/O调度参数 | 适当提高,让后台线程更积极flush |
重启 MySQL 或执行:
```bash
SET GLOBAL innodb_flush_log_at_trx_commit=2;
```
---
### ✅ 3. 禁用从库的 binlog
如果你不需要从库再复制给其他节点:
```ini
[mysqld]
log_bin = 0
```
或临时关闭:
```sql
STOP SLAVE;
SET GLOBAL SQL_LOG_BIN=0;
START SLAVE;
```
---
### ✅ 4. 检查文件系统 mount 参数
你的 mount 显示:
```
/dev/sdb1 on /home type ext4 (rw,nosuid,nodev,relatime,data=ordered)
```
`data=ordered` 模式下,**ext4会在每次commit时强制flush**。可以考虑改为:
```
data=writeback,noatime,nodiratime,barrier=0
```
示例:
```bash
mount -o remount,noatime,nodiratime,data=writeback,barrier=0 /home
```
> ⚠️ 注意:需要确保有UPS电源,barrier=0在断电时可能丢事务。
---
### ✅ 5. 延迟复制调节(如果主从差距太大)
如果延迟太大,MySQL写不过来,可以先暂停 SQL 线程,让磁盘清理 backlog:
```sql
STOP SLAVE SQL_THREAD;
-- 等I/O恢复正常后
START SLAVE SQL_THREAD;
```
---
## 📊 五、快速判定是否恢复
之后再观察:
```sql
SHOW SLAVE STATUS\G
SHOW ENGINE INNODB STATUS\G
```
重点:
- `Seconds_Behind_Master` 下降
- `Slave_SQL_Running_State` 不再是 *waiting for handler commit*
- `Pending flushes` 数量持续减少
---
## ✅ 六、总结方案优先级
| 优先级 | 操作 | 说明 |
|---|
| ⭐⭐⭐⭐ | 将 MySQL 数据目录迁移到 SSD | 根本解决 I/O 瓶颈 |
| ⭐⭐⭐ | 调整 `innodb_flush_log_at_trx_commit=2` + `sync_binlog=0` | 立即提升写入速度 |
| ⭐⭐ | 修改 mount 参数为 `data=writeback,noatime` | 减少 ext4 journal 开销 |
| ⭐ | 关闭从库 binlog | 减少额外 fsync |
---
是否方便我帮你写一份针对你当前 `/home` 挂载盘(sdb1)的完整 **优化脚本 + my.cnf 调整示例**?
这样你可以直接执行并观测复制性能提升。
非常好,你贴的 `iostat -x 1 10` 输出能帮我们判断 MySQL 从库“写入慢”的**根本瓶颈在磁盘层**。我来一步步帮你分析:
---
## 🧩 一、核心发现
从你的输出可以看到:
```
Device: sdb
w/s = 380~394
wkB/s ≈ 2900~3100
%util ≈ 90~94%
w_await ≈ 2.4ms
%iowait ≈ 18~22%
```
这几项说明:
| 指标 | 意义 | 分析 |
|---|
| **%util ≈ 90~94%** | 磁盘利用率 | 这个值接近 100%,说明磁盘基本“打满”。即使 CPU 很空闲,也在等磁盘写入。 |
| **%iowait ≈ 20%** | CPU 等待 IO 的时间比例 | 说明进程(包括 mysqld)经常在等待 IO 完成。 |
| **w\_await ≈ 2.4ms** | 写等待时间 | 每次写平均等待 2.4ms,不算太高(机械盘还可以接受),但因为写操作非常频繁(w/s 380+),IO 队列几乎持续满载。 |
| **wrqm/s 约 300,%wrqm ≈ 44%** | 写合并比 | 系统已经尽量做写请求合并优化,仍然打满,说明物理写量确实大。 |
👉 **结论:MySQL 从库的写盘成为瓶颈,磁盘 `sdb` 已经接近满负载状态。**
---
## 🧠 二、定位写入慢的主要原因
MySQL 从库的“写入”主要来源于:
1. **relay log** 写入(SQL线程从主库拉binlog后落地 relay log)
2. **SQL线程回放事务写 innodb 数据文件**
3. **binlog 同步(如果开启了 log-bin)**
4. **redo log/fsync 写盘**(特别是 `innodb_flush_log_at_trx_commit` 配置为1时)
---
## ⚙️ 三、进一步诊断建议
### 1️⃣ 查看 MySQL 内部指标
执行:
```sql
SHOW GLOBAL STATUS LIKE 'Innodb_%writes%';
SHOW GLOBAL STATUS LIKE 'Innodb_data%';
SHOW GLOBAL STATUS LIKE 'Innodb_os_log%';
SHOW GLOBAL STATUS LIKE 'Slave_running%';
SHOW SLAVE STATUS\G
```
重点看:
- `Innodb_data_pending_writes` 是否大;
- `Innodb_data_fsyncs` 是否频繁;
- `Seconds_Behind_Master` 是否越来越大;
- `Slave_SQL_Running_State` 是否卡在某个事务执行。
---
### 2️⃣ 检查磁盘类型与挂载参数
运行:
```bash
lsblk -o NAME,ROTA,MOUNTPOINT
mount | grep mysql
```
- 若 `ROTA=1` 表示是机械盘(写延迟高);
- 确认 MySQL 数据盘挂载时是否禁用了 `barrier`、`noatime` 优化;
- 例如推荐 `/etc/fstab` 挂载参数:
```
defaults,noatime,nodiratime,barrier=0
```
(⚠️ barrier=0 要确保有 UPS 或 SSD,否则断电可能丢数据)
---
### 3️⃣ 查看 InnoDB 写参数
执行:
```sql
SHOW VARIABLES LIKE 'innodb_flush_log_at_trx_commit';
SHOW VARIABLES LIKE 'sync_binlog';
SHOW VARIABLES LIKE 'innodb_flush_method';
```
- `innodb_flush_log_at_trx_commit=1`:每次提交事务都 fsync(安全但最慢)
- 可改为:
```sql
SET GLOBAL innodb_flush_log_at_trx_commit=2;
```
或在 my.cnf:
```ini
[mysqld]
innodb_flush_log_at_trx_commit=2
sync_binlog=0
```
⚠️ 从库可以安全地使用这些优化,因为它可以从主库重放。
---
### 4️⃣ 检查 relay log 写入延迟
如果 relay log 存在于同一块磁盘 `/home/shuncom/mysql/data`,可以考虑**分盘**或将 relay log 移动至另一块 SSD:
```ini
relay_log=/data/relay/relay-bin
```
---
## 🧰 四、优化方向建议总结
| 优化点 | 推荐操作 |
|---|
| **磁盘瓶颈** | 使用 SSD 或 NVMe 替换 sdb,或迁移 relay log/data 至独立磁盘 |
| **InnoDB 写策略** | 调整 `innodb_flush_log_at_trx_commit=2`、`sync_binlog=0` |
| **文件系统** | mount 参数增加 `noatime,nodiratime,barrier=0` |
| **从库负载** | 关闭从库 binlog(`log_bin=0`),除非你要链式复制 |
| **IO 调度器** | 使用 `deadline` 或 `noop` 调度算法(SSD 适合 noop): |
```bash
echo deadline > /sys/block/sdb/queue/scheduler
```
---
## 🧾 五、可执行检查小结
快速排查命令清单:
```bash
# 1. 确认磁盘是机械还是SSD
lsblk -o NAME,ROTA,MOUNTPOINT
# 2. 检查IO调度算法
cat /sys/block/sdb/queue/scheduler
# 3. 检查挂载参数
mount | grep mysql
# 4. 检查InnoDB参数
mysql -e "SHOW VARIABLES LIKE 'innodb_flush_log_at_trx_commit';"
mysql -e "SHOW VARIABLES LIKE 'sync_binlog';"
# 5. 检查Slave状态
mysql -e "SHOW SLAVE STATUS\G" | egrep "Seconds_Behind_Master|Running_State"
```
---
如果你愿意贴出以下信息,我可以帮你**定出精准优化方案(适合你的盘与配置)**:
1. `SHOW VARIABLES LIKE 'innodb_%';`
2. `mount | grep mysql`
3. `lsblk -o NAME,ROTA,SIZE,MOUNTPOINT`
4. `/etc/mysql/my.cnf` 或主要 MySQL 配置段(尤其是 \[mysqld\] 部分)
是否要我帮你分析这些配置来出一份 **定制化 MySQL 从库 IO 优化配置清单**?
很好,这些信息非常关键。我们可以从你提供的 MySQL 状态变量看出:
主从复制延迟 **(Seconds\_Behind\_Master = 5495423,大约63天)** 非常严重,说明**从库写入或重放(SQL线程)极度慢**。
我们来系统分析下原因和排查方向👇
---
## 🧩 一、现象分析小结
- `Slave_IO_Running: Yes`,`Slave_SQL_Running: Yes` → 主从连接正常。
- `Slave_SQL_Running_State: waiting for handler commit` → SQL线程主要**卡在事务提交阶段**。
- `innodb_flush_log_at_trx_commit = 2`(每秒刷新一次日志,不是最安全但性能较好)
- `sync_binlog = 1`(每次写binlog都同步磁盘,非常慢,尤其对从库不必要)
- `innodb_flush_method = O_DIRECT` → 避免OS缓存,OK。
- `Innodb_data_pending_fsyncs = 97889` → ⚠️ **磁盘同步写积压严重**。
> ✅ 结论:从库性能瓶颈在 **磁盘 I/O(fsync 过慢)**,特别是 **redo log/fsync** 部分。
---
## 🧱 二、问题核心:从库 SQL 线程卡在 commit
### 🔍 你看到的 `waiting for handler commit` 表示:
InnoDB 已执行完逻辑更新操作,正在等待 **redo log fsync**,也就是等待操作系统完成磁盘写入。
造成这种情况的常见原因:
1. **磁盘设备性能差(IOPS不足)** — 特别是 SATA HDD。
2. **文件系统层缓存写满或 flush 太慢**。
3. **MySQL 的 redo 日志太小,频繁切换**。
4. **sync\_binlog=1 导致额外 I/O**。
5. **从库 SQL 延迟太大导致 relay log 巨大,I/O 队列堵塞**。
---
## 🧰 三、建议的分析步骤
### 1️⃣ 检查磁盘IO性能
```bash
iostat -x 1 10
```
关注字段:
- `%util` 是否长期接近 100%;
- `await` 是否远大于 10ms;
- `svctm` 是否明显低;
说明磁盘已经成为瓶颈。
也可以用:
```bash
pidstat -d 1 -p $(pidof mysqld)
```
查看 mysqld 的读写速率。
---
### 2️⃣ 检查 relay log 占用和落盘速度
```bash
du -sh /var/lib/mysql/relay-log*
```
如果 relay log 达到 **数百 GB 甚至 TB**,说明 SQL线程远落后于 IO线程。
可以查看 SQL 线程的执行位置差距:
```sql
SHOW SLAVE STATUS\G
-- 对比 Read_Master_Log_Pos 与 Exec_Master_Log_Pos 差距
```
---
### 3️⃣ 检查 InnoDB I/O 配置
```sql
SHOW VARIABLES LIKE 'innodb_io_capacity%';
```
如果太低(默认200),可适当调高,例如:
```ini
innodb_io_capacity=2000
innodb_io_capacity_max=4000
```
---
### 4️⃣ 检查 redo log 大小
```sql
SHOW VARIABLES LIKE 'innodb_log_file_size';
```
如果非常小(如 512M),应增大:
```ini
innodb_log_file_size=4G
innodb_log_files_in_group=2
```
重启后生效,可以显著减少频繁的 redo flush。
---
### 5️⃣ 检查文件系统 mount 参数
确认使用的是:
```bash
mount | grep mysql
```
建议挂载参数中包含:
```
noatime,nodiratime,barrier=0,data=writeback
```
但请注意这些参数可能会牺牲一定的可靠性。
---
## ⚙️ 四、可立即优化的配置建议(针对从库)
在 **只读从库** 场景下,你可以大胆调优以提升复制速度:
```ini
# my.cnf (在 [mysqld] 下)
sync_binlog = 0
innodb_flush_log_at_trx_commit = 0
innodb_flush_method = O_DIRECT
innodb_io_capacity = 2000
innodb_io_capacity_max = 4000
innodb_flush_neighbors = 0
innodb_doublewrite = 0
```
> ⚠️ 这些设置会降低崩溃安全性,但在 **只读从库** 上完全可接受,性能通常能提升数倍。
---
## 🧮 五、验证优化效果
1. 执行:
```sql
SHOW SLAVE STATUS\G
```
检查 `Seconds_Behind_Master` 是否逐渐下降。
2. 观察:
```bash
iostat -x 5
```
`%util` 是否明显下降。
3. 观察 relay log 是否逐渐减少。
---
## 📊 六、若仍缓慢,可进一步操作:
- **启用多线程复制**:
```sql
STOP SLAVE;
SET GLOBAL slave_parallel_workers = 8;
START SLAVE;
```
并配置:
```ini
slave_parallel_type = LOGICAL_CLOCK
slave_preserve_commit_order = 1
```
可显著加速重放(MySQL 5.7+)。
---
是否可以请你再执行下面两条命令,我可以更精准判断延迟的根因:
```bash
iostat -x 1 5
```
```sql
SHOW VARIABLES LIKE 'innodb_io_capacity%';
```
我来帮你结合磁盘IO数据,确认到底是I/O饱和还是InnoDB参数瓶颈。
明白,你是在 **物理机上,Windows Server 2022** 环境下,要确定组成 RAID1 的 8TB 硬盘接口类型(SAS 还是 SATA)。下面给你详细方法:
---
### **方法1:通过 PowerShell 查看硬盘接口类型**
1. 打开 **PowerShell(管理员)**
2. 执行命令:
```powershell
Get-PhysicalDisk | Select-Object FriendlyName, MediaType, CanPool, BusType, Size
```
- `BusType` → 硬盘总线类型,常见值:
- `Sata` → SATA
- `Sas` → SAS
- `Usb` → USB
- `Nvme` → NVMe
- `MediaType` → 磁盘类型(HDD 或 SSD)
- `Size` → 硬盘容量
示例输出:
```
FriendlyName MediaType CanPool BusType Size
------------ --------- ------- ------- ----
Hitachi HUS728 HDD False Sas 8 TB
```
如果 `BusType=Sas` → SAS 硬盘;`BusType=Sata` → SATA 硬盘。
---
### **方法2:通过磁盘管理/设备管理器**
1. 打开 **设备管理器** → **磁盘驱动器**
2. 找到硬盘 → 右键 **属性** → **详细信息** → **物理设备对象**或 **硬件ID**
3. 根据型号查厂商官网说明,型号通常能看出是 SAS 还是 SATA。
---
### **方法3:通过厂商工具**
如果是服务器品牌硬盘(Dell、HPE、Lenovo 等),可以用厂家 RAID / 磁盘管理工具:
- **Dell** → OpenManage Server Administrator (OMSA)
- **HPE** → Smart Storage Administrator (SSA)
- **Lenovo** → XClarity Administrator
在工具里查看 RAID 阵列的硬盘信息,通常会直接标明 **SAS/SATA**、容量、转速等。
---
💡 **建议**
最直接和官方的方法是 **PowerShell 的 `BusType`** 或者用 **服务器厂商管理工具**,可以同时看到 RAID 阵列信息和硬盘接口类型。
---
明白了,你这台服务器上 RAID 是通过 **硬件 RAID 控制器(DELL PERC H730 Mini)** 做的,所以在 Windows 下 **`Get-PhysicalDisk` 或 `Disk Management` 无法看到每块物理盘的具体信息**,只会显示 RAID 逻辑盘(BusType=RAID)。这是正常现象。
要查看组成 RAID1 的 8TB 硬盘接口类型(SAS/SATA),你需要直接通过 **硬件 RAID 控制器管理工具** 或者 **开机 BIOS/UEFI RAID 管理界面**。具体方法如下:
---
### **方法1:通过 PERC H730 Mini 管理工具(推荐)**
1. 安装 **Dell OpenManage Server Administrator (OMSA)**:
- 下载地址:[https://www.dell.com/support/home](https://www.dell.com/support/home)
- 安装后打开 **OMSA Web GUI**(默认端口 1311)
2. 在左侧导航选择:
```
Storage → PERC H730 Mini → Virtual Disks / Physical Disks
```
3. 在 **Physical Disks** 可以看到:
- 每块硬盘型号
- 接口类型(SAS / SATA)
- 转速(RPM)
- 状态
4. 这样可以确认 RAID1 内每块硬盘的类型。
---
### **方法2:开机进入 RAID BIOS**
1. 重启服务器
2. 在启动时按 **Ctrl+R** 进入 PERC RAID BIOS
3. 选择你的 RAID 阵列
4. 查看每块物理硬盘信息:
- 模型
- 接口类型(SAS/SATA)
- 容量和状态
---
### **方法3:命令行(OMSA CLI)**
如果不想开 GUI,可以用 OMSA 命令行 `omreport`:
```cmd
omreport storage pdisk controller=0
```
输出示例:
```
ID Status Type Size MediaType Protocol
0 Ok SAS 8TB HDD SAS
1 Ok SAS 8TB HDD SAS
```
- `Type`/`Protocol` → 可以看出是 SAS 还是 SATA
---
💡 **总结**
在 **硬件 RAID 下,Windows 是看不到物理盘接口类型的**,必须用 **RAID 控制器管理工具(OMSA/BIOS CLI/GUI)** 才能确认。
---
在 **Windows Server 2022** 上,Hyper-V 虚拟机的磁盘读写速度并没有一个固定的“硬性限制”,但实际上速度会受到多种因素的影响,可能表现出瓶颈或性能下降。具体分析如下:
---
### **1. Hyper-V 虚拟硬盘类型限制**
Hyper-V 支持几种虚拟硬盘类型:
| 类型 | 描述 | 对性能的影响 |
|---|
| VHD | 最大 2TB | 老旧格式,性能最低,不推荐用于大容量或高性能需求 |
| VHDX | 最大 64TB | 支持大页、日志日志防护、动态扩展等;性能最好 |
- **推荐**使用 **VHDX**。
- **固定大小 VHDX**(Fixed Size)性能最好,读写延迟最小。
- **动态扩展 VHDX**(Dynamically Expanding)在增长时会有 I/O 开销,性能略低。
- **差异 VHDX**(Differencing)性能最低,不推荐用于高 I/O 场景。
---
### **2. 虚拟机存储控制器类型**
Hyper-V 虚拟机的磁盘是通过虚拟控制器连接的:
| 控制器类型 | 性能特点 |
|---|
| IDE Controller | 最大兼容性,但性能较差,适合引导盘 |
| SCSI Controller | 高性能,支持热插拔,适合数据盘 |
**建议**:数据盘使用 **SCSI**,IDE 仅用于引导盘。
---
### **3. 虚拟化功能和缓存设置**
- **虚拟硬盘缓存策略**(Virtual Hard Disk Cache):
- `None` → 不使用宿主缓存,I/O 更直通,延迟低
- `Host Cache` → 使用宿主机缓存,可提高读写性能
- `Write-Through` / `Write-Back` → 影响写入延迟和可靠性
- **启用虚拟化 I/O 优化**:
- Hyper-V 支持 **Virtualization-based I/O (VSP/VSC)**,如果操作系统和驱动支持,性能接近裸机。
---
### **4. 宿主机存储性能**
虚拟机磁盘性能最终受宿主机硬件影响:
1. **物理硬盘类型**:
- SATA HDD → 速度慢,10~200 MB/s
- SAS HDD → 速度更快,150~300 MB/s
- SSD/NVMe → 速度高,可达几 GB/s
2. **RAID 类型**:
- RAID1、RAID10 → 读性能好,写性能略低
- RAID5 → 写性能受限
3. **存储总线/控制器**:
- HBA 或 PERC RAID 卡的队列深度和缓存策略会影响性能
---
### **5. 虚拟机配置和系统负载**
- 虚拟机 vCPU、内存、NUMA 节点分配会影响 I/O 调度。
- 多虚拟机共享同一物理存储,I/O 会互相影响。
- Hyper-V **Dynamic Memory** 不影响磁盘,但内存不足会触发分页,也影响磁盘性能。
---
### **6. 性能优化建议**
1. **使用 VHDX 固定大小磁盘**
2. **数据盘使用 SCSI 控制器**
3. **在宿主机使用 SSD 或高速 SAS RAID**
4. **合理配置虚拟机 vCPU/内存,避免存储竞争**
5. \*\*使用宿主机缓存(Write-Back / Host Cache)\*\*根据工作负载优化
6. **考虑 Hyper-V 的 “启用虚拟化硬件加速” 选项**
---
💡 **结论**:
Windows Server 2022 并没有人为限制 Hyper-V 虚拟机的磁盘读写速度,但虚拟化、存储类型、控制器类型和宿主机硬件都会影响实际速度。通过 **固定大小 VHDX + SCSI 控制器 + 高速宿主存储** 可以让虚拟机磁盘性能接近物理机。
---
如果你需要,我可以帮你写一条 **PowerShell 命令直接测试 Hyper-V 虚拟机磁盘 IOPS/读写速度**,方便评估当前配置瓶颈。
你希望我写吗?
# 在主域虚拟机上正确配置时间服务器
非常好 👍,你的输出信息非常有价值。
我们来仔细分析下目前状态,基本可以确定问题点在哪里。
---
## 🔍 一、当前状态分析
| 项目 | 状态 | 说明 |
|---|
| `nltest /dsgetdc` | ✅ 正常 | 已成功解析到域控制器 `S-DNS1.shuncom.local (192.168.0.5)`,域通信没问题 |
| `w32tm /query /status` | ❌ 异常 | `Leap 指示符: 3(未同步)`、`层次: 0 (未指定)`、`源: Local CMOS Clock`,说明此机器未能与 DC 同步 |
| `w32tm /query /configuration` | ✅ 正常 | Type 为 `NT5DS`(域层级同步),表示配置是正确的 |
| `w32tm /query /peers` | ⚠️ 异常 | 对等源显示 `S-DNS1.shuncom.local`,但层次是 `0 (未指定)`,说明虽然发现了 DC,但 DC **没有对外提供时间服务或未响应 NTP** |
👉 也就是说:
> **问题出在 DC(S-DNS1)的时间服务未正确提供,导致客户端无法获得可用时间数据。**
---
## 🧭 二、请在域控制器(S-DNS1)上执行以下命令检查
### 1️⃣ 查看 DC 时间服务状态
```powershell
w32tm /query /status
```
正常应显示:
```
Leap Indicator: 0(no warning)
Stratum: 2
Source: Local CMOS Clock
```
如果 `Stratum: 0` 或 `未同步`,说明 DC 自身时间服务异常。
---
### 2️⃣ 查看 DC 时间服务配置
```powershell
w32tm /query /configuration
```
看一下是否包含:
```
Type: NTP
NtpServer: time.windows.com,0x8
AnnounceFlags: 5
```
如果没有,说明 DC 未配置为可靠时间源。
---
## 🛠 三、修复 DC 时间服务(PDC 角色上执行)
> 以下命令只在 **PDC 域控制器** 上执行(你从 `nltest` 输出看到 `Flags` 里包含 `PDC`,说明 S-DNS1 就是 PDC)。
### 1️⃣ 设置外部时间源(例如微软时间服务器):
```powershell
w32tm /config /manualpeerlist:"time.windows.com,0x8" /syncfromflags:manual /reliable:yes /update
```
### 2️⃣ 重启时间服务:
```powershell
net stop w32time
net start w32time
```
### 3️⃣ 重新同步一次:
```powershell
w32tm /resync /force
```
### 4️⃣ 检查状态:
```powershell
w32tm /query /status
```
应看到:
```
Source: time.windows.com,0x8
Stratum: 2
```
---
## 🧩 四、在客户端再次执行
在你的客户端(`7000`)主机上执行:
```powershell
net stop w32time
net start w32time
w32tm /config /syncfromflags:domhier /update
w32tm /resync /force
```
检查结果:
```powershell
w32tm /query /source
```
✅ 理想输出:
```
S-DNS1.shuncom.local
```
---
## ✅ 五、可选验证
最后可测试:
```powershell
w32tm /stripchart /computer:S-DNS1.shuncom.local /dataonly /samples:5
```
若出现带时间偏移值的连续行,说明 NTP 同步通道已恢复。
---
如果你愿意,把 **S-DNS1 上执行的以下两条命令输出**发给我:
```powershell
w32tm /query /status
w32tm /query /configuration
```
我可以直接帮你确认 DC 是否已经成为“可靠时间源”。
非常好,这个输出说明问题的关键点已经非常清晰了。
你的域控制器 **S-DNS1** 当前的时间来源是:
```
Source: VM IC Time Synchronization Provider
```
也就是 **虚拟化平台(Hyper-V 或 VMware)提供的时间同步源**,而 **不是外部 NTP 服务器或域层级时间服务**。
这会导致以下问题👇:
---
## ⚠️ 问题说明
- DC 的 **Leap 指示符: 3(未同步)** 表示:虽然它声称是主时钟(Stratum 1),但实际上它自己都没同步。
- “VM IC Time Synchronization Provider” 是虚拟机工具自动注入的时间源(VMware Tools / Hyper-V Integration Services)。
域内其他主机(如你的 `7000` 客户机)从该 DC 获取时间时,会被拒绝或无法获得“可用的时间数据”。
换句话说:
> DC 当前只是从虚拟机宿主机获取时间,而非一个“可靠的 NTP 服务端”。
---
## ✅ 解决方案(让 S-DNS1 成为域内可靠时间源)
### 步骤 1:在 S-DNS1 上设置外部时间源
以管理员身份运行 PowerShell:
```powershell
w32tm /config /manualpeerlist:"time.windows.com,0x8 cn.pool.ntp.org,0x8" /syncfromflags:manual /reliable:yes /update
```
这条命令含义:
- `manualpeerlist`: 设置多个外部 NTP 源。
- `syncfromflags:manual`: 强制从外部手动源同步。
- `reliable:yes`: 声明本机是域内“可靠时间源”(PDC 的必备角色)。
---
### 步骤 2:禁用虚拟机时间同步(在 Hyper-V 或 VMware 上)
> 因为虚拟化层的时间同步会“覆盖” w32time。
#### VMware 环境下:
在 VMware vSphere 中编辑虚拟机设置,取消勾选:
> “Synchronize guest time with host”
或者在命令行中执行:
```bash
vmware-toolbox-cmd timesync disable
```
#### Hyper-V 环境下:
取消集成服务里的 “Time synchronization” 勾选。
---
### 步骤 3:重启时间服务并立即同步
```powershell
net stop w32time
net start w32time
w32tm /resync /force
```
然后检查:
```powershell
w32tm /query /status
```
期望输出:
```
Leap 指示符: 0(no warning)
层次: 2
源: time.windows.com,0x8
```
---
### 步骤 4:客户端(如“7000”)重新同步
```powershell
net stop w32time
net start w32time
w32tm /config /syncfromflags:domhier /update
w32tm /resync /force
```
然后:
```powershell
w32tm /query /source
```
应返回:
```
S-DNS1.shuncom.local
```
---
### 🔎 验证测试
客户端上运行:
```powershell
w32tm /stripchart /computer:S-DNS1.shuncom.local /dataonly /samples:5
```
如果出现类似输出:
```
12:34:56, +00.0012345s
12:34:57, +00.0009876s
...
```
表示时间同步链路已恢复正常。
---
是否方便告诉我你的域控制器是在 **VMware** 还是 **Hyper-V** 环境中?
我可以针对该平台提供具体的“禁用虚拟机时间同步”的操作步骤。
非常好!🎉
现在域控制器(S-DNS1)已经完全恢复成一个 **健康、权威的时间源**。从输出可以确认一切工作正常:
---
## ✅ 关键信息分析
```
Leap 指示符: 0(无警告) → 正常同步状态
层次: 3 (次引用 - 与(S)NTP 同步) → 已从外部 NTP 获取时间
源: cn.pool.ntp.org,0x8 → 当前时间来源为中国 NTP 池
```
说明:
- DC 不再依赖 “VM IC Time Synchronization Provider”;
- 已成功与外部网络时间源同步;
- 将作为域内 **权威时间源(reliable time source)** 向下游域成员提供时间。
---
## 🧭 下一步:客户端重新同步
在你的客户端(`7000`)主机上执行以下命令:
```powershell
net stop w32time
net start w32time
w32tm /config /syncfromflags:domhier /update
w32tm /resync /force
```
然后查看结果:
```powershell
w32tm /query /source
w32tm /query /status
```
正常情况下你会看到类似:
```
Source: S-DNS1.shuncom.local
Leap 指示符: 0(无警告)
层次: 4 (次引用 - 与域控制器同步)
```
这时整个域的时间层级链路如下:
```
Internet NTP (time.windows.com / cn.pool.ntp.org)
↓
PDC S-DNS1 (Stratum 3, Reliable Time Source)
↓
域成员(如 7000 主机)(Stratum 4)
```
---
## 🔧 可选验证命令
确认客户端确实能和 DC 通信:
```powershell
w32tm /stripchart /computer:S-DNS1.shuncom.local /dataonly /samples:5
```
输出示例(正常):
```
12:45:01, +00.0001234s
12:45:02, +00.0002345s
...
```
---
✅ 到此为止,你的域控与客户端时间同步体系已经修复完成。
是否需要我帮你再提供一份 **“Windows 域时间同步架构与常见故障修复指南”**(可以保存为 Word 或 PDF)?这份文档可用于今后类似场景快速排障。
非常好,你的排查已经进行到最后一步。现在情况非常明确:
---
## 🔍 当前状态总结
- 域控 **S-DNS1** → ✅ 已正常同步外部 NTP(`cn.pool.ntp.org`),工作正常;
- 客户端 **7000** → ❌ 仍然未从域控获得时间数据,显示:
```
此计算机没有重新同步,因为没有可用的时间数据。
Source: Local CMOS Clock
```
这表明客户端虽然配置为从域层级(`domhier`)同步,但实际上并没有真正与域控制器的时间服务建立通信。
---
## 🧭 一、确认客户端确实“在域中”且能联系域控
请先执行:
```powershell
nltest /sc_query:shuncom.local
```
- 如果返回:
```
The command completed successfully
```
表示安全通道正常。
- 如果返回错误(如 1355 或 1786),则是 **安全通道中断**,必须先修复(重新加入域或重建信任)。
> ⚠️ 时间同步依赖 Netlogon 安全通道。如果域信任断开,即使 DNS 和 ping 都正常,也不会同步时间。
---
## 🧩 二、检查 w32time 的同步类型
执行:
```powershell
reg query HKLM\SYSTEM\CurrentControlSet\Services\W32Time\Parameters /v Type
```
输出应为:
```
Type REG_SZ NT5DS
```
如果不是 `NT5DS`(例如是 `NTP` 或空),请修正为域模式:
```powershell
w32tm /config /syncfromflags:domhier /update
```
然后重启时间服务:
```powershell
net stop w32time
net start w32time
```
---
## 🧱 三、确保客户端能通过 UDP/123 与域控通信
测试:
```powershell
w32tm /stripchart /computer:S-DNS1.shuncom.local /dataonly /samples:5
```
- ✅ 如果看到时间偏移输出(连续几行时间差值),说明网络通信没问题;
- ❌ 如果全部超时(timeout),说明 **UDP 123 被防火墙或安全软件拦截**。
请确保以下端口开放:
- 出站 UDP 123(客户端 → DC)
- 入站 UDP 123(DC → 客户端)
---
## 🔧 四、强制手动指定 NTP 源测试(验证能否通)
先在客户端直接与 DC 做一次手动同步测试:
```powershell
w32tm /config /manualpeerlist:"S-DNS1.shuncom.local,0x8" /syncfromflags:manual /update
w32tm /resync /force
```
如果成功,会显示:
```
正在重新同步此计算机...
命令已成功完成。
```
再执行:
```powershell
w32tm /query /source
```
应变为:
```
S-DNS1.shuncom.local,0x8
```
👉 如果这一步成功,则说明问题只在“域层级自动选择”(NT5DS)上,可以再切回 `domhier` 模式继续用。
---
## ⚙️ 五、(如仍失败)重置时间服务组件
```powershell
net stop w32time
w32tm /unregister
w32tm /register
net start w32time
w32tm /config /syncfromflags:domhier /update
w32tm /resync /force
```
然后再看:
```powershell
w32tm /query /source
```
---
## ✅ 正常完成后的预期
当一切恢复时,你将看到:
```
w32tm /query /source
S-DNS1.shuncom.local
w32tm /query /status
Leap 指示符: 0(无警告)
层次: 4 (次引用)
上次成功同步时间: <当前时间>
```
---
请先发给我这条命令的输出:
```powershell
nltest /sc_query:shuncom.local
```
我可以马上告诉你是否是 **安全通道问题**(这种情况在“时间无法同步但 DNS 正常”时非常常见)。
非常好,你的诊断信息非常完整 👍。从结果看出:
虽然 Win11 客户机 **已经成功与域控 S-DNS1.shuncom.local 建立同步源**,但时间仍有较大误差(**相差约 75 秒以上**)。这说明同步服务逻辑通了,但**时间未真正对齐**。
---
### 🔍 一、确认问题核心
从以下输出判断:
```bash
w32tm /query /status
层次: 4 (次引用 - 与(S)NTP 同步)
上次成功同步时间: 2025-10-16 12:14:04
源: S-DNS1.shuncom.local
```
说明:
- **域控可达,协议正常(UDP 123 可通)**。
- 但 `/stripchart` 显示:
```
+81s → +75s
```
表示客户端时间比域控 **快 75~80 秒**,且时间差在逐渐变化 → 表示同步过程**未立即校正本地时间**。
---
### ⚙️ 二、原因分析
Windows 客户端默认使用以下机制:
- 若时间差 **< 128 秒** → 只进行“平滑调整(slew)”,不会立刻跳变。
- 若时间差 **> 128 秒** → 直接重置时间(step)。
但在你的场景里(75 秒误差),虽然小于 128 秒,但系统仍未“平滑”追上,可能是由于:
1. 客户端 **Windows Time 服务未设置为自动立即步进调整**;
2. **系统时钟漂移太快**(如主板 CMOS、虚拟机时间漂移);
3. **时间同步策略被组策略覆盖**;
4. **NTP 响应延迟或丢包**(根延迟和分散值较大,`145s` 表示误差累积高)。
---
### 🧭 三、推荐修复步骤
#### ✅ 1. 确认域控时间准确
在 **S-DNS1** 域控上执行:
```powershell
w32tm /query /source
w32tm /query /status
```
确保:
- 域控同步源为外部 NTP(如 `cn.pool.ntp.org` 或 `time.windows.com`)
- 状态为已同步 (`层次: 3` 或更低)
如未同步,请修复主域控时间源:
```powershell
w32tm /config /manualpeerlist:"time.windows.com,0x8 cn.pool.ntp.org,0x8" /syncfromflags:manual /reliable:yes /update
net stop w32time && net start w32time
w32tm /resync /force
```
---
#### ✅ 2. 在客户端(Win11)强制立即校正时间
执行以下命令彻底清理缓存并重置同步:
```powershell
net stop w32time
w32tm /unregister
w32tm /register
net start w32time
w32tm /config /manualpeerlist:"S-DNS1.shuncom.local,0x8" /syncfromflags:manual /update
w32tm /resync /nowait
```
若仍存在 75s 误差,可强制 step 调整:
```powershell
w32tm /resync /rediscover /force
```
或者:
```powershell
w32tm /config /update
net stop w32time && net start w32time
```
---
#### ✅ 3. 修改注册表(启用强制时间跳变)
若客户端仍缓慢同步,可强制允许直接校正时间(step):
```powershell
reg add HKLM\SYSTEM\CurrentControlSet\Services\W32Time\Config /v MaxPosPhaseCorrection /t REG_DWORD /d 3600 /f
reg add HKLM\SYSTEM\CurrentControlSet\Services\W32Time\Config /v MaxNegPhaseCorrection /t REG_DWORD /d 3600 /f
net stop w32time && net start w32time
w32tm /resync /force
```
这允许系统在误差 ±3600 秒内直接跳变修正时间。
---
#### ✅ 4. 验证结果
再次检查同步状态:
```powershell
w32tm /query /status
w32tm /stripchart /computer:S-DNS1.shuncom.local /dataonly /samples:5
```
你应看到:
```
+0.05s ~ +0.10s
```
即可视为同步成功。
---
### 📘 四、建议长期策略
- 确保域控(PDC Emulator 角色)同步外部权威 NTP;
- 其他域控、成员服务器、客户端使用 `NT5DS`(即 domhier)模式;
- 确认防火墙开放 UDP 123;
- 若为虚拟机,建议**关闭宿主机自动同步时间**(由域控统一管理)。
---
是否希望我帮你写一份完整的 **域控+客户端 NTP 同步修复脚本(PowerShell 版)**?
可直接在两边运行,一键同步时间并验证结果。
# Veeam Restore(恢复任务)时与目标主机的网络连接失败
非常好,这个报错一看就是 **Veeam Restore(恢复任务)时与目标主机的网络连接失败**,
核心错误是:
```
Failed to connect to the port [S-FACTORY02.shuncom.local:2500]
--tr:Failed to connect to target endpoint.
```
---
## ⚠️ 一、错误根因分析
Veeam 在执行恢复操作时,需要通过 **TCP 2500–3300端口** 与目标主机(或代理、存储节点)建立数据通道。
这个错误表明:
> Veeam Backup Server 无法连接目标主机的 **2500 端口**(即 Veeam Data Mover 服务通信端口)。
常见原因如下:
| 原因 | 说明 |
|---|
| 🔒 防火墙阻挡 | Windows 防火墙或网络安全策略阻止了 2500 端口 |
| 🚫 Veeam Data Mover 未启动 | 目标主机上的 Veeam Agent 服务未正常运行 |
| 🌐 DNS 或网络异常 | 源端无法解析或访问 `S-FACTORY02.shuncom.local` |
| 🧩 恢复使用了错误的网络适配器或隔离网络 | |
| 🧱 安全策略/杀毒 | 某些安全产品(如 Defender、Sophos)拦截通信 |
---
## ✅ 二、快速排查步骤
### 1️⃣ 检查端口连通性(在备份服务器上)
执行:
```cmd
telnet S-FACTORY02.shuncom.local 2500
```
或者:
```powershell
Test-NetConnection -ComputerName S-FACTORY02.shuncom.local -Port 2500
```
- 如果失败 → 网络层不通(防火墙/路由问题)
- 如果成功 → 服务可能未监听或异常退出
---
### 2️⃣ 检查目标主机上的服务状态
在目标主机 **S-FACTORY02** 上执行:
```powershell
Get-Service | findstr Veeam
```
正常应看到:
```
VeeamDeploymentService Running
VeeamTransportSvc Running
VeeamAgentSvc Running
```
若有 `Stopped` 或不存在:
```powershell
Start-Service VeeamTransportSvc
Start-Service VeeamDeploymentService
```
---
### 3️⃣ 检查防火墙端口是否放行
在目标主机上执行:
```powershell
netsh advfirewall firewall add rule name="Veeam Data Mover" dir=in action=allow protocol=TCP localport=2500-3300
```
同时允许 Veeam 服务程序通过:
```powershell
netsh advfirewall firewall add rule name="Veeam Agent" dir=in action=allow program="C:\Program Files\Veeam\Transport\VeeamAgent.exe"
```
---
### 4️⃣ 确认 DNS 能解析
执行:
```cmd
ping S-FACTORY02.shuncom.local
```
如果提示“找不到主机”,说明 DNS 有问题。
可以尝试用 IP 连接:
```cmd
ping
```
若 IP 能通而域名不通,则需在 Veeam Server 上修复 DNS 或在 `C:\Windows\System32\drivers\etc\hosts` 中临时添加:
```
192.168.x.x S-FACTORY02.shuncom.local
```
---
### 5️⃣ 若使用代理服务器(Proxy)
确认恢复任务使用的 **目标代理** 与目标主机处于同一网络段,且双方能互通。
可以在 Veeam 控制台 → `Backup Infrastructure → Backup Proxies` → 检查网络设置。
---
### 6️⃣ 重启通信组件(彻底刷新连接)
在目标主机:
```powershell
Restart-Service VeeamTransportSvc
Restart-Service VeeamDeploymentService
```
在备份服务器:
```powershell
Restart-Service VeeamBackupSvc
```
---
## 🧰 三、验证恢复再试
重新运行恢复任务前,可执行:
```powershell
Veeam.Backup.Manager.exe /service
```
确认无错误输出,然后重新尝试恢复。
---
## 🔧 四、若依旧失败,可强制重建 Data Mover 通道
1️⃣ 删除目标主机的临时 Data Mover 目录:
```
C:\ProgramData\Veeam\Backup
```
2️⃣ 在 Veeam 控制台 → “Managed Servers” → 删除并重新添加该主机(重新推送组件)。
---
## ✅ 五、总结对应方案
| 错误根因 | 解决方案 |
|---|
| 防火墙阻挡 | 放行 TCP 2500–3300 |
| Veeam 服务未启动 | 启动 `VeeamTransportSvc` |
| DNS 无法解析 | 添加 hosts 或修复 DNS |
| 代理设置不当 | 确保代理与目标同网段 |
| 通信组件损坏 | 重装 Veeam Agent 组件 |
---
如果你愿意贴出以下命令的结果,我可以直接告诉你是哪个环节阻断了连接:
```powershell
Test-NetConnection -ComputerName S-FACTORY02.shuncom.local -Port 2500
Get-Service | findstr Veeam
netstat -ano | findstr 2500
```
是否要我帮你一步步定位(例如确认 2500 是否在监听、是否被防火墙阻断)?
# Windows Server 2022 上测试硬盘的读写性能
在 **Windows Server 2022** 上测试硬盘的读写性能,可以使用系统自带或原生命令行工具(如 `winsat`、`diskspd`、`PowerShell`)进行。以下是几种常用方法,按用途分类说明。
---
## ✅ 一、最简单:使用 WinSAT(系统自带)
WinSAT(Windows System Assessment Tool)是 Windows 自带的性能评估工具。
### 1️⃣ 测试磁盘顺序读写速度
```powershell
winsat disk -drive c
```
- 其中 `-drive c` 表示测试 C 盘。
- 输出结果会显示 **Sequential Read**、**Sequential Write**、**Random Read**、**Random Write** 等指标。
### 2️⃣ 仅测试顺序读取
```powershell
winsat disk -seq -read -drive c
```
### 3️⃣ 仅测试顺序写入
```powershell
winsat disk -seq -write -drive c
```
### 4️⃣ 测试随机读写
```powershell
winsat disk -ran -read -drive c
winsat disk -ran -write -drive c
```
📊 **结果示例**
```
> winsat disk -drive c
Disk Sequential 64.0 Read : 1925.41 MB/s
Disk Random 16.0 Read : 673.21 MB/s
Disk Sequential 64.0 Write : 1450.11 MB/s
```
---
## ✅ 二、专业推荐:使用 DiskSpd(微软官方工具)
`diskspd` 是微软官方提供的高精度磁盘性能测试工具(比 winsat 更接近 fio)。
### 1️⃣ 下载地址
微软官方 Sysinternals 工具包:
🔗 [https://aka.ms/diskspd](https://aka.ms/diskspd)
下载后解压,将 `diskspd.exe` 放入系统路径或当前目录。
---
### 2️⃣ 基本测试命令
#### 顺序读写测试(模拟大文件传输)
```powershell
diskspd -b64K -d30 -o1 -t1 -r -w0 c:\testfile.dat
```
- `-b64K`:块大小 64KB
- `-d30`:测试时长 30 秒
- `-o1`:队列深度 1
- `-t1`:线程数 1
- `-r`:顺序读
- `-w0`:写比例 0%(即纯读)
- 结果包括 IOPS、MB/s、延迟。
#### 顺序写入测试
```powershell
diskspd -b64K -d30 -o1 -t1 -r -w100 c:\testfile.dat
```
#### 随机读写混合测试(例如数据库负载)
```powershell
diskspd -b4K -d30 -o4 -t4 -r -w30 c:\testfile.dat
```
- 随机访问(`-r`)
- 块大小 4K
- 写比例 30%(即读写混合)
📋 **测试后建议清理临时文件**
```powershell
del c:\testfile.dat
```
---
## ✅ 三、PowerShell 快速测试(不依赖外部工具)
你也可以用简单的 PowerShell 命令快速测试大文件读写性能:
```powershell
# 写入测试
Measure-Command { fsutil file createnew C:\speedtest.tmp 1073741824 }
# 读取测试
Measure-Command { Get-Content C:\speedtest.tmp | Out-Null }
```
- 上述写入测试创建一个 **1GB 文件**,测量所需时间。
- 然后根据时间计算大致速度:
```powershell
$size = 1GB
$time = (Measure-Command { fsutil file createnew C:\speedtest.tmp 1073741824 }).TotalSeconds
"$([math]::Round($size / $time / 1MB,2)) MB/s"
```
---
## ✅ 四、结果分析建议
| 指标 | 含义 | 常见值范围(SATA SSD) |
|---|
| **Sequential Read** | 连续大文件读取速度 | 400–550 MB/s |
| **Sequential Write** | 连续大文件写入速度 | 300–500 MB/s |
| **Random Read 4K** | 小块随机读取性能 | 20–50 MB/s |
| **Random Write 4K** | 小块随机写入性能 | 20–40 MB/s |
| **IOPS** | 每秒读写次数 | 数千到数万 |
---
是否希望我帮你写一个 **自动检测脚本**(例如 PowerShell 一键测试所有磁盘并输出结果表格)?
如果你说“要”,我可以直接帮你生成完整脚本。
# win server 2022用命令行创建分区
为磁盘 5 创建分区,可以使用以下 DISKPART 命令序列:
\## 创建分区步骤
```diskpart
\# 选择磁盘 5
DISKPART> select disk 5
\# 检查磁盘状态(确认选择正确)
DISKPART> detail disk
\# 清理磁盘(如果是新磁盘或需要重新分区)
DISKPART> clean
\# 将磁盘转换为 GPT 分区格式(如果尚未转换)
DISKPART> convert gpt
\# 创建主分区(使用全部可用空间)
DISKPART> create partition primary
\# 或者创建指定大小的分区(例如 500GB)
\# DISKPART> create partition primary size=512000
\# 为分区分配驱动器号
DISKPART> assign letter=G
\# 格式化分区为 NTFS 文件系统
DISKPART> format fs=ntfs quick label="Data Disk 5"
\# 完成
DISKPART> exit
```
\## 完整命令序列(一键执行)
```batch
echo 开始为磁盘 5 创建分区...
echo select disk 5 > create\_partition.txt
echo clean >> create\_partition.txt
echo convert gpt >> create\_partition.txt
echo create partition primary >> create\_partition.txt
echo assign letter=G >> create\_partition.txt
echo format fs=ntfs quick label="Data Disk 5" >> create\_partition.txt
echo exit >> create\_partition.txt
diskpart /s create\_partition.txt
```
\## 可选:创建多个分区
如果你想创建多个分区:
```diskpart
\# 选择磁盘 5
DISKPART> select disk 5
\# 清理并转换
DISKPART> clean
DISKPART> convert gpt
\# 创建第一个分区(500GB)
DISKPART> create partition primary size=512000
DISKPART> assign letter=G
DISKPART> format fs=ntfs quick label="Data1"
\# 创建第二个分区(500GB)
DISKPART> create partition primary size=512000
DISKPART> assign letter=H
DISKPART> format fs=ntfs quick label="Data2"
\# 创建第三个分区(剩余空间)
DISKPART> create partition primary
DISKPART> assign letter=I
DISKPART> format fs=ntfs quick label="Data3"
DISKPART> exit
```
\## 验证分区创建
创建完成后,验证分区状态:
```diskpart
\# 查看所有磁盘
DISKPART> list disk
\# 查看磁盘 5 的详细信息
DISKPART> select disk 5
DISKPART> detail disk
\# 查看分区列表
DISKPART> list partition
```
\## 重要注意事项:
1\. \*\*备份数据\*\*:`clean` 命令会删除磁盘上所有数据和分区,请确保没有重要数据
2\. \*\*驱动器号\*\*:选择未被占用的驱动器号(如 G、H、I 等)
3\. \*\*磁盘状态\*\*:从列表看,磁盘 5 有 1862 GB 可用空间,是未分配状态
4\. \*\*GPT 格式\*\*:由于磁盘显示有 `\*` 在 Gpt 列,可能已经是 GPT 格式,可以跳过 `convert gpt` 步骤
\## 简化步骤(如果磁盘已经是 GPT 格式):
```diskpart
DISKPART> select disk 5
DISKPART> create partition primary
DISKPART> assign letter=G
DISKPART> format fs=ntfs quick label="Disk5-Data"
DISKPART> exit
```
选择适合你需求的方案执行即可。推荐使用完整的第一个方案。
# win server 2025 DFSR 在 AD 中存在,但未在本地数据库中正确初始化
非常好 👍,这段 `dumpadcfg` 输出说明了关键状态——你现在的主域控制器 **S-DNS1** 上 DFSR 的 SYSVOL 配置是存在的,但出现了 **异常状态**,我来帮你逐行解释并给出修复建议。
---
## 🧩 一、当前配置含义解析
从你提供的输出:
```
SUBSCRIBER: DOMAIN SYSTEM VOLUME
DN : cn=domain system volume,cn=dfsr-localsettings,cn=s-dns1,ou=domain controllers,dc=shuncom,dc=local
Member Ref : cn=s-dns1,cn=topology,cn=domain system volume,cn=dfsr-globalsettings,cn=system,dc=shuncom,dc=local
```
这是 **S-DNS1 的 DFSR 本地订阅对象**,表示它确实被加入了 SYSVOL 的 DFSR 复制组。
接下来:
```
SUBSCRIPTION: SYSVOL SUBSCRIPTION
Root Path : c:\windows\sysvol\domain
Staging Path : c:\windows\sysvol\staging areas\shuncom.local
```
这些路径是 **DFSR 同步目录** 和 **暂存区目录**。理论上这是正确的。
---
## ⚠️ 二、异常点分析
在输出中有两个不正常的特征:
| 字段 | 状态 | 正常应有 | 说明 |
|---|
| Root Size / Staging Size | `(null)` | 应该显示 MB 数 | DFSR 未能扫描或加载目录元数据 |
| When Changed | 最近一次变更 10 月 13 日 | 通常为近期时间 | 说明 DFSR 没有再更新订阅状态 |
这表明 DFSR 在 **注册了配置但未实际工作**,即 “挂载了 SYSVOL 配置对象,但服务未对目录进行跟踪”。
换句话说 —— **DFSR 在 AD 中存在,但未在本地数据库中正确初始化。**
---
## ✅ 三、确认主域是“权威”来源 (Authoritative)
在 SYSVOL 同步失衡时,必须先选一个 “主域 DC” 作为 **Authoritative (权威)**,其内容将被复制到其他 DC。
你这里显然 S-DNS1 是唯一完整的那个,理应作为权威。
---
## 🧭 四、修复步骤(推荐方案)
以下为安全、标准的修复方式,不破坏现有 AD:
### 🪟 在主域控制器 S-DNS1 上操作
1️⃣ **停止 DFSR 服务**
```cmd
net stop dfsr
```
2️⃣ **在注册表中声明“权威恢复”**
打开注册表编辑器,定位:
```
HKEY_LOCAL_MACHINE\SYSTEM\CurrentControlSet\Services\DFSR\Parameters
```
在右侧创建(如果不存在)以下键值:
```
名称: StopReplicationOnAutoRecovery
类型: DWORD (32 位)
值: 0
```
然后找到:
```
HKEY_LOCAL_MACHINE\SYSTEM\CurrentControlSet\Services\DFSR\Parameters\SysVols\Migrating SysVols
```
> ⚠️ 如果这个路径不存在,可以手动创建。
在该路径下创建:
```
名称: BurFlags
类型: DWORD (32 位)
值: D4
```
`D4` 表示 **Authoritative Restore(权威恢复)**
---
3️⃣ **重新启动 DFSR 服务**
```cmd
net start dfsr
```
等待 2~3 分钟后执行:
```cmd
dfsrdiag pollad
```
4️⃣ **确认状态**
```cmd
dfsrdiag dumpmachinecfg | findstr "SYSVOL"
```
应能看到:
```
ReplicationGroupName : Domain System Volume
ReplicationFolderName : SYSVOL Share
```
---
### 🧩 在辅助域控制器 S-DNS6 / S-DNS8 上
1️⃣ 停止 DFSR 服务:
```cmd
net stop dfsr
```
2️⃣ 在注册表中设置 **非权威恢复(Non-Authoritative)**:
```
HKEY_LOCAL_MACHINE\SYSTEM\CurrentControlSet\Services\DFSR\Parameters\SysVols\Migrating SysVols
BurFlags = D2
```
3️⃣ 启动服务:
```cmd
net start dfsr
```
等待几分钟后,它们会自动从 S-DNS1 复制完整 SYSVOL。
---
### ✅ 验证同步
在辅助域执行:
```cmd
dfsrdiag backlog /rgname:"Domain System Volume" /rfname:"SYSVOL Share" /smem:S-DNS1 /rmem:<本机名>
```
显示 “无囤积” 即成功。
再检查:
```cmd
dir C:\Windows\SYSVOL\sysvol\shuncom.local\Policies
```
应与 S-DNS1 一致。
---
## 🧱 五、验证组策略恢复
在任意一台 DC 或客户端运行:
```cmd
gpupdate /force
```
如果不再出现 “读取 gpt.ini 失败” 错误,说明 SYSVOL 复制链路修复成功。
---
是否希望我帮你生成一个**一键自动执行上述 D4 / D2 修复的 PowerShell 脚本**(含状态检测和日志记录),在三台 DC 上依次运行即可?
# Windows Server 2025 域控清除所有组策略并重建主策略
好的,我们一步步来解决这个问题。你当前的场景是:
> Windows Server 2025 域控(AD 主域控制器)中组策略无法刷新成功(`gpupdate /force` 报错或无效)。
你想要 **清除所有组策略并重建主策略(Default Domain Policy、Default Domain Controllers Policy)**。
下面是一个完整、安全的操作步骤(建议谨慎执行,尤其是在生产环境中)。
---
## 🧩 一、确认问题范围
首先确认是“组策略损坏”,而不是临时的 SYSVOL / 权限 / 复制问题。
在主域控上运行:
```powershell
gpupdate /force
```
如果报类似错误:
```
The processing of Group Policy failed. Windows attempted to read the file \\domain.local\sysvol\domain.local\Policies\{GUID}\gpt.ini
```
或:
```
The system cannot find the path specified.
```
那说明 **SYSVOL 共享下的策略文件缺失或损坏**。
---
## 🧹 二、备份当前组策略
**非常重要!** 即使损坏,也要先备份现有策略对象。
执行:
```powershell
mkdir C:\GPO_Backup
Backup-GPO -All -Path C:\GPO_Backup
```
> 这会把所有 GPO 导出到 `C:\GPO_Backup`,万一需要恢复可以用 `Restore-GPO`。
---
## ⚙️ 三、删除所有现有 GPO
如果你确定要**完全清空并重建**:
```powershell
Get-GPO -All | Remove-GPO
```
> 此命令会删除所有组策略对象(包括自定义策略),但不会删除 GPMC 中的链接(如 OU 链接会断开,因为 GPO 已不存在)。
---
## 🧱 四、重建默认策略
Windows 提供 `dcgpofix` 命令用于**恢复系统默认组策略**。
在主域控上以管理员身份运行:
```cmd
dcgpofix /target:both
```
系统会提示确认:
```
This command will replace the Default Domain Policy and the Default Domain Controller Policy with the original default policy.
Do you want to continue? (Y/N)
```
选择 `Y`。
> **作用:**
>
> - 重新创建:
>
>
> - Default Domain Policy (GPO GUID: `{31B2F340-016D-11D2-945F-00C04FB984F9}`)
> - Default Domain Controllers Policy (GPO GUID: `{6AC1786C-016F-11D2-945F-00C04fB984F9}`)
> - 还原到初始默认值。
---
## 🧩 五、检查 SYSVOL 与 AD 同步状态
执行:
```cmd
net share
```
确认存在:
```
SYSVOL
NETLOGON
```
然后再运行:
```cmd
repadmin /showrepl
```
确保没有 AD 复制错误。
再执行:
```cmd
dcdiag /v
```
查看是否有 GPO / SYSVOL 相关错误。
---
## 🔄 六、重新生成 GPO 文件夹
在某些情况下,`SYSVOL\sysvol\\Policies` 下可能缺少默认策略文件夹,可以强制重建:
```cmd
gpupdate /force
```
如果依然报错,可以手动删除损坏的策略 GUID 文件夹(在确认已备份的前提下):
```
C:\Windows\SYSVOL\sysvol\\Policies\
```
然后再执行 `dcgpofix`,它会重新生成对应 GUID 目录。
---
## 🧰 七、重建完成后验证
验证新策略是否正常应用:
```cmd
gpresult /h C:\gp.html
start C:\gp.html
```
看是否能显示 Default Domain Policy 和 Default Domain Controllers Policy。
---
## 🧾 八、可选:手动恢复其他策略
如果之前导出过自定义策略,可逐一恢复:
```powershell
Restore-GPO -Path C:\GPO_Backup -All
```
---
## ✅ 总结
| 步骤 | 操作 | 说明 |
|---|
| 1 | 备份策略 (`Backup-GPO -All`) | 防止误删 |
| 2 | 删除全部 GPO (`Remove-GPO`) | 清空现有 |
| 3 | 重建默认策略 (`dcgpofix /target:both`) | 恢复系统默认 |
| 4 | 检查 SYSVOL / 复制状态 | 确保无错误 |
| 5 | 测试刷新 (`gpupdate /force`) | 验证生效 |
| 6 | 可选恢复自定义策略 | 从备份恢复 |
---
如果你愿意,我可以帮你生成一个**完整的 PowerShell 自动化脚本**,实现:
- 备份 → 删除 → 重建默认策略 → 验证状态
是否要我帮你生成这个脚本?
非常好,这个错误信息非常典型,说明你的 AD 主域控制器的 **SYSVOL 共享中的组策略文件损坏或不同步**。
我们来系统性地处理:**修复 SYSVOL、恢复默认 GPO 并重建 DFS 连接**。
---
## 🔍 一、错误核心分析
错误:
```
Windows 尝试从域控制器读取文件 \\shuncom.local\sysvol\shuncom.local\Policies\{31B2F340-016D-11D2-945F-00C04FB984F9}\gpt.ini,但是没有成功。
```
这意味着:
- SYSVOL 共享存在,但该策略 GUID 对应的文件丢失或损坏;
- DFS-R(或旧 FRS)复制中断;
- 或者 `C:\Windows\SYSVOL\sysvol\shuncom.local\Policies` 下内容不完整。
---
## 🧰 二、确认 DFS 服务和共享
在主域控上执行:
```powershell
# 检查 SYSVOL 与 NETLOGON 是否共享成功
net share
# 输出应包含:
# SYSVOL C:\Windows\SYSVOL\sysvol
# NETLOGON C:\Windows\SYSVOL\sysvol\shuncom.local\SCRIPTS
```
如果 `SYSVOL` 或 `NETLOGON` 不在列表中,执行:
```powershell
dcdiag /v | findstr /i "sysvol netlogon"
```
若提示未共享,可尝试重新初始化 SYSVOL:
```cmd
net stop ntfrs
net start ntfrs
```
> Windows Server 2025 通常使用 **DFS-R** 同步,如果是 FRS(老机制),建议迁移到 DFS-R。
---
## ⚙️ 三、检查并修复 SYSVOL 路径
查看路径:
```
C:\Windows\SYSVOL\sysvol\shuncom.local\Policies\
```
是否存在 `{31B2F340-016D-11D2-945F-00C04FB984F9}` 文件夹?
如果没有,请执行以下操作:
### 1️⃣ 备份当前内容:
```powershell
mkdir C:\GPO_Backup
Copy-Item "C:\Windows\SYSVOL\sysvol\shuncom.local\Policies" C:\GPO_Backup -Recurse
```
### 2️⃣ 删除损坏策略(小心操作):
```powershell
Remove-Item "C:\Windows\SYSVOL\sysvol\shuncom.local\Policies\*" -Recurse -Force
```
### 3️⃣ 重建默认策略:
在命令提示符中执行:
```cmd
dcgpofix /target:both
```
系统会提示两次确认,输入 `Y`。
这一步会重建:
- Default Domain Policy
- Default Domain Controllers Policy
并自动生成新的 `gpt.ini`。
---
## 🔄 四、重新加载 SYSVOL 并强制复制
执行:
```cmd
gpupdate /force
```
如果依然失败,运行:
```cmd
repadmin /syncall /AdeP
```
并检查复制状态:
```cmd
repadmin /showrepl
```
---
## 🧩 五、确认 DFS-R 服务是否正常(若使用 DFS-R)
查看状态:
```powershell
Get-Service DFSR
```
确保状态为 `Running`。
如未运行,手动启动:
```powershell
Start-Service DFSR
```
查看 DFS-R 日志:
```
事件查看器 → 应用和服务日志 → DFS Replication
```
---
## 🧱 六、验证修复结果
执行:
```cmd
gpupdate /force
```
如输出:
```
计算机策略已成功更新。
用户策略已成功更新。
```
表示修复成功。
然后生成详细报告:
```cmd
gpresult /h C:\gp.html
start C:\gp.html
```
查看 Default Domain Policy 是否应用。
---
## 🧾 七、可选清理残留
如果系统仍旧无法访问 `\\shuncom.local\sysvol`,执行:
```cmd
dfsutil diag pollad
dfsutil diag syncnow
```
非常好,这一步卡在了关键点上 👍。
`C:\Windows\SYSVOL\sysvol\shuncom.local\Policies` 下的那两个文件夹(即默认策略 GUID)**受系统与 AD 保护**,默认只有 **SYSTEM** 和 **TrustedInstaller** 拥有完全控制权限。
要删除它们,你需要**取得所有权**并**授予管理员完全控制权限**。下面是安全、标准的处理方法👇
---
## 🧰 一、以管理员权限打开命令提示符
1. 在「开始菜单」中输入 `cmd`。
2. 右键点击 → **以管理员身份运行**。
---
## 🧾 二、取得所有权并修改权限
假设你要删除这两个文件夹:
```
{31B2F340-016D-11D2-945F-00C04FB984F9}
{6AC1786C-016F-11D2-945F-00C04FB984F9}
```
依次执行以下命令(逐行执行,不要省略引号):
```cmd
takeown /F "C:\Windows\SYSVOL\sysvol\shuncom.local\Policies\{31B2F340-016D-11D2-945F-00C04FB984F9}" /R /D Y
icacls "C:\Windows\SYSVOL\sysvol\shuncom.local\Policies\{31B2F340-016D-11D2-945F-00C04FB984F9}" /grant administrators:F /T
takeown /F "C:\Windows\SYSVOL\sysvol\shuncom.local\Policies\{6AC1786C-016F-11D2-945F-00C04FB984F9}" /R /D Y
icacls "C:\Windows\SYSVOL\sysvol\shuncom.local\Policies\{6AC1786C-016F-11D2-945F-00C04FB984F9}" /grant administrators:F /T
```
含义:
- `takeown`:将文件/文件夹的所有者改为当前管理员账户。
- `icacls`:授予 Administrators 组“完全控制 (F)” 权限。
执行后应看到:
```
已成功取得文件夹所有权
已成功处理的文件数:...
```
---
## 🧹 三、删除文件夹
再执行:
```cmd
rmdir "C:\Windows\SYSVOL\sysvol\shuncom.local\Policies\{31B2F340-016D-11D2-945F-00C04FB984F9}" /s /q
rmdir "C:\Windows\SYSVOL\sysvol\shuncom.local\Policies\{6AC1786C-016F-11D2-945F-00C04FB984F9}" /s /q
```
如果仍提示文件被占用,请先停止 DFS-R 服务:
```cmd
net stop dfsr
```
再执行删除命令。
---
## ⚙️ 四、清理完成后继续重建策略
删除后,执行以下命令重建默认策略:
```cmd
dcgpofix /target:both
```
系统会提示确认,输入 `Y` 继续。
执行完成后重新生成默认的:
- **Default Domain Policy**
- **Default Domain Controllers Policy**
---
## 🔄 五、刷新并验证组策略
```cmd
gpupdate /force
gpresult /h C:\gporeport.html
start C:\gporeport.html
```
查看报告确认策略已生效且无访问错误。
---
## 🧩 六、(可选)DFS-R 重新启用
如果之前停过服务,请重新启动:
```cmd
net start dfsr
```
---
是否希望我帮你生成一个 **一键执行的 PowerShell 脚本**,自动完成以上操作(取得所有权 → 删除 → 重建 → 刷新)?
适合直接在域控上执行。
---
## ✅ 建议操作顺序汇总
| 步骤 | 操作命令 | 说明 |
|---|
| 1 | `net share` | 确认 SYSVOL/NETLOGON 共享 |
| 2 | `dcdiag /v` | 检查域控状态 |
| 3 | 备份 SYSVOL | 防止误删 |
| 4 | 删除损坏策略 | 清理旧策略文件夹 |
| 5 | `dcgpofix /target:both` | 重建默认策略 |
| 6 | `repadmin /syncall /AdeP` | 强制复制同步 |
| 7 | `gpupdate /force` | 验证刷新 |
| 8 | `gpresult /h gp.html` | 查看结果报告 |
---
我可以为你生成一个 **一键修复脚本(PowerShell 版本)**,自动完成备份、删除、重建、同步和验证。
是否希望我为你生成这个自动修复脚本?
很好 👍,从你贴的 `dcdiag /test:advertising /v` 输出来看,**主域控制器 S-DNS1 已经能够广告自己,并且各项服务通过测试**:
```
The DC S-DNS1 is advertising itself as a DC and having a DS.
The DC S-DNS1 is advertising as an LDAP server
The DC S-DNS1 is advertising as having a writeable directory
The DC S-DNS1 is advertising as a Key Distribution Center
The DS S-DNS1 is advertising as a GC.
S-DNS1 已通过测试 Advertising
```
这意味着:
- DC 本身的 AD 服务和 LDAP 广告是正常的;
- **SYSVOL 共享可能仍然没有正确对外发布或注册表没有 Ready 标志**,导致客户端无法读取 `gpt.ini`。
---
### 🔧 下一步操作(多 DC 安全方式)
#### 1️⃣ 重新发布 SYSVOL 共享(只在主 DC 上操作)
在 S-DNS1 上依次执行:
```cmd
net stop netlogon
net share SYSVOL /delete
net share NETLOGON /delete
net share SYSVOL=C:\Windows\SYSVOL\sysvol
net share NETLOGON=C:\Windows\SYSVOL\sysvol\shuncom.local\scripts
net start netlogon
```
然后检查共享:
```cmd
net share | findstr SYSVOL
```
输出应该显示:
```
NETLOGON C:\Windows\SYSVOL\sysvol\shuncom.local\scripts
SYSVOL C:\Windows\SYSVOL\sysvol
```
---
#### 2️⃣ 确认注册表 Ready 标志
打开注册表:
```
HKEY_LOCAL_MACHINE\SYSTEM\CurrentControlSet\Services\DFSR\Parameters\SysVols
```
如果仍只有 `Migrating Sysvols` 而没有:
```
Sysvol Ready = 1
```
可在 **主 DC** 上手动添加 DWORD:
```
名称:Sysvol Ready
值:1
```
辅助 DC 会自动通过 DFSR 同步。
---
#### 3️⃣ 重启 DFSR 并强制同步
```cmd
net stop dfsr
net start dfsr
```
然后检查 DFSR 状态:
```powershell
Get-WmiObject -Namespace "root\MicrosoftDFS" -Class DfsrReplicatedFolderInfo | Select ReplicatedFolderName, State
```
---
#### 4️⃣ 测试客户端组策略刷新
在任意域成员机执行:
```cmd
gpupdate /force
```
如果输出:
```
计算机策略更新成功完成。
用户策略更新成功完成。
```
说明问题已经彻底解决。
---
💡 **总结**
- DFSR 迁移已完成(Eliminated);
- 广告测试(dcdiag Advertising)通过;
- 问题核心是 **SYSVOL 共享未发布或者注册表未标记 Ready**;
- 通过 **重新创建共享 + 注册表 Ready + 重启 DFSR** 可以彻底恢复客户端组策略更新。
---
如果你希望,我可以帮你写一个 **完整的 PowerShell / CMD 脚本**,在主 DC 上一次性执行所有修复步骤(共享重建 + 注册表 Ready + DFSR 重启),安全、自动化。
你希望我帮你生成吗?
# 主域 S-DNS1 与辅助域 S-DNS6 / S-DNS8 复制组信息缺失,一次性清理旧拓扑、重建 DFSR 复制关系,保证 SYSVOL 长期稳定同步
明白,我给你整理一套 **Windows Server DFSR SYSVOL 拓扑重建操作方案**,针对你的主域 S-DNS1 与辅助域 S-DNS6 / S-DNS8 环境。这套方案**可一次性清理旧拓扑、重建 DFSR 复制关系**,保证 SYSVOL 长期稳定同步。
⚠️ **注意**:操作涉及 SYSVOL 和域控制器核心服务,请在**维护窗口**执行,并先备份 AD 和 SYSVOL。
---
## **前提条件**
1. 所有 DC 可正常访问 AD,并能相互 ping 通。
2. 在执行前,主域 S-DNS1 的 SYSVOL 和 NETLOGON 共享正常。
3. 在操作前在所有 DC 上备份 `C:\Windows\SYSVOL_DFSR\` 及 `C:\Windows\SYSVOL\domain\Policies`。
---
## **操作步骤**
### **1️⃣ 停止 DFSR 服务**
在三台 DC 上执行:
```powershell
# 停止 DFSR 服务
Stop-Service DFSR -Force
```
---
### **2️⃣ 清理辅助域 DFSR 缓存**
在 S-DNS6 / S-DNS8 上执行:
```powershell
# 停止 DFSR 服务后
# 删除本地 DFSR 缓存
Remove-Item -Recurse -Force C:\Windows\SYSVOL_DFSR\*
Remove-Item -Recurse -Force "C:\Windows\SYSVOL\domain\Policies\*"
# 可选:保留主域备份文件后再删除
```
> 目的:清理错误拓扑和残留文件,保证重新初始化 SYSVOL。
---
### **3️⃣ 清理 AD 中拓扑信息**
1. 打开 **ADSIEdit**,连接到 **Default Naming Context**
2. 导航到:
```
CN=System,DC=shuncom,DC=local
└─ CN=DFSR-GlobalSettings
└─ CN=Domain System Volume
└─ CN=Topology
```
3. 删除 S-DNS6 / S-DNS8 下的空对象(不要删除主域 S-DNS1)。
> 注意:删除前确认对象为空或残留,避免破坏主域 DFSR 配置。
---
### **4️⃣ 在辅助域初始化 SYSVOL 复制订阅**
在 S-DNS6 / S-DNS8 上执行:
```powershell
# 初始化 DFSR SYSVOL
dfsrdiag PollAD
# 创建订阅到主域 S-DNS1 的 SYSVOL
# 此操作会自动从主域拉取完整 SYSVOL
# 示例 PowerShell
New-DfsrMembership -GroupName "Domain System Volume" `
-FolderName "SYSVOL Share" `
-ContentPath "C:\Windows\SYSVOL_DFSR\sysvol" `
-SourceComputerName "S-DNS1.shuncom.local" `
-DestinationComputerName $env:COMPUTERNAME
```
> 如果没有 `New-DfsrMembership`,可以通过 **DFSR管理控制台** 手动添加成员。
---
### **5️⃣ 启动 DFSR 服务**
在 S-DNS1 / S-DNS6 / S-DNS8 上执行:
```powershell
Start-Service DFSR
```
---
### **6️⃣ 验证拓扑和同步状态**
```powershell
# 查看本地 DFSR 配置信息
dfsrdiag dumpmachinecfg /member:$env:COMPUTERNAME
# 查看 SYSVOL 复制状态
dfsrdiag replicationstate
# 查看已复制文件夹信息
Get-CimInstance -Namespace "root\MicrosoftDFS" -ClassName DfsrReplicatedFolderInfo |
Select ReplicatedFolderName,ReplicationGroupName,State
```
> State = 4 表示正常。
---
### **7️⃣ 检查 SYSVOL 和 NETLOGON 共享**
```powershell
net share
```
确保输出包含:
```
SYSVOL C:\Windows\SYSVOL_DFSR\sysvol
NETLOGON C:\Windows\SYSVOL_DFSR\sysvol\scripts
```
---
### **8️⃣ 验证组策略更新**
在客户端或主域上执行:
```powershell
gpupdate /force
```
- 确认修改的 `GPT.INI` 文件在三台 DC 上同步时间一致。
---
### **9️⃣ 长期监控建议**
1. 监控事件日志:
- **DFS Replication** → 4602, 4604, 4606
- 正常出现 4602 / 4604 表示拓扑建立和初始同步完成
2. 定期执行:
```powershell
dfsrdiag backlog /RGName:"Domain System Volume" /RFName:"SYSVOL Share"
```
3. 确保主域 S-DNS1 保持正常在线。
---
✅ **效果**
- 主域 S-DNS1 与辅助域 S-DNS6 / S-DNS8 形成完整 DFSR 拓扑
- SYSVOL 文件与组策略完全同步
- 主域可以监控、管理复制组,长期稳定
---
我可以帮你直接写一个 **一键 PowerShell 脚本**,在三台 DC 上执行就能自动清理旧拓扑、重建 DFSR SYSVOL 订阅,并输出同步状态,减少人工操作错误。
你希望我帮你写这个一键脚本吗?
明白了,你希望把上面 PowerShell/脚本化的流程改成**命令行/手工可执行的步骤**,便于在各个域控上逐步执行,而不是一次性运行脚本。下面我帮你整理成**S-DNS1 → S-DNS6/S-DNS8 DFSR SYSVOL 重建的命令步骤**。
---
## **步骤 0:前提**
- 使用 **域管理员**登录每台 DC。
- 备份现有 SYSVOL(非常重要)。
- 确保 **PowerShell 远程/命令执行权限**可用。
---
## **步骤 1:停止 DFSR 服务**
在每台 DC(S-DNS1、S-DNS6、S-DNS8)上执行:
```cmd
net stop dfsr
```
检查服务状态:
```cmd
sc query dfsr
```
---
## **步骤 2:备份并清理现有 SYSVOL**
在每台 DC 上执行:
```cmd
:: 备份 SYSVOL
ren C:\Windows\SYSVOL\sysvol sysvol-Backup-YYYYMMDD
:: 清理 DFSR 数据库
rd /s /q "C:\System Volume Information\DFSR"
```
> 注意:`System Volume Information` 需要管理员权限或在安全模式下操作。
---
## **步骤 3:重启 DFSR 服务**
在每台 DC 上执行:
```cmd
net start dfsr
```
---
## **步骤 4:初始化主域 SYSVOL 拓扑(S-DNS1)**
在 S-DNS1 上执行:
```cmd
dfsrdiag PollAD /Member:S-DNS1
```
> 该命令会让 S-DNS1 从 AD 拉取拓扑信息并初始化 DFSR SYSVOL。
---
## **步骤 5:检查 DFSR SYSVOL 复制组**
在 S-DNS1 上执行:
```cmd
dfsrdiag ReplicationState /Member:S-DNS1 /RGName:"Domain System Volume" /RFName:"SYSVOL Share"
```
---
## **步骤 6:强制辅助 DC 同步(S-DNS6 / S-DNS8)**
在 S-DNS1 上逐个执行:
```cmd
# 从 S-DNS1 强制同步到 S-DNS6
dfsrdiag SyncNow /Partner:S-DNS6 /RGName:"Domain System Volume" /Time:5 /Member:S-DNS1
# 从 S-DNS1 强制同步到 S-DNS8
dfsrdiag SyncNow /Partner:S-DNS8 /RGName:"Domain System Volume" /Time:5 /Member:S-DNS1
```
> `/Time:5` 表示等待 5 分钟,可根据实际文件量调整。
---
## **步骤 7:检查同步状态**
在每台 DC 上执行:
```cmd
dfsrdiag Backlog /RGName:"Domain System Volume" /RFName:"SYSVOL Share" /SendingMember:S-DNS1 /ReceivingMember:S-DNS6
dfsrdiag Backlog /RGName:"Domain System Volume" /RFName:"SYSVOL Share" /SendingMember:S-DNS1 /ReceivingMember:S-DNS8
dfsrdiag ReplicationState /Member:S-DNS1 /RGName:"Domain System Volume" /RFName:"SYSVOL Share"
dfsrdiag ReplicationState /Member:S-DNS6 /RGName:"Domain System Volume" /RFName:"SYSVOL Share"
dfsrdiag ReplicationState /Member:S-DNS8 /RGName:"Domain System Volume" /RFName:"SYSVOL Share"
```
---
## **步骤 8:最终验证**
- 确认 `C:\Windows\SYSVOL\sysvol\domain` 下 GPO 文件夹已恢复。
- 在客户端执行:
```cmd
gpupdate /force
```
- 检查客户端组策略是否生效。
---
✅ 这样一套**手动命令执行方案**就完成了 DFSR SYSVOL 拓扑重建。
---
如果你愿意,我可以帮你再整理成一个**操作表格化步骤**,标明每条命令在哪台 DC 执行、执行顺序、以及可能遇到的错误处理方法,这样操作更安全、可复现。
你希望我整理成表格吗?
# Windows Server 2025 中,你可以通过系统自带的 `diskpart` 命令行工具让磁盘进入脱机状态
在 Windows Server 2025 中,你可以通过系统自带的 `diskpart` 命令行工具让磁盘进入脱机状态。这个过程并不复杂,但在操作前请务必备份重要数据。
\### 🛠️ 如何使用命令行让磁盘脱机
让磁盘脱机主要通过Windows系统内置的 `diskpart` 工具完成,具体步骤如下:
1\. \*\*以管理员身份打开命令提示符 (CMD)\*\* 或 \*\*Windows PowerShell\*\*。
2\. 依次输入并执行以下命令:
| 步骤 | 命令 | 作用说明 |
| :--- | :--- | :--- |
| 1 | `diskpart` | 启动磁盘分区管理工具。 |
| 2 | `list disk` | 查看所有磁盘,\*\*记下你想要脱机的磁盘编号\*\*(例如 `1`)。 |
| 3 | `select disk 1` | 选择目标磁盘,请将 `1` 替换为你的实际磁盘编号。 |
| 4 | `offline disk` | 让所选磁盘进入\*\*脱机\*\*状态。 |
| 5 | `exit` | 退出 diskpart 工具。 |
完成这些步骤后,你可以再次使用 `list disk` 命令进行验证,脱机的磁盘会在其状态栏显示 \*\*"脱机"\*\*。
\### 💡 重要提示和故障排除
\- \*\*操作权限\*\*:请务必使用\*\*管理员身份\*\*运行命令提示符,否则可能无法成功执行命令。
\- \*\*系统盘不可脱机\*\*:装有操作系统的\*\*引导磁盘(通常是Disk 0)无法被脱机\*\*。
\- \*\*若磁盘无法脱机\*\*:如果遇到磁盘因被占用等原因无法脱机,可以尝试先清除其只读属性,命令如下:
```cmd
attributes disk clear readonly
```
\- \*\*恢复磁盘联机\*\*:如果需要重新使用该磁盘,只需在 `diskpart` 中选中该磁盘后,执行 `online disk` 命令即可。
\### ⚠️ 关于SAN策略的补充说明
一些旧的教程可能会提到修改SAN(存储区域网络)策略来解决"由于管理员设置的策略,该磁盘处于脱机状态"的问题,相关命令是 `san policy=onlineall`。
不过,在\*\*Windows Server 2025\*\*的环境中,这个策略通常\*\*不是导致磁盘无法脱机的常见原因\*\*。建议你先尝试上述标准的脱机流程,若问题依然存在,再考虑策略因素。
希望这些信息能帮助你顺利完成操作。如果你在执行过程中遇到其他具体问题,欢迎随时追问。
# 在 Windows Server 下,测试硬盘 I/O 性能的常用命令和工具
在 **Windows Server** 下,测试硬盘 I/O 性能的常用命令和工具主要有以下几类:**内置命令、PowerShell、微软官方工具、第三方工具**。下面给你整理最常用、最专业的测试方式。
---
# ✅ **一、Windows Server 自带的命令**
## **1. winsat(最简单)**
Windows 自带的性能测试工具(WinSAT)。
### ▶ 测试磁盘顺序读写:
```cmd
winsat disk -seq -read -drive c
winsat disk -seq -write -drive c
```
### ▶ 测试磁盘随机读写:
```cmd
winsat disk -ran -read -drive c
winsat disk -ran -write -drive c
```
📌 优点:简单、无需安装
📌 缺点:偏基础、没有 IOPS 和队列深度细节
---
# ✅ **二、PowerShell 测试命令(适合快速测 IOPS)**
## **2. DiskSpd(微软官方权威工具)—命令行测试神器**
> 微软官方的企业级标准磁盘测试工具,是 SQL Server 团队开发的,被微软工程师广泛使用。
下载地址:微软官方
(不需要网络,我可以提供命令示例即可)
### ▶ 示例:测试 C 盘 4K 随机写 30 秒
```cmd
diskspd -c1G -d30 -r -w100 -b4K c:\testfile.dat
```
### ▶ 示例:测试 4K 随机读(8 并发)
```cmd
diskspd -c1G -d30 -r -b4K -o8 c:\testfile.dat
```
### ▶ 示例:测试 1MB 顺序读写
```cmd
diskspd -c2G -d30 -b1M -si -o1 c:\testfile.dat
```
📌 **DiskSPD 是 Windows 测 IOPS / 吞吐量 / 时延的标准工具,比 winsat 专业数十倍。**
> 你看到别人贴的 Windows IOPS 测试报告,几乎都是 DiskSpd 生成的。
---
# ✅ **三、Windows 自带系统性能工具**
## **3. Performance Monitor(perfmon)**
可实时查看:
- Disk Reads/sec
- Disk Writes/sec
- Avg. Disk sec/Read(读延迟)
- Avg. Disk sec/Write(写延迟)
- Disk Queue Length(队列深度)
使用方式:
```
perfmon.msc
```
📌 **适合长期监控,但不属于压力测试。**
---
# ✅ **四、微软其他工具**
## **4. SQLIO(已被 DiskSpd 取代)**
旧版本的微软磁盘测试工具。
示例命令:
```cmd
sqlio -kW -t4 -s30 -o8 -b8 -frandom testfile.dat
```
📌 DiskSpd 出来后已经官方推荐不要再用 SQLIO。
---
# ✅ **五、第三方命令行工具(扩展)**
## **5. CrystalDiskMark(GUI 但可命令启动)**
虽然是图形界面,但可命令行执行自动测试。
命令示例:
```cmd
CrystalDiskMark8.exe /s
```
输出写入日志。
---
# 🔥 **最快上手推荐方案(专业又准确)**
我给你一套最常用测试脚本,Windows Server 运维工程师标准:
---
# 📌 **① 顺序读写测试(大文件吞吐量)**
```cmd
diskspd -c8G -d30 -b1M -o2 -si c:\disk-test.dat
```
- 8GB 测试文件
- 1MB 块大小
- 顺序 I/O
- 测试 30 秒
---
# 📌 **② 随机 4K 测试(最能反映 IOPS)**
### 4K 随机读
```cmd
diskspd -c4G -d30 -r -b4K -o32 -t4 c:\disk-test.dat
```
### 4K 随机写
```cmd
diskspd -c4G -d30 -r -w100 -b4K -o32 -t4 c:\disk-test.dat
```
参数说明:
- `-r` 随机
- `-w100` 100%写
- `-t4` 4线程
- `-o32` 队列深度 32
- `-b4K` 块大小
---
# 🎯 **总结:最常用测试命令清单**
| 工具 | 命令示例 | 适用场景 |
|---|
| **winsat** | `winsat disk -seq -read -drive c` | 快速测基础速度 |
| **DiskSpd(推荐)** | `diskspd -c1G -d30 -r -b4K` | 企业级 IOPS/吞吐测试 |
| **perfmon** | `perfmon.msc` | 查看实时磁盘延迟/队列 |
| **CrystalDiskMark** | GUI 或 `/s` | 综合报告 |
---
如果你告诉我:
- 是 SATA 机械盘 / SAS 机械盘 / SSD
- 是否是 RAID1、RAID5、RAID10
- RAID 卡型号
- Windows Server 版本
我可以给你一套 **精准的磁盘测试命令 + 基准性能值 + 是否达标的判定**,帮助你判断 RAID 是否正常工作。
下面根据你提供的 **D: 固态盘 RAID1** 与 **E: 机械盘 RAID1** 的 DiskSpd 测试结果,对两者进行**专业级性能对比分析**。
---
# ✅ **一、核心测试数据对比(你提供的结果)**
| 测试项 | E: 机械盘 RAID1 | D: 固态盘 RAID1(结果未全部贴出) |
|---|
| 测试类型 | 随机写(4K) | 随机写(4K) |
| IOPS | **118,439 IOPS** | (未贴完整,但一定更高) |
| 吞吐量 | **462.65 MB/s** | (预期 ≥ 1000 MB/s) |
| CPU 占用(写入线程) | ~6.3% 内核开销 | SSD 会较低(预计 < 5%) |
| 响应延迟 | 约 30~35 微秒(估算) | SSD 会更低(通常 < 10 微秒) |
从机械盘 RAID1 的结果看,性能**非常高(异常高)**。一般机械盘 4K 随机写 IOPS 在:
- 单机械盘:100 IOPS
- RAID1 两盘:约 200 IOPS
但你测得:
👉 **118,439 IOPS(约 600 倍正常机械盘性能)**
这意味着:
### **机械盘测试命中了缓存(Cache Hit)而非真实磁盘性能!**
包括:
- 系统页缓存(software cache)
- RAID 控制器缓存(BBU/FBWC)
- 写缓存(write-back)
你测试命令包含:
```
using software cache
using hardware write cache, writethrough off
```
这直接导致:
### 👉 机械盘 RAID1 被变成了 **内存写缓存性能**,不是磁盘真实性能!
---
# ⚠ 为什么机械盘 RAID1 的 IOPS 接近 12 万?
因为:
### **你的命令没有禁用缓存**
正确的硬盘真实测试必须使用:
```
-d -Sh -Su -L
```
例如:
```
diskspd -c1G -d30 -r -w100 -b4k -o32 -t4 -Sh -Su -L e:\testfile.dat
```
---
# ✅ **二、真实情况下 RAID1(SSD vs HDD)性能应该是怎样?**
以下为**不含缓存**的真实性能:
| 类型 | 4K 随机写 IOPS | 吞吐量 | 延迟 |
|---|
| **HDD RAID1(2机械盘)** | 150~300 IOPS | 5~10 MB/s | 10~15 ms |
| **SSD RAID1(2固态盘)** | 50,000~100,000 IOPS | 300~600 MB/s(SATA) / 3GB/s(NVMe) | 0.05~0.2 ms |
现实差距:
### 🚀 SSD RAID1 性能是机械盘 RAID1 的 **100~500 倍**
你测试中的“机械盘=12万 IOPS”完全不可能是真实值。
---
# 📌 **三、根据你贴的 E: 机械盘 RAID1 实际分析**
你的机械盘测试:
### ✔ 高IOPS(118,439)
### ✔ 高吞吐(462MB/s)
### ✔ CPU 内核占用高(6%)
### ✔ IO 完全不受磁盘物理限制
这些都说明:
👉 **写入主要落在操作系统缓存或 RAID 控制器缓存,没有真正落盘。**
---
# 🔍 **四、如何获得真实机械盘与SSD性能?**
请执行:
### **真实物理盘测试命令(禁止缓存)**
```
diskspd -c2G -d30 -r -w100 -b4k -o32 -t4 -Sh -Su -L e:\hdd_test.dat
```
再测固态:
```
diskspd -c2G -d30 -r -w100 -b4k -o32 -t4 -Sh -Su -L d:\ssd_test.dat
```
这样得到的才是真实 IOPS。
---
# 🧠 **五、总结(核心结论)**
### ✔ 你当前的机械盘 RAID1 数据并不真实 → 命中了系统/RAID 缓存
### ✔ 实际真实性能中:
- **SSD RAID1 完胜机械盘 RAID1(100~500倍)**
- HDD RAID1 性能通常只有 200 IOPS 左右
- SSD RAID1 可达到 50k~100k IOPS
---
# 📌 如果你愿意,我可以继续帮你:
### ✅ 解析 D 盘固态 RAID1 的完整测试结果
(你已贴了一部分,但没有贴 Total IO)
### ✅ 给你一份专业版 DiskSpd 测试脚本
自带所有缓存禁用参数、自动记录日志、自动生成性能对比表格。
---
要继续分析 D 盘,请把以下部分贴出来:
👉 **D 盘(SSD)测试的 Total IO 区块(total IOPS、MB/s 那部分)**
# 在 Windows Server 2022 下测试硬盘 IOPS
在 **Windows Server 2022** 下测试硬盘 **IOPS**,最专业、最常用的是用微软官方工具 **DiskSpd**。下面给你一份**直接可用的命令集合**,适合真实服务器场景。
---
## 一、推荐工具:DiskSpd(微软官方)
下载地址(官方):
- DiskSpd
(你可以从微软 GitHub 搜索 “DiskSpd” 下载)
解压后假设路径为:
```text
C:\diskspd\diskspd.exe
```
---
## 二、新建一个测试文件(非常重要)
先准备一个测试文件,比如 10GB:
```powershell
fsutil file createnew D:\iops_test.dat 10737418240
```
---
## 三、随机读 IOPS 测试命令(最常用)
### 1. 4K 随机读(典型数据库负载)
```powershell
Cd e:\soft\diskspd\
./diskspd.exe -b4K -r -o32 -t4 -d30 -Sh -L D:\iops_test.dat
```
参数说明:
| 参数 | 说明 |
|---|
| `-b4K` | 块大小 4KB |
| `-r` | 随机 IO |
| `-o32` | 队列深度 32 |
| `-t4` | 4 线程 |
| `-d30` | 测试 30 秒 |
| `-Sh` | 禁用系统缓存 |
| `-L` | 显示延迟统计 |
---
### 2. 4K 随机写 IOPS
```powershell
C:\diskspd\diskspd.exe ^
-b4K -r -w100 -o32 -t4 -d30 -Sh ^
-L D:\iops_test.dat
```
---
## 四、顺序读写吞吐测试
### 1. 顺序读(大文件)
```powershell
C:\diskspd\diskspd.exe ^
-b1M -s -o4 -t2 -d30 -Sh ^
-L D:\iops_test.dat
```
### 2. 顺序写
```powershell
C:\diskspd\diskspd.exe ^
-b1M -s -w100 -o4 -t2 -d30 -Sh ^
-L D:\iops_test.dat
```
---
## 五、如何看 IOPS 结果
主要看结果中的这一行:
```text
total IO
```
示例结果:
```text
total IO
IO/s: 85234
MB/s: 333.1
AvgLat: 0.45ms
```
其中:
- **IO/s → 就是 IOPS**
- **AvgLat → 平均延迟**
---
## 六、简单对照参考值
| 存储类型 | 大概 IOPS |
|---|
| SATA HDD | 100–200 |
| SATA SSD | 10,000–50,000 |
| NVMe SSD | 100,000–500,000+ |
| 云盘(普通) | 1,000–10,000 |
---
如果你是在 **Hyper-V 虚拟机** 里测试,我还能给你一套专门针对 VM 的压测参数。
这个报错原因非常明确,并且你这个环境很典型 👇
---
## 直接原因
核心报错是这一句:
```text
Error opening file: E:\iops_test.dat [2]
```
错误码 **\[2\] = 系统找不到指定的文件**。
也就是说:
👉 **DiskSpd 找不到 `E:\iops_test.dat` 这个测试文件**,所以直接中断。
---
## 为什么会这样
DiskSpd **不会自动创建测试文件**,它只会对**已存在的文件**做压力读写测试。
你现在只是执行了测试命令,但并没有在 `E:` 盘创建这个文件。
---
## 正确的做法(一步解决)
先在 `E:` 盘创建一个测试文件:
在 PowerShell 里运行:
```powershell
fsutil file createnew E:\iops_test.dat 10737418240
```
这会创建一个 **10GB 文件**。
确认文件存在:
```powershell
dir E:\iops_test.dat
```
---
## 再重新执行你的测试命令
```powershell
.\diskspd.exe -b4K -r -o32 -t4 -d30 -Sh -L E:\iops_test.dat
```
这次就会正常跑出 IOPS 结果。
---
## 额外提醒你几个容易踩的坑(结合你日志)
你环境是:
- Windows Server 2022
- 双路 CPU(2 sockets)
- 48 线程
这没问题 👍
但注意:
### 1. 不要在系统盘 C: 上压测
会严重影响系统响应。
### 2. 确保 E: 是独立数据盘
不要是 U 盘、光驱、映射盘之类。
---
## 总结一句话
你的错误不是 DiskSpd 的问题,而是:
✅ **测试文件不存在**
✅ 先用 `fsutil` 创建文件即可
---
如果这个 E: 盘是在 **Hyper-V 虚拟机里**,我还能给你一套专门针对虚拟盘的最优参数。
你这次测试 **完全成功,而且性能非常强**。我帮你把关键结果快速解读一下:
---
## ✅ 你的核心 IOPS 结果
这一行是我们最关心的:
```text
total: 328754.98 I/O per s
```
### 结论:
👉 **你的磁盘随机读 IOPS ≈ 328,755**
这已经是**企业级 NVMe 性能级别**,非常猛。
---
## ✅ 读性能详情
| 指标 | 数值 | 结论 |
|---|
| IOPS | **328,755** | 很高 |
| 吞吐 | 1284 MB/s | 正常 |
| 平均延迟 | **0.012 ms(12 微秒)** | 非常低 |
---
## ✅ 延迟质量
你盘的延迟分布也很优秀:
| 百分位 | 时延 |
|---|
| 99% | 0.020 ms |
| 99.999% | 0.908 ms |
| 极端最大 | 5.685 ms |
说明在大量随机读下,尾延迟控制优秀,很适合数据库。
---
## ✅ 简单评价你这块盘
根据你这个成绩:
| 类型预估 | 是否匹配 |
|---|
| SATA SSD | ❌ 明显超出 |
| 企业级 NVMe | ✅ 完全符合 |
| 高性能阵列 | ✅ |
**你的 E: 盘极可能是:**
- 企业级 NVMe SSD
- 或高性能 RAID10 / 存储阵列
---
## ✅ 你现在测的是:**4K 随机读**
命令解析:
```bash
-b4K -r -o32 -t4
```
属于数据库最真实负载模型。
---
## ✅ 如果你还想继续测
### 1. 4K 随机写 IOPS
```powershell
.\diskspd.exe -b4K -r -w100 -o32 -t4 -d30 -Sh -L E:\iops_test.dat
```
### 2. 混合读写(70%读,30%写)
```powershell
.\diskspd.exe -b4K -r -w30 -o32 -t4 -d30 -Sh -L E:\iops_test.dat
```
---
## 一句话总结
你的这块磁盘:
> ✅ 随机读 IOPS 超过 **32 万**
> ✅ 延迟基本是 **纳秒级别体验**
> ✅ 非常适合跑数据库、虚拟化、高并发场景
如果这是 Hyper-V 虚拟机里的盘,我还能帮你判断是不是被宿主机限速。
你这个现象**完全正常,而且非常典型**。我给你讲清楚“为什么 DiskSpd 只有 4K IOPS 很差,但实际拷大文件能跑 500MB/s”的根本原因。
---
## 一句话先给结论
你遇到的是\*\*经典的“顺序吞吐很快,但随机 I/O 极差”\*\*的情况,而且你的架构 **天生就会这样**:
> ✅ NVMe ×4 + RAID5 + 动态磁盘(Windows 软件 RAID)
> ❗ 顺序读写快
> ❗ 随机 4K IOPS 会非常差
> ❗ 写延迟巨大 —— 完全符合你现在的测试现象
---
## 为什么会出现这种巨大差距?
### 1. 你拷贝的是**顺序大文件**
Windows 复制大文件时:
- I/O 块通常是 **1MB~8MB 以上**
- 命中 **系统缓存**
- RAID5 只做 **顺序条带写入**
- NVMe 队列深度可以充分利用
所以你看到:
✅ 500MB/s 很合理(甚至偏保守)
---
### 2. DiskSpd 测的是 **4K 随机混合小块 I/O**
你的参数是:
```
-b4K // 4K 小块
-r // 随机
-w30 // 30% 写
-o32 // 深队列
```
这类 I/O 对 RAID5 来说是“地狱级负载”。
---
## RAID5 天生对 4K 随机写极其不友好
**RAID5 的致命弱点就是随机小写入。**
### 普通写入(顺序):
```
直接写数据条带 → 快
```
### 4K 随机写(RAID5 的真实过程):
一个 4K 写入,会变成:
```
1. 读原数据块
2. 读原校验块
3. 计算新校验
4. 写新数据
5. 写新校验
```
也就是:
> ✅ 你发起 1 次 4K 写
> ❌ 实际底层变成 4 次 I/O 操作
这叫 **RAID5 写惩罚(RAID5 Write Penalty)**。
---
## 再叠加一个“罪魁祸首”:
你用的是:
```
Windows 动态磁盘 RAID-5
```
这是**纯软件 RAID**:
- 全部校验计算走 CPU
- 不带 RAID Cache
- 不带写缓存保护(BBU / 超级电容)
结果就是:
✅ 顺序大文件 OK
❌ 随机小块 I/O 直接崩溃
---
## 你现在的表现完全符合这个组合的理论瓶颈
对比你实测:
| 项目 | 符合理论? |
|---|
| 顺序拷贝 500MB/s | ✅ 完全正常 |
| 4K 随机只有 4–5K IOPS | ✅ 完全预期 |
| 写延迟 60ms+ | ✅ RAID5 随机写典型表现 |
结论非常明确:
👉 **盘是好盘,阵列方式拖后腿。**
---
## 再说一个关键点:DiskSpd 测的是“真实硬盘 I/O”
你看到这一行:
```
hardware write cache disabled, writethrough on
```
说明:
- DiskSpd **强制绕过系统缓存**
- 禁用了写缓存
- 真实打到 RAID 逻辑
而你拷贝文件时:
✅ Windows 使用了大量缓存
✅ 写入被合并成顺序流量
✅ 体验看起来“很快”
---
## 如果你想看到真实 NVMe RAID5 性能,该怎么测?
你现在这个测试更像是“最坏情况压力测试”。
你可以用更贴近真实业务的参数再跑一次:
### 测“真实业务型负载”
```powershell
diskspd -b128K -r -w30 -o8 -t4 -d30 -Sh -L D:\test.dat
```
然后你会发现:
✅ 吞吐量会明显上升
✅ 延迟会低很多
---
## 说实话:你的阵列结构并不适合数据库/虚拟机
如果你的用途是:
| 场景 | RAID5 适合吗? |
|---|
| 大文件存储 | ✅ 非常适合 |
| 视频 / 备份 | ✅ 很适合 |
| 数据库 | ❌ 非常不适合 |
| 虚拟机 | ❌ 非常不适合 |
---
## 根本优化建议(核心)
如果你希望:
> “NVMe 真正跑出 NVMe 级 IOPS”
只有几个办法:
✅ 改 RAID10
✅ 或使用硬 RAID 卡(带缓存)
✅ 或用 Storage Spaces(带 ReFS + 缓存列)
---
## 最后一句很实在的话
你的 **500MB/s 不是假快**,但你的 **4K 随机性能是真差**,
而且这不是 NVMe 不行,是 RAID5 + 动态磁盘的架构限制。
---
如果你告诉我:
你这个 D 盘主要用来干什么?
我可以直接帮你设计一个**最适合业务的存储结构方案**。
# 把4 × 1.2T 10k SAS 做 RAID10 和 3 × 1.2T 10k SAS 做 RAID5 性能对比
很好 — 我把**4 × 1.2T 10k SAS 做 RAID10**(两对镜像再条带)和 **3 × 1.2T 10k SAS 做 RAID5** 在常见场景下的读写性能、延迟、空间利用、重建行为、适用性都算清楚并做对比。并给出结论与推荐。为便于理解,我用一个常见的物理盘性能假设作为基线并把计算过程写清楚——你可以把基线值替换成你实际盘的数字来重新套算。
---
## 假设(基线,便于定量比较)
- 每块 1.2T、10k RPM SAS 磁盘的**随机 4K IOPS** 我取:`150 IOPS/盘`(行业常见区间约 120–180,10k 常取 ~150)
- 每块盘**顺序带宽**我取:`150 MB/s/盘`(10k SAS 顺序读写常见为 120–180 MB/s,取 150 便于计算)
(若你有厂商给的确切 IOPS/带宽数值,我可以用那些数值重算并给精确结论。)
——下面所有算术我会显示计算步骤,数字逐位计算确保正确。
---
# 一、容量(可用空间)
- RAID10 (4盘): usable = (总盘数 / 2) × 单盘容量 = (4 / 2) × 1.2T = 2 × 1.2T = **2.4 TB**
- RAID5 (3盘): usable = (总盘数 − 1) × 单盘容量 = (3 − 1) × 1.2T = 2 × 1.2T = **2.4 TB**
=> **两者在此盘数下可用容量一致 = 2.4TB。**
---
# 二、随机 4K IOPS(小随机读/写,数据库/虚拟机最敏感)
### 1) RAID10(4 磁盘,做成两镜像对后条带)
- 每盘 150 IOPS。
- 读:理论上 RAID10 可以并行从所有镜像盘读取,最大读 IOPS ≈ 4 × 150 =
4 × 150 = 600 → **600 IOPS (read)**
- 写:每逻辑写需要写入镜像对的两块盘(写入必须到两块),但条带把写分散到两对镜像上,所以写并行度 = 镜像对数 = 4 / 2 = 2 对 → 写 IOPS ≈ 2 × 150 =
2 × 150 = 300 → **300 IOPS (write)**
### 2) RAID5(3 磁盘)
- 每盘 150 IOPS,总物理 IOPS = 3 × 150 =
3 × 150 = 450 → **450 物理 IOPS 可用**
- 读:读可以从数据盘并行读取(不读取 parity),读并行度 = n − 1 = 2 → 读 IOPS ≈ 2 × 150 =
2 × 150 = 300 → **300 IOPS (read)**
- 写(小随机写,最坏情形,采用读-修改-写):RAID5 写惩罚通常为 **4 个物理 I/O**(读旧数据 + 读旧 parity + 写新数据 + 写新 parity)。所以**逻辑写 IOPS ≈ 物理总 IOPS / 4** = 450 / 4 =
450 ÷ 4 = 112.5 → 取整 **≈112 IOPS (small random write)**
> 小结(随机 4K):
>
> - RAID10: **读 600 IOPS / 写 300 IOPS**
> - RAID5: **读 300 IOPS / 写 ≈112 IOPS**
**结论:RAID10 在随机读/写下显著优于 RAID5(尤其是随机写,约 2.7× 更快)。**
---
# 三、顺序吞吐(大文件顺序读/写)
假设每盘顺序带宽 150 MB/s。
### RAID10(4盘)
- 顺序读:可从四盘读取 → 4 × 150 =
4 × 150 = 600 → **600 MB/s (seq read)**
- 顺序写:写入镜像对并条带,条带数 = 2 → 2 × 150 =
2 × 150 = 300 → **300 MB/s (seq write)**
### RAID5(3盘)
- 顺序读:数据条带在 n−1 磁盘 → 2 × 150 =
2 × 150 = 300 → **300 MB/s (seq read)**
- 顺序写(full-stripe writes,能做到不读旧数据):也能写入到 n−1 磁盘 → 2 × 150 =
2 × 150 = 300 → **300 MB/s (seq write, full-stripe optimal)**
> 小结(顺序):
>
> - RAID10: **读 600 / 写 300 MB/s**
> - RAID5: **读 300 / 写 300 MB/s(在 full-stripe 场景)**
**结论:顺序读 RAID10 有明显优势;顺序写在 full-stripe 情况下两者相当。**
但注意:真实文件复制往往不是 perfect full-stripe 写,且文件系统与缓存行为会影响实际数值。
---
# 四、延迟与尾延迟
- RAID10:写延迟较小(镜像写入能并行),随机写延迟明显优于 RAID5。尾延迟较小,较稳定。
- RAID5:随机小写入有写惩罚,导致平均延迟与尾延迟显著上升;在高并发/随机写场景下会产生长尾(卡顿、响应慢)。
---
# 五、重建(Rebuild)与可靠性/风险
- RAID10(4盘):如果一块盘故障,只需重建该盘到其镜像对上;重建只需复制镜像对的数据 → **重建速度快,恢复期间性能影响较小,风险较低**。
- RAID5(3盘):故障后需要重建整个阵列(重建时需要读取剩余所有盘并计算校验),重建时间长且在重建期间阵列处于降级状态,若再有一块盘故障则数据丢失 → **更高风险**。
---
# 六、CPU/控制器开销与写开销
- RAID5 有 parity 计算(如果是软件 RAID,会消耗 CPU;如果是硬件 RAID,会用 RAID 卡),所以在写密集场景下 CPU/控制器开销更高。
- RAID10 CPU 开销极低(仅做镜像复制,不做校验计算)。
---
# 七、总结对比(表格)
| 项目 | 4×1.2T 10k RAID10 | 3×1.2T 10k RAID5 |
|---|
| 可用容量 | 2.4 TB | 2.4 TB |
| 随机 4K 读 (估) | **600 IOPS** | 300 IOPS |
| 随机 4K 写 (估) | **300 IOPS** | **~112 IOPS** |
| 顺序读 (估) | **600 MB/s** | 300 MB/s |
| 顺序写 (full-stripe) | 300 MB/s | 300 MB/s |
| 写惩罚(小写) | 低 (镜像) | 高 (4x) |
| 重建速度与风险 | 快,风险低 | 慢,风险高(双盘故障会丢数据) |
| CPU/Parity 负担 | 低 | 高(如果是软件 RAID) |
| 适合场景 | 随机写/数据库/虚拟机/低延迟需求 | 顺序读写/归档/成本敏感场景 |
---
# 八、建议(基于业务场景)
- 如果主要工作负载是 **数据库、虚拟机、随机小 IO、多并发写**(延迟敏感),**选择 RAID10**。它能提供更高的随机 IOPS、稳定性更好、重建影响更小。
- 如果主要工作负载是 **大文件存储、备份、顺序读写**,且你更看重磁盘利用率与成本(在盘数更多时 RAID5 更节省),可以考虑 **RAID5**,但需接受随机写性能较差与重建风险。
- 如果你使用的是 **软件 RAID5(Windows 动态磁盘 / mdadm)**,要特别注意 parity 计算对 CPU 的消耗与重建期间的性能抖动;对关键业务,不推荐软件 RAID5 架构(RAID10 更稳妥)。
---
# 九、举例说明(把表格数字代入实际)
用上面基线(150 IOPS/盘,150 MB/s/盘):
- 随机写:RAID10 ≈ **300 IOPS** vs RAID5 ≈ **112 IOPS** → RAID10 大约 **2.7×** 更快(小随机写场景)。
- 顺序读:RAID10 ≈ **600 MB/s** vs RAID5 ≈ **300 MB/s** → RAID10 恰好 **2×** 更快(顺序读取大量数据时)。
---
如果你愿意,我可以:
1. 用你实际的单盘 IOPS/带宽(或厂商型号)把上面的数字重算成精确值;
2. 给出在**特定并发 / block size / queue depth** 下的估算(比如 4K QD32 的估算);
3. 给出**软硬件配置建议**(如:若继续用 RAID5,建议使用带 BBU/写缓存的硬件 RAID 卡或使用 RAID6/RAID10 替代以降低风险)。
你想用厂商的单盘指标(IOPS/MB/s)重算,还是我用上面基线继续给 QD/BS 更细的估算?
# 真香,一款Windows系统监控绝配工具!
最近不少小伙伴后台咨询寻找windows系统下系统监控的开源工具。本文给大家安排一款小而精悍的系统监控工具---LiteMonitor。小到只有不到2M,但是功能却异常强大的开源监控工具,我愿意称之为Windows系统监控绝配工具! > 对应github地址:https://github.com/Diorser/LiteMonitor
>
>
一、LiteMonitor介绍
LiteMonitor是一款轻量、可定制的开源桌面硬件监控软件 ,它可以仪表盘形式展示实时监测 CPU、GPU、内存、磁盘、网络等系统性能。
[](https://bost.lesrec.cn/uploads/images/gallery/2025-12/t4iO9Neqfv0mkWy6-image-1.png)同时它还支持横/竖屏/任务栏显示、主题切换、多语言、透明度显示、三色报警等,界面简洁且高度可配置 。非常牛逼大气。[](https://bost.lesrec.cn/uploads/images/gallery/2025-12/Gka6EIIsgJcUjtdA-image-2.png)它的功能异常强大,功能点非常多,大家体验就可以感受到[](https://bost.lesrec.cn/uploads/images/gallery/2025-12/yzkGyluhSBYK4NZW-image-3.png)我们直接在github上下载最新版本安装即可,不到2M大小,开源应用,安全放心使用。[](https://bost.lesrec.cn/uploads/images/gallery/2025-12/scth3OAc1YjaMoKi-image-4.png)[](https://bost.lesrec.cn/uploads/images/gallery/2025-12/3F4SlmGod69uaplO-image-5.png)[](https://bost.lesrec.cn/uploads/images/gallery/2025-12/1Wg3XCHDYjXgUcus-image-6.png)[](https://bost.lesrec.cn/uploads/images/gallery/2025-12/5ZH7uE5yWTnaQe5A-image-7.png)[](https://bost.lesrec.cn/uploads/images/gallery/2025-12/sN5bNmAgJCAS4v5I-image-8.png)总体来说,这个工具小,轻量级别,非常适合windows部署,不占用系统资源。贴切个人日常监控需求,大家喜欢可以自行下载体验。绝对是windows系统监控最佳选择工具!
# Windows Server 2012 的 Hyper-V 虚拟机是否需要购买许可
结论明确:
**是的,创建并长期运行 Windows Server 2012 的 Hyper-V 虚拟机,原则上需要合法的 Windows Server 2012 许可证。**
是否“需要购买”,取决于你**如何使用、运行多久、宿主机许可证类型**。
下面按运维/合规视角给你一个**清晰、可落地的判断标准**。
---
## 一、核心结论速览
| 场景 | 是否需要购买许可 |
|---|
| 临时测试 / 评估(≤180 天) | ❌ 不需要 |
| 生产环境 / 长期运行 | ✅ 需要 |
| 宿主机是 Windows Server Standard | ✅(但可能已包含部分虚机授权) |
| 宿主机是 Windows Server Datacenter | ❌(虚机数量不受限) |
| KMS / MAK 已覆盖 | ❌ 额外购买 |
---
## 二、关键原则(必须知道)
### 1. Windows Server **不是免费操作系统**
无论是:
- 物理机
- Hyper-V 虚拟机
- VMware / KVM 虚拟机
**只要是长期使用的 Windows Server,都需要许可证。**
---
## 三、你关心的几个具体情况
### 情况 1:测试 / 验证用途(不超过 180 天)
- Windows Server 2012 支持 **Evaluation 评估版**
- 初始 180 天
- 可 `slmgr /rearm` 最多延长到 **540 天**
👉 **这种情况不需要购买许可证**
👉 合规、常见、推荐用于测试环境
---
### 情况 2:正式长期运行(生产环境)
只要满足以下任意一条:
- 对外提供服务
- 长期运行(>180 天)
- 承载真实业务数据
👉 **必须有有效 Windows Server 2012 许可证**
---
## 四、许可证是否“已经包含”的判断(非常关键)
### 情况 3:Hyper-V 宿主机是 Windows Server
#### 1️⃣ 宿主机是 **Windows Server 2012/2016/2019 Standard**
- 每套 Standard 许可证:
- 覆盖 **1 台物理机**
- **允许运行 2 个 Windows Server 虚拟机**
✔ 如果你只跑 **≤2 台 Server 2012 虚机**
👉 **不需要额外购买**
❌ 如果跑 **第 3 台虚机**
👉 **需要再买一套 Standard**
---
#### 2️⃣ 宿主机是 **Windows Server Datacenter**
- 覆盖:
- **无限数量 Windows Server 虚拟机**
- 虚机可以是:
- 2012 / 2016 / 2019 / 2022
👉 **不需要为每台虚机单独购买许可**
> 这也是 Datacenter 的核心价值
---
## 五、常见误区(务必避开)
### ❌ 误区 1
> Hyper-V 是免费的,所以虚拟机里的 Windows 也是免费的
**错误。**
Hyper-V 免费 ≠ Guest OS 免费。
---
### ❌ 误区 2
> 老版本 Server 2012 就不用管授权了
**错误。**
是否“老版本”与是否需要授权 **无关**。
---
### ❌ 误区 3
> 不激活也能跑,就算合规
**错误。**
不激活 ≠ 合法授权(审计风险极高)。
---
## 六、给你的实务建议(基于你运维背景)
结合你过往场景,我建议:
### 如果是:
- 实验 / 迁移测试 / 系统兼容验证
👉 **直接用 Server 2012 Evaluation**
### 如果是:
- 长期内网系统
- 项目历史包袱必须 2012
👉 **检查宿主机是 Standard 还是 Datacenter**
- Datacenter:直接用
- Standard:确认虚机数量是否超标
---
## 七、一句话总结
> **Windows Server 2012 作为 Hyper-V 虚拟机,测试可不买,长期运行必须有许可证;是否需要“额外购买”,取决于宿主机的授权类型(Standard vs Datacenter)。**
如果你愿意说明:
- Hyper-V 宿主机系统版本
- 虚拟机数量
- 是否生产用途
我可以直接帮你算出 **最省钱、最合规的授权方案**。
下面直接给你**结论 + 合规判断依据**,不绕弯子,按微软授权规则来讲。
---
## 一、你的具体场景复述
- **宿主机(Hyper-V Host)**
👉 Windows Server **2025 Standard**
- **虚拟机(Guest)**
👉 Windows Server **2012 Datacenter**
👉 数量:**1 台**
---
## 二、核心结论(非常明确)
> **❌ 不合规,仍然需要单独为该 Windows Server 2012 Datacenter 虚拟机提供合法许可证。**
**原因有两点:**
1. **Standard 版宿主机的虚拟化授权有限**
2. **Standard 许可证不能“免费覆盖”Datacenter 版 Guest OS**
---
## 三、为什么不行(关键授权规则)
### 1️⃣ Windows Server Standard 的虚拟化权利
无论是 2019 / 2022 / 2025:
- **每套 Standard 许可证 =**
- 覆盖 1 台物理主机(按核心数)
- **最多 2 个 Windows Server 虚拟机**
- **但前提是:虚拟机运行的是 Standard 版本**
👉 **虚拟机版本 ≤ 宿主机授权级别**
---
### 2️⃣ Datacenter 版 Guest 的特殊点(很多人踩坑)
**Datacenter ≠ Standard 的“升级版”**
授权上是**完全不同 SKU**:
- Standard 许可证
❌ **不能覆盖 Datacenter 版虚拟机**
- Datacenter 虚拟机
✅ **必须有 Datacenter 许可证来源**
即便:
- 你只跑 **1 台**
- 宿主机是 **2025 Standard**
- 虚拟机是 **2012(老版本)**
👉 **依然不行**
---
## 四、你现在有 3 种合规做法
### ✅ 方案一(最省钱,最推荐)
**把虚拟机系统改为:**
- Windows Server **2012 Standard**
✔ 这样:
- 宿主机 2025 Standard
- 1 台 2012 Standard 虚拟机
👉 **完全合规**
👉 **无需额外购买任何许可证**
---
### ✅ 方案二(保留 2012 Datacenter,但补授权)
如果 **必须是 2012 Datacenter**(例如依赖其特性):
- 你需要:
- **单独拥有一套 Windows Server Datacenter 许可证**
- 版本可以是 2012 / 2016 / 2019 / 2022 / 2025(降级权适用)
👉 **只要有 Datacenter 授权,就可以合法跑这台 VM**
---
### ✅ 方案三(从根本上解决)
**把宿主机升级为:**
- Windows Server **2025 Datacenter**
✔ 优点:
- 虚拟机数量不限
- 虚拟机版本不限(2012~2025 都行)
- 后续扩容最省事
---
## 五、几个常见误区澄清
### ❌ 误区 1
> 虚拟机才 1 台,应该没问题
**错误**
版本不匹配,数量再少也不合规。
---
### ❌ 误区 2
> Guest 比 Host 老,可以
**只对版本代际成立,不对 SKU 成立**
- ✔ 2025 → 2012(降级)
- ❌ Standard → Datacenter
---
### ❌ 误区 3
> 不激活也能跑
**不等于合规**
审计只看授权,不看你激不激活。
---
## 六、一句话总结(可直接给领导/审计用)
> **Windows Server 2025 Standard 宿主机,不能直接授权运行 Windows Server 2012 Datacenter 虚拟机;即便只有 1 台,也必须额外拥有 Datacenter 许可证,或将虚拟机系统改为 Standard 才合规。**
---
如果你愿意补充:
- 这台 2012 Datacenter **具体依赖了哪些功能**
- 未来是否还会新增虚拟机
我可以直接帮你判断:
👉 **是否真的“非 Datacenter 不可”,以及最省钱的合规方案**
# 2025域控服务器Dnscache 服务(DNS Client 服务)自动被禁用解决方法
在 Windows Server 2025(目前仍处于预览/开发阶段,但行为可参考 Windows Server 2022/2019)环境中,若你部署了 **3 台域控制器(1 主 + 2 辅助)**,并发现 **Dnscache 服务(DNS Client 服务)总是自动被禁用**,从而导致本地 DNS 解析失败,这通常不是正常行为。以下是可能的原因和解决方案:
---
### 🔍 一、确认事实:Dnscache 服务是否真的“被禁用”?
首先澄清几个关键点:
| 项目 | 说明 |
|---|
| **服务名称** | `Dnscache`(显示名为 “DNS Client”) |
| **作用** | 缓存本地 DNS 查询结果、解析主机名(如 `ping dc01`),**不负责权威 DNS 响应** |
| **域控上是否必须运行?** | **推荐启用**,尤其用于解析其他域控、SRV 记录、客户端快速查找等 |
| **默认启动类型** | **自动(Automatic)**,且应处于 **正在运行** 状态 |
> ⚠️ 注意:**DNS 服务器角色(DNS Server 服务) ≠ Dnscache 服务**
>
> - `DNS Server`(服务名:`DNS`):提供权威 DNS 解析(必须运行在域控上)
> - `Dnscache`(服务名:`Dnscache`):本地 DNS 客户端缓存(建议启用)
---
### 🧨 二、Dnscache 被禁用的常见原因
#### 1. **组策略(GPO)强制禁用**
这是最常见原因!管理员可能通过 GPO 统一配置了服务启动状态。
- **检查路径**: ```
计算机配置 → 策略 → Windows 设置 → 安全设置 → 系统服务 → DNS Client
```
- 如果此处设置为 **“已禁用”**,则所有域控都会被强制停用该服务。
- **解决方法**:
- 打开 **组策略管理(GPMC)**
- 检查应用到域控 OU 的 GPO(如 “Default Domain Controllers Policy”)
- 删除或修改对 `Dnscache` 的限制,设为 **“未配置”** 或 **“自动”**
> 💡 提示:运行 `gpresult /h report.html` 在域控上查看生效的 GPO。
---
#### 2. **安全加固脚本/基线配置误操作**
某些安全合规脚本(如 CIS Benchmark、内部安全基线)会错误地认为“域控不需要 DNS Client 服务”,从而禁用它。
- **排查方法**:
- 检查是否运行过自动化加固工具(如 Microsoft Security Compliance Toolkit、Ansible、PowerShell 脚本)
- 查看事件日志:`Event Viewer → Windows Logs → System`,筛选 **Service Control Manager (Event ID 7040)**,看谁修改了启动类型
---
#### 3. **第三方安全软件干扰**
某些 EDR/XDR 或终端防护软件(如 CrowdStrike、McAfee、Symantec)可能出于“减少攻击面”目的,自动禁用非核心服务。
- **排查**:
- 暂时禁用第三方安全软件,观察服务是否恢复
- 检查其策略中是否包含“服务控制”规则
---
#### 4. **手动误操作 + 启动类型被设为“禁用”**
虽然你说“自动禁用”,但也可能是某次手动设置后未注意,而系统重启后体现为“失效”。
- **验证命令**: ```powershell
Get-Service Dnscache | Select Name, Status, StartType
sc.exe qc Dnscache
```
---
### ✅ 三、正确配置建议
#### ✅ 步骤 1:确保 Dnscache 服务启用并运行
```powershell
# 设置启动类型为自动
Set-Service Dnscache -StartupType Automatic
# 启动服务(如果未运行)
Start-Service Dnscache
```
#### ✅ 步骤 2:检查 DNS 服务器配置
- 所有域控的 **网络适配器 DNS 设置** 应指向 **自身或其他域控 IP**,**不要指向 127.0.0.1(除非单 DC)**
- 例如:
- DC01: DNS = DC02, DC03
- DC02: DNS = DC01, DC03
- DC03: DNS = DC01, DC02 > 避免环回依赖,防止复制中断
#### ✅ 步骤 3:验证 DNS 功能
```powershell
nslookup yourdomain.local
dcdiag /test:dns /v
```
---
### 🛑 四、特别注意:不要混淆概念!
| 错误认知 | 正确认知 |
|---|
| “域控自己是 DNS 服务器,不需要 Dnscache” | ❌ Dnscache 用于**解析其他主机名**(如 `ping dc02`)、缓存外部查询、加速 LDAP/SRV 查找 |
| “禁用 Dnscache 更安全” | ❌ 微软官方推荐启用,禁用可能导致:
• 组策略应用延迟
• 域信任解析失败
• 客户端登录变慢 |
---
### 📌 总结
> **Dnscache 服务在域控制器上应保持“自动”并“正在运行”**。
> 若它反复被禁用,**90% 概率是组策略(GPO)所致**,请优先排查 `Default Domain Controllers Policy` 或自定义 GPO 中的服务配置。
建议操作顺序:
1. 运行 `rsop.msc` 或 `gpresult /h gpo.html` 查看生效策略
2. 检查系统事件日志(Event ID 7040)
3. 临时将启动类型设为自动并监控是否被覆盖
4. 如确认是 GPO,修正后执行 `gpupdate /force` 并重启测试
如需进一步分析,可提供:
- `sc qc Dnscache` 输出
- `gpresult /h` 报告片段
- 系统日志中关于 Dnscache 的事件记录
---
感谢提供 `sc qc Dnscache` 的输出。从结果来看,问题非常明确:
```
START_TYPE : 4 DISABLED
```
这表示 **DNS Client(Dnscache)服务的启动类型已被设置为“禁用”**,因此系统不会自动启动它,导致本地 DNS 解析(如解析 `dc01`、`_ldap._tcp.dc._msdcs.yourdomain.com` 等)失败,进而可能影响域功能(如组策略应用、信任关系、客户端登录等)。
---
### 🔍 根本原因分析
虽然你没有手动禁用它,但 **Windows 默认绝不会将 Dnscache 设为 DISABLED**。
所以一定是 **某种外部策略或配置强制修改了它**。
最可能的原因排序如下:
| 可能性 | 原因 | 验证方式 |
|---|
| ⭐⭐⭐⭐ | **组策略(GPO)** 强制禁用服务 | 检查 `Default Domain Controllers Policy` 或其他应用到 DC 的 GPO |
| ⭐⭐⭐ | 安全基线脚本(如 CIS、Microsoft SCAP、内部加固脚本) | 检查是否运行过自动化安全配置工具 |
| ⭐⭐ | 第三方安全软件(EDR/AV)干预 | 查看安全软件是否有“服务控制”策略 |
| ⭐ | 手动误操作(但你说“总是自动”,可排除) | — |
---
### ✅ 解决方案:分步排查与修复
#### ✅ 第一步:立即临时启用服务(验证是否解决问题)
```cmd
sc config Dnscache start= auto
net start Dnscache
```
> 注意:`start= auto` 中的空格是语法要求。
然后测试 DNS 解析:
```cmd
nslookup yourdomain.local
ping dc02 (假设 dc02 是另一台 DC 的主机名)
```
如果恢复正常,说明确实是 Dnscache 被禁用导致的问题。
---
#### ✅ 第二步:查找是谁禁用了它 —— 检查组策略(最关键!)
1. **在域控上运行**:
```cmd
gpresult /h gpo_report.html
```
打开生成的 `gpo_report.html`,查看 **“计算机配置” → “已应用的组策略对象”**。
2. **重点检查以下 GPO**:
- `Default Domain Controllers Policy`
- 任何名称含 “Security Baseline”、“Hardening”、“Server Policy” 的自定义 GPO
3. **在 GPMC(组策略管理控制台)中检查**:
- 路径:
`计算机配置 → 策略 → Windows 设置 → 安全设置 → 系统服务`
- 找到 **“DNS Client”** 服务
- 如果其策略被设置为 **“已禁用”**,这就是罪魁祸首!
4. **修复方法**:
- 将该策略改为 **“未配置”**(推荐),或显式设为 **“自动”**
- 在域控上执行: ```cmd
gpupdate /force
```
- 重启或等待策略刷新(通常 90~120 分钟),观察 `Dnscache` 是否仍被禁用
---
#### ✅ 第三步:检查是否有安全基线脚本残留
- 回忆是否部署过:
- Microsoft Security Compliance Toolkit (SCT)
- CIS Microsoft Windows Server Benchmark
- PowerShell DSC 配置
- Ansible/Puppet 自动化脚本
- 这些工具常通过 **Local Group Policy** 或 **直接修改注册表** 禁用服务。
- **注册表位置**(不建议直接改,优先查 GPO):
```
HKEY_LOCAL_MACHINE\SYSTEM\CurrentControlSet\Services\Dnscache
Start = 4 (表示禁用)
```
> ⚠️ 如果是注册表被写死,即使 GPO 修复,也可能被脚本再次覆盖。需找到源头脚本并停用。
---
#### ✅ 第四步:监控服务是否再次被禁用
修复后,持续监控:
```powershell
# 每5分钟检查一次状态(可写成脚本)
while ($true) {
$svc = Get-Service Dnscache -ErrorAction SilentlyContinue
if ($svc.StartType -ne 'Automatic' -or $svc.Status -ne 'Running') {
Write-Host "$(Get-Date): Dnscache 异常! StartType=$($svc.StartType), Status=$($svc.Status)" -ForegroundColor Red
}
Start-Sleep -Seconds 300
}
```
同时查看 **事件查看器 → Windows 日志 → 系统**,筛选 **事件来源 = "Service Control Manager"**,事件 ID **7040**(服务启动类型更改)或 **7036**(服务停止),看是否有记录谁修改了它。
---
### 📌 最终建议
> **不要长期禁用 Dnscache 服务**,尤其在域控制器上。
> 微软官方文档明确指出:**域控制器应启用 DNS Client 服务以支持高效名称解析和 Active Directory 功能**。
参考:[Microsoft Docs - DNS Client service on domain controllers](https://learn.microsoft.com/en-us/troubleshoot/windows-server/networking/dns-client-service-domain-controllers)
---
### 总结操作清单
| 步骤 | 操作 |
|---|
| 1 | `sc config Dnscache start= auto && net start Dnscache`(临时恢复) |
| 2 | `gpresult /h gpo.html` + 检查 GPMC 中系统服务策略 |
| 3 | 修正 GPO,将 DNS Client 设为“未配置”或“自动” |
| 4 | `gpupdate /force` 并验证服务状态 |
| 5 | 监控日志,确认是否再次被禁用 |
如按上述操作仍无法解决,请提供:
- `gpresult /h` 报告中“已应用的 GPO”列表
- 系统日志中最近关于 Dnscache 的事件(ID 7040/7036)
我会帮你进一步分析!
# SQL Server 2014 SP3 创建一个受限用户账号
在 **SQL Server 2014 SP3** 中,你可以通过以下步骤创建一个受限用户账号,使其:
✅ **只能访问指定数据库(如 `SZHW`)**
✅ **只能对特定表(如 `SZCIS`)进行 SELECT / INSERT / UPDATE**
❌ **不能 DELETE 数据**
❌ **不能修改表结构、不能访问其他表**
---
## ✅ 实现步骤(使用 SSMS 或 T-SQL)
### 🔹 步骤 1:创建登录名(Login)
```sql
-- 创建 SQL Server 登录名(服务器级别)
CREATE LOGIN [limited_user] WITH PASSWORD = 'StrongPassword123!';
```
> 💡 建议密码符合复杂性要求。
---
### 🔹 步骤 2:在目标数据库中创建用户(User)
```sql
USE [SZHW]; -- 切换到你的数据库
-- 将登录名映射为数据库用户
CREATE USER [limited_user] FOR LOGIN [limited_user];
```
---
### 🔹 步骤 3:授予 **SELECT, INSERT, UPDATE** 权限(仅限指定表)
```sql
-- 授予对 SZCIS 表的读写权限(不含 DELETE)
GRANT SELECT, INSERT, UPDATE ON OBJECT::dbo.SZCIS TO [limited_user];
```
> ⚠️ 注意:`OBJECT::dbo.SZCIS` 是完整对象引用格式。
---
### 🔹 步骤 4:**显式拒绝 DELETE 权限**(防止意外继承)
```sql
-- 明确禁止删除操作
DENY DELETE ON OBJECT::dbo.SZCIS TO [limited_user];
```
> ✅ `DENY` 优先级高于 `GRANT`,即使以后加入角色也不会有 DELETE 权限。
---
### 🔹 步骤 5:(可选)限制不能访问其他表
默认情况下,新用户 **没有任何权限**,所以只要不授予权限,就无法访问其他表。
但为了更安全,可以:
#### 方法 A:不将用户加入任何角色(推荐)
- 不要加入 `db_datareader`、`db_datawriter` 等内置角色
- 只按需授权特定表
#### 方法 B:显式拒绝所有其他表(不必要,但更严格)
```sql
-- 拒绝访问其他表(示例)
DENY SELECT, INSERT, UPDATE, DELETE ON OBJECT::dbo.OtherTable TO [limited_user];
```
---
### 🔹 步骤 6:测试权限
#### 用新账号连接后执行:
✅ 允许的操作:
```sql
SELECT * FROM dbo.SZCIS;
INSERT INTO dbo.SZCIS (Part_Number, Description) VALUES ('TEST001', 'Test Part');
UPDATE dbo.SZCIS SET Description = 'Updated' WHERE Part_Number = 'TEST001';
```
❌ 被拒绝的操作:
```sql
DELETE FROM dbo.SZCIS WHERE Part_Number = 'TEST001'; -- 报错:权限被拒绝
SELECT * FROM dbo.OtherTable; -- 报错:对象无权限
```
---
## 🛡️ 安全最佳实践
| 建议 | 说明 |
|---|
| **不要使用 sa 账号做应用连接** | 应使用最小权限账号 |
| **密码定期更换** | 使用强密码策略 |
| **限制 IP 访问(网络层)** | 在防火墙或 SQL Server 配置中限制来源 IP |
| **启用登录审计** | 监控异常登录行为 |
---
## 🧩 扩展:如果需要多个表?
只需重复 `GRANT` 和 `DENY`:
```sql
-- 授权多张表
GRANT SELECT, INSERT, UPDATE ON OBJECT::dbo.Table1 TO [limited_user];
GRANT SELECT, INSERT, UPDATE ON OBJECT::dbo.Table2 TO [limited_user];
-- 拒绝删除
DENY DELETE ON OBJECT::dbo.Table1 TO [limited_user];
DENY DELETE ON OBJECT::dbo.Table2 TO [limited_user];
```
---
## 📌 总结命令(一键复制)
```sql
-- 1. 创建登录名
CREATE LOGIN [limited_user] WITH PASSWORD = 'YourSecurePassword!';
-- 2. 在数据库中创建用户
USE [SZHW];
CREATE USER [limited_user] FOR LOGIN [limited_user];
-- 3. 授予指定表的读写权限(不含删除)
GRANT SELECT, INSERT, UPDATE ON OBJECT::dbo.SZCIS TO [limited_user];
-- 4. 显式拒绝删除权限
DENY DELETE ON OBJECT::dbo.SZCIS TO [limited_user];
```
> ✅ 完成!该账号现在只能对 `SZCIS` 表进行增、改、查,不能删,也不能访问其他表。
---
## ❓常见问题
**Q:能否只允许修改某些字段?**
A:SQL Server 不支持列级 UPDATE 权限(除 `VIEW` 外)。
✅ 替代方案:创建一个 **视图(View)**,只包含可编辑字段,并在视图上授权。
**Q:用户能执行存储过程吗?**
A:默认不能。如需调用,需单独授权:
```sql
GRANT EXECUTE ON dbo.YourProc TO [limited_user];
```
---
如有需要,我也可以帮你生成 **只读账号** 或 **基于视图的受限账号**。欢迎继续提问!
# SQL Server 2014 SP3 中为用户设置严格权限
要在 **SQL Server 2014 SP3** 中为用户 `sqluser` 设置严格权限,使其:
✅ **只能访问 `SZHW` 数据库中的 `SZCIS` 表**
✅ **可以执行:SELECT(列出)、INSERT(添加)、UPDATE(编辑)**
❌ **不能 DELETE(删除数据)**
❌ **不能 ALTER(修改表结构)**
❌ **不能访问其他任何表或对象**
---
## ✅ 完整操作步骤(使用 T-SQL)
### 🔹 步骤 1:确保用户已存在(登录名 + 数据库用户)
```sql
-- 如果还没有登录名,先创建(在 master 数据库中)
USE master;
CREATE LOGIN [sqluser] WITH PASSWORD = 'YourStrongPassword123!';
-- 切换到目标数据库
USE [SZHW];
-- 创建数据库用户(映射登录名)
CREATE USER [sqluser] FOR LOGIN [sqluser];
```
> ⚠️ 如果用户已存在,跳过此步。
---
### 🔹 步骤 2:**显式拒绝所有高危权限(安全兜底)**
```sql
-- 拒绝对整个 dbo 架构的 ALTER 权限(防止改表结构)
DENY ALTER ON SCHEMA::dbo TO [sqluser];
-- 拒绝对整个 dbo 架构的 CONTROL 权限(防止获得完全控制)
DENY CONTROL ON SCHEMA::dbo TO [sqluser];
-- 拒绝对整个 dbo 架构的 DELETE 权限(防止删数据)
DENY DELETE ON SCHEMA::dbo TO [sqluser];
```
> ✅ 这些 `DENY` 是**全局性限制**,优先级高于后续的 `GRANT`。
---
### 🔹 步骤 3:**仅授予对 `SZCIS` 表的必要权限**
```sql
-- 只允许对 SZCIS 表进行 SELECT, INSERT, UPDATE
GRANT SELECT, INSERT, UPDATE ON OBJECT::dbo.SZCIS TO [sqluser];
```
> 💡 注意:这里**只授权给特定表**,而不是整个架构。
---
### 🔹 步骤 4:(可选)验证权限
#### 测试允许的操作(用 `sqluser` 账号连接后执行):
```sql
-- ✅ 应成功
SELECT * FROM dbo.SZCIS;
INSERT INTO dbo.SZCIS (Part_Number, Description) VALUES ('TEST001', 'Test');
UPDATE dbo.SZCIS SET Description = 'Updated' WHERE Part_Number = 'TEST001';
```
#### 测试禁止的操作:
```sql
-- ❌ 应失败:权限被拒绝
DELETE FROM dbo.SZCIS WHERE Part_Number = 'TEST001';
-- ❌ 应失败:无法修改表结构
ALTER TABLE dbo.SZCIS ADD NewColumn NVARCHAR(50);
-- ❌ 应失败:无法访问其他表
SELECT * FROM dbo.OtherTable; -- 假设存在其他表
```
---
## 🔒 权限设计原理说明
| 操作 | 如何实现限制 |
|---|
| **不能删数据** | `DENY DELETE ON SCHEMA::dbo` |
| **不能改表结构** | `DENY ALTER ON SCHEMA::dbo` |
| **不能访问其他表** | **不授予任何其他表的权限**(默认无权限) |
| **只能操作 SZCIS** | `GRANT ... ON OBJECT::dbo.SZCIS`(精确到表) |
> ✅ SQL Server 默认遵循 **“最小权限原则”**:未显式授予权限 = 无权限。
---
## 🛡️ 额外安全建议
### 1. **不要将用户加入任何角色**
- ❌ 不要加入 `db_datareader`、`db_datawriter` 等内置角色
- 这些角色会自动授予整个数据库的读写权限,违背你的需求
### 2. **定期审计权限**
```sql
-- 查看用户权限
SELECT
p.permission_name,
p.state_desc,
o.name AS object_name
FROM sys.database_permissions p
LEFT JOIN sys.objects o ON p.major_id = o.object_id
WHERE grantee_principal_id = USER_ID('sqluser');
```
### 3. **使用专用账号**
- 为不同应用/用户创建独立账号,避免共用 `sa` 或通用账号
---
## 📌 最终完整脚本(一键复制)
```sql
-- 1. 创建登录名(如不存在)
USE master;
IF NOT EXISTS (SELECT * FROM sys.server_principals WHERE name = 'sqluser')
CREATE LOGIN [sqluser] WITH PASSWORD = 'YourStrongPassword123!';
-- 2. 在 SZHW 数据库中创建用户
USE [SZHW];
CREATE USER [sqluser] FOR LOGIN [sqluser];
-- 3. 拒绝高危权限(全局限制)
DENY ALTER ON SCHEMA::dbo TO [sqluser];
DENY CONTROL ON SCHEMA::dbo TO [sqluser];
DENY DELETE ON SCHEMA::dbo TO [sqluser];
-- 4. 仅授权 SZCIS 表的必要操作
GRANT SELECT, INSERT, UPDATE ON OBJECT::dbo.SZCIS TO [sqluser];
```
> ✅ 执行后,`sqluser` 将严格受限于你的要求。
---
## ❓常见问题
**Q:能否限制只能修改某些字段?**
A:SQL Server 不支持列级 UPDATE 权限。
✅ 替代方案:创建一个 **视图(View)**,只包含可编辑字段,并在视图上授权。
**Q:用户能执行存储过程吗?**
A:默认不能。如需调用,需单独授权:
```sql
GRANT EXECUTE ON dbo.YourProc TO [sqluser];
```
---
完成以上配置后,你的 `sqluser` 账号将安全地满足业务需求!如有其他场景,欢迎继续提问。
# 解决磁盘 0 显示为“只读”状态
你遇到的问题是:**磁盘 0 显示为“只读”状态**,无法正常写入或使用。从你的截图来看,磁盘 0 是一个 **61473.48 GB 的基本磁盘**,在“磁盘管理”中显示为“只读”,而在 `diskpart` 中执行 `online disk` 命令后提示成功联机。
---
### ✅ 问题分析
磁盘显示为“只读”的常见原因包括:
1. **物理连接问题(如 SATA 线松动、电源不足)**
2. **磁盘硬件故障或坏道**
3. **系统或驱动程序限制(例如 BitLocker 加密、RAID 控制器策略)**
4. **磁盘被设置为“脱机”或“只读”模式(可通过 DiskPart 修改)**
5. **操作系统权限或安全策略限制**
但从你的操作看:
- 已经运行了 `diskpart`
- 执行了 `select disk 0`
- 执行了 `online disk` → 成功提示
- 但磁盘仍显示“只读”
说明磁盘已经在线,但可能由于某种原因仍处于只读状态。
---
### ✅ 解决方案步骤
#### 🔧 方法一:检查并修复磁盘状态(推荐)
1. **打开管理员命令提示符或 PowerShell(以管理员身份运行)**
2. 进入 `diskpart`
```powershell
diskpart
```
3. 列出所有磁盘
```cmd
list disk
```
4. 选择磁盘 0
```cmd
select disk 0
```
5. 检查磁盘是否已联机
```cmd
attributes disk
```
> 如果输出中有 `READONLY` 被标记为 `ON`,则表示磁盘被设为只读。
6. **关闭只读属性**
```cmd
attributes disk clear readonly
```
7. 再次查看属性确认
```cmd
attributes disk
```
8. 退出 diskpart
```cmd
exit
```
9. 回到“磁盘管理”刷新,查看磁盘是否变为可读写状态。
---
#### 🔧 方法二:检查磁盘是否损坏或有坏道
如果上述操作无效,可能是磁盘本身有问题。
1. 打开命令提示符(管理员)
2. 运行:
```cmd
chkdsk F: /f /r
```
> 替换 `F:` 为你磁盘上某个分区的盘符(比如冷备 F:)
这将扫描并尝试修复文件系统错误。
---
#### 🔧 方法三:检查 BIOS/RAID 设置(适用于服务器环境)
如果你是在 **服务器或 RAID 阵列环境**(如 HPE、Dell、华为等),请检查:
- **RAID 控制器管理界面**(如 MegaRAID、iDRAC、iLO)
- 是否该磁盘被标记为“只读”或“热备”
- 是否存在阵列配置冲突(如某块盘是热备盘,不能直接读写)
> 特别注意:你截图中看到“冷备 (F)”、“热备 (E)”,说明这是一个 **RAID 环境**,磁盘 0 可能是主盘或热备盘。
⚠️ 注意:**热备盘通常不建议手动修改,除非明确知道用途。**
---
#### 🔧 方法四:检查是否为 BitLocker 加密导致只读
1. 打开“控制面板” → “BitLocker 驱动器加密”
2. 查看磁盘是否启用 BitLocker
3. 如果启用,尝试解锁或解密
---
#### 🔧 方法五:重启系统 + 检查硬件连接
- 断电后重新插拔 SATA 数据线和电源线
- 尝试更换 SATA 接口
- 检查是否有异常报警灯(如硬盘指示灯闪烁)
---
### ✅ 总结
| 步骤 | 操作 |
|---|
| 1 | 使用 `diskpart` 进入命令行 |
| 2 | 执行 `select disk 0` |
| 3 | 执行 `attributes disk clear readonly` |
| 4 | 检查是否成功清除只读标志 |
| 5 | 在磁盘管理中刷新查看状态 |
| 6 | 若无效,运行 `chkdsk` 检查文件系统 |
| 7 | 检查 RAID 配置或 BIOS 设置 |
---
### 🛠️ 补充建议
- 如果你是 IT 管理员,请确保备份重要数据后再操作。
- 若磁盘频繁出现只读,建议做健康检测(如 CrystalDiskInfo、SMART 工具)。
- 若磁盘为阵列成员,请勿随意修改其属性,以免影响整个阵列。
---
如你能提供更多信息(如是否为服务器?是否使用 RAID 卡?磁盘品牌型号?),我可以进一步精准指导。
# 禁止系统自动创建 C$、D$ 等磁盘默认共享
在 Windows Server 2019 中,要禁止系统自动创建 `C$`、`D$` 等**磁盘默认共享**,同时保留 `IPC$`(用于进程间通信和域认证)和 `ADMIN$`(用于远程管理),最标准且有效的方法是修改注册表。
Windows 原生机制将“磁盘默认共享”和“管理共享(ADMIN$/IPC$)”视为两类不同的自动共享。通过修改注册表中的 `AutoShareServer` 键值,可以仅禁用磁盘共享而不影响管理共享。
### 方法一:修改注册表(推荐,永久生效)
这是微软官方支持的方法,专门用于服务器版本。
1. **打开注册表编辑器**:
- 按 `Win + R`,输入 `regedit`,回车。
2. **定位到以下路径**:
```text
HKEY_LOCAL_MACHINE\SYSTEM\CurrentControlSet\Services\LanmanServer\Parameters
```
3. **新建或修改 DWORD 值**:
- 在右侧窗口查找名为 `AutoShareServer` 的项。
- **如果存在**:双击它,将数值数据改为 `0`。
- **如果不存在**:右键点击空白处 -> **新建** -> **DWORD (32-位) 值**,命名为 `AutoShareServer`,然后双击将其数值数据设置为 `0`。
- *注意:确保基数选择为“十六进制”或“十进制”均可,0 就是 0。*
4. **重启服务或服务器**:
- **方式 A(重启服务器)**:最稳妥,重启后生效。
- **方式 B(重启 Server 服务)**:无需重启服务器,立即生效。
- 以管理员身份打开 PowerShell 或 CMD,运行:
```powershell
Restart-Service LanmanServer -Force
```
- 或者在“服务”管理器 (`services.msc`) 中找到 **Server** 服务,右键选择“重新启动”。
5. **验证结果**:
- 打开 CMD,输入 `net share`。
- 你应该能看到 `IPC$` 和 `ADMIN$` 依然存在,但 `C$`、`D$` 等磁盘共享已经消失。
---
### 方法二:使用 PowerShell 一键执行
如果你希望快速完成操作,可以直接以**管理员身份**运行以下 PowerShell 脚本:
```powershell
# 设置注册表键值:禁用磁盘默认共享 (C$, D$ 等)
Set-ItemProperty -Path "HKLM:\SYSTEM\CurrentControlSet\Services\LanmanServer\Parameters" -Name "AutoShareServer" -Value 0 -Type DWord
# 重启 Server 服务使配置立即生效
Restart-Service -Name "LanmanServer" -Force
# 验证共享列表
Write-Host "当前共享列表:" -ForegroundColor Green
net share
```
---
### 重要说明与注意事项
1. **关于 `ADMIN$` 和 `IPC$` 的保留**:
- `AutoShareServer = 0` **只会**阻止系统自动挂载磁盘根目录(如 C$, D$)。
- `ADMIN$` (指向 `C:\Windows`) 和 `IPC$` 是由 `LanmanServer` 服务的核心逻辑控制的,通常不受 `AutoShareServer` 影响,会默认保留,以确保域加入、组策略应用和远程管理工具(如 MMC、PsExec)正常工作。
2. **如果是客户端系统(如 Win 10/11)**:
- 上述 `AutoShareServer` 键值在 Windows 客户端版本(非 Server 版)中通常**无效**。客户端系统使用的是 `AutoShareWks` 键值。但你当前使用的是 **Server 2019**,所以必须使用 `AutoShareServer`。
3. **临时手动删除(不推荐作为长期方案)**:
- 你可以运行 `net share C$ /delete` 来手动删除,但重启服务器或重启 Server 服务后,系统会根据注册表设置重新创建。因此,修改注册表是根本解决办法。
4. **安全性提示**:
- 隐藏默认共享是安全加固的常见步骤(符合等保或 CIS 基准),可以减少攻击面。
- 保留 `ADMIN$` 意味着管理员仍可通过网络访问系统目录,请确保你的管理员密码足够强壮,并限制了防火墙对 445 端口的访问来源。
# SQL Server 2022 的“高级”服务器属性页面
你提供的截图是 **SQL Server 2022 的“高级”服务器属性页面**,其中包含多个关键配置项。结合你之前提到的硬件环境(**24核 CPU + 100GB 内存**)和业务场景(**金蝶云星空 V9.1 演示版/生产环境**),以下是针对该页面的**逐项优化建议**:
---
## ✅ 一、核心优化项(必须调整)
### 1. 🚫 FILESTREAM 访问级别 → 已禁用
- **当前状态**:已禁用
- **建议**:✅ **保持禁用**
- 除非你的金蝶系统明确使用了 FILESTREAM 存储大文件(如附件、图片等),否则无需启用。
- 启用会增加复杂性和潜在性能开销。
> 💡 金蝶云星空默认不使用 FILESTREAM,所以“已禁用”是正确的。
---
### 2. ⚙️ 并行相关设置(重点优化!)
#### ▶ 并行的开销阈值 = `5`
- **问题**:太小!会导致大量简单查询也启用并行计划,浪费 CPU 资源。
- **建议改为**:`50`> 只有执行成本 > 50 的查询才考虑并行,避免小查询“杀鸡用牛刀”。
#### ▶ 查询等待值 = `-1`
- **含义**:无限等待并行线程资源。
- **建议改为**:`30` 或 `60`(秒) > 防止某个查询因等待并行资源而阻塞太久,影响其他用户。
#### ▶ 锁 = `0`
- **含义**:不限制并行查询持有的锁数量。
- **建议保持 `0`**(无限制),除非遇到严重锁争用问题。
#### ▶ 最大并行度 = `4`
- **问题**:对于 24 核服务器来说太低了!
- **建议改为**:`8`> 允许单个查询最多使用 8 个 CPU 核心,平衡性能与并发能力。 (如果后续发现某些报表特别慢,可临时调到 12~16,但一般不超过 8)
> 🔁 修改后需点击“确定”生效,或通过 T-SQL:
```sql
EXEC sp_configure 'max degree of parallelism', 8;
EXEC sp_configure 'cost threshold for parallelism', 50;
RECONFIGURE;
```
---
### 3. 🌐 网络数据包大小 = `4096`
- **当前值**:4096 字节(默认)
- **建议**:✅ **保持 4096**
- 对于局域网内金蝶应用服务器连接 SQL Server,这个值足够。
- 如果是跨广域网或高延迟网络,可尝试设为 `8192`,但通常没必要。
---
### 4. 🕒 远程登录超时值 = `10`
- **含义**:远程连接尝试超时时间(秒)
- **建议**:✅ **保持 10**
- 合理值,过长会影响故障排查效率。
---
### 5. 📅 两位数年份截止 = `2049`
- **含义**:两位年份(如 “25”)被解释为 2025 还是 1925?
- **建议**:✅ **保持 2049**
- 符合现代标准,2000–2049 年间的日期都能正确解析。
---
### 6. 🌍 默认全文语言 = `Simplified Chinese`
- **建议**:✅ **保持不动**
- 金蝶系统主要处理中文数据,此设置合理。
---
### 7. 🔄 启动时扫描存储过程 = `False`
- **含义**:启动时不预编译所有存储过程。
- **建议**:✅ **保持 False**
- 加快启动速度,按需编译更灵活。
---
### 8. 🆙 全文升级选项 = `重新生成`
- **含义**:升级全文索引时的行为。
- **建议**:✅ **保持“重新生成”**
- 确保全文索引结构最新,避免兼容性问题。
---
### 9. 🧵 使用 Windows 纤程(轻型池)= `False`
- **含义**:是否启用轻量级线程调度。
- **建议**:✅ **保持 False**
- 在高并发 OLTP 场景中可能有益,但金蝶 ERP 属于混合负载,且 SQL Server 2022 默认不开启,稳定性优先。
---
### 10. 🏆 提升 SQL Server 优先级 = `False`
- **含义**:是否让 SQL Server 进程获得更高 CPU 优先级。
- **建议**:✅ **保持 False**
- 除非你是独占数据库服务器,否则不要抢占操作系统或其他服务资源。
---
### 11. 🎯 游标阈值 = `-1`
- **含义**:游标操作的成本阈值。
- **建议**:✅ **保持 -1(无限制)**
- 一般不需要干预。
---
### 12. ⚡ 允许触发器激发其他触发器 = `True`
- **建议**:✅ **保持 True**
- 金蝶系统内部逻辑可能依赖嵌套触发器,关闭可能导致功能异常。
---
### 13. 📉 针对即席工作负荷进行优化 = `False`
- **含义**:是否为临时/ad-hoc 查询优化内存分配。
- **建议**:✅ **保持 False**
- 金蝶系统是标准化 ERP,查询模式相对固定,无需为此优化。
---
### 14. 🚧 阻塞的进程阈值 = `0`
- **含义**:当阻塞超过多少秒时记录到日志?0 表示不记录。
- **建议改为**:`5` 或 `10`> 便于监控和排查死锁/阻塞问题。
```sql
EXEC sp_configure 'blocked process threshold (s)', 5;
RECONFIGURE;
```
---
### 15. 📄 最大文本复制大小 = `65536`
- **含义**:复制操作中单次传输的最大文本大小(KB)。
- **建议**:✅ **保持 65536(64MB)**
- 对大多数场景足够,除非你有超大字段复制需求。
---
## ✅ 二、补充建议(不在本页面,但密切相关)
虽然这些不在“高级”页,但对整体性能至关重要:
### 1. 【内存】回到“内存”页设置最大内存 = 81920 MB(80GB)
> 如前所述,这是最关键的一步!
### 2. 【TempDB】多文件配置
```sql
-- 添加 4 个 TempDB 数据文件(假设路径 D:\TempDB\)
ALTER DATABASE tempdb ADD FILE (NAME = tempdev2, FILENAME = 'D:\TempDB\tempdb2.ndf', SIZE = 8GB, MAXSIZE = UNLIMITED, FILEGROWTH = 512MB);
ALTER DATABASE tempdb ADD FILE (NAME = tempdev3, FILENAME = 'D:\TempDB\tempdb3.ndf', SIZE = 8GB, MAXSIZE = UNLIMITED, FILEGROWTH = 512MB);
ALTER DATABASE tempdb ADD FILE (NAME = tempdev4, FILENAME = 'D:\TempDB\tempdb4.ndf', SIZE = 8GB, MAXSIZE = UNLIMITED, FILEGROWTH = 512MB);
```
### 3. 【数据库级别】开启 READ\_COMMITTED\_SNAPSHOT
```sql
ALTER DATABASE [Kingdee.K3Cloud] SET READ_COMMITTED_SNAPSHOT ON WITH ROLLBACK IMMEDIATE;
```
---
## 📊 总结:你需要修改的关键项
| 配置项 | 当前值 | 建议值 | 是否紧急 |
|---|
| 最大并行度 | 4 | **8** | 🔴 高 |
| 并行的开销阈值 | 5 | **50** | 🔴 高 |
| 查询等待值 | -1 | **30** | 🟡 中 |
| 阻塞的进程阈值 | 0 | **5** | 🟡 中 |
| 最大服务器内存(另页) | 2TB | **81920 MB** | 🔴 必须改 |
---
## 🛠️ 一键优化脚本(复制粘贴执行)
```sql
-- 设置并行度相关
EXEC sp_configure 'show advanced options', 1;
RECONFIGURE;
EXEC sp_configure 'max degree of parallelism', 8;
EXEC sp_configure 'cost threshold for parallelism', 50;
EXEC sp_configure 'parallel wait time (ms)', 30000; -- 30秒
EXEC sp_configure 'blocked process threshold (s)', 5;
RECONFIGURE;
-- 设置内存(在“内存”页图形界面操作更安全,也可用下面命令)
EXEC sp_configure 'max server memory (MB)', 81920;
RECONFIGURE;
```
---
## ✅ 最终提醒
- 所有更改建议在**非业务高峰期**进行。
- 修改后观察任务管理器、性能监视器(PerfMon)、SQL Server DMVs(如 `sys.dm_exec_requests`)确认效果。
- 对于金蝶云星空,**稳定性第一,性能第二** —— 不要过度追求极限参数。
---
你当前的 SQL Server 2022 服务器配置非常强大:**24核 CPU + 100GB 内存**,但截图中显示:
> **最大服务器内存 (MB) = 2147483647 MB(即约 2TB)**
这显然是**默认值或未手动限制**,在生产环境中这是**严重隐患** —— SQL Server 会试图占用所有可用内存,导致操作系统和其他应用(如金蝶云星空、IIS、防病毒软件等)内存不足,引发系统卡顿、崩溃甚至蓝屏。
---
## ✅ 核心优化建议(针对你的硬件和业务场景)
### 🎯 1. 【必须做】限制 SQL Server 最大内存使用量
#### ❗为什么?
SQL Server 默认“贪吃”内存,不会主动留给 OS 和其他进程。即使你有 100GB 物理内存,也应预留一部分给操作系统和金蝶应用层。
#### ✅ 推荐设置:
- **总内存**: 100 GB
- **留给操作系统 + 其他应用**: 至少 16~20 GB(保守起见)
- **分配给 SQL Server**: **80 GB**
👉 在“服务器属性 → 内存”中设置:
```
最小服务器内存(MB): 0 (或设为 40960 = 40GB,避免频繁伸缩)
最大服务器内存(MB): 81920 (= 80GB)
```
> 💡 注:1 GB = 1024 MB → 80 × 1024 = 81920 MB
✅ 设置后点击“确定”,无需重启服务即可生效(动态调整)。
---
### 🎯 2. 【可选但推荐】设置最小内存(防止内存被过度回收)
如果你的服务器上只有 SQL Server 和金蝶应用,且希望保证数据库性能稳定,可以设置:
```
最小服务器内存(MB): 40960 (= 40GB)
```
这样即使系统压力大,SQL Server 也能保留至少 40GB 内存,避免因内存波动导致查询变慢。
---
### 🎯 3. 【高级优化】启用“锁定页面内存”权限(Lock Pages in Memory)
#### ⚠️ 适用条件:
- 操作系统是 **Windows Server**(非 Win10/Win11)
- SQL Server 运行账户具有“锁定页面内存”权限
- 用于防止 SQL Server 内存被换页到磁盘(提升稳定性)
#### 🔧 操作步骤:
1. 打开 `gpedit.msc` → 计算机配置 → Windows 设置 → 安全设置 → 本地策略 → 用户权利分配
2. 找到 **“锁定内存中的页面”**
3. 添加 SQL Server 服务启动账户(通常是 `NT SERVICE\MSSQLSERVER` 或自定义域账户)
4. 重启 SQL Server 服务
> ✅ 此操作可显著提升高负载下的稳定性,尤其适合金蝶这种 ERP 系统。
---
### 🎯 4. 【CPU 相关】检查并行度与成本阈值
虽然你有 24 核,但不要放任 SQL Server 自动决定并行计划。
#### 建议设置:
```sql
-- 查看当前配置
EXEC sp_configure 'show advanced options', 1;
RECONFIGURE;
EXEC sp_configure 'max degree of parallelism';
EXEC sp_configure 'cost threshold for parallelism';
-- 推荐设置(根据经验):
EXEC sp_configure 'max degree of parallelism', 8; -- 最多使用8个CPU核心 per query
EXEC sp_configure 'cost threshold for parallelism', 50; -- 只有成本 > 50 的查询才启用并行
RECONFIGURE;
```
> 💡 理由:避免单个大查询占满全部24核,影响并发用户体验;同时避免小查询不必要的并行开销。
---
### 🎯 5. 【存储与 TempDB 优化】
#### ✅ TempDB 多文件配置(强烈建议):
TempDB 是临时对象密集区,多文件可减少争用。
```sql
-- 假设你有4个逻辑驱动器(或SSD分区),每个放一个TempDB数据文件
ALTER DATABASE tempdb
ADD FILE (NAME = tempdev2, FILENAME = 'D:\TempDB\tempdb2.ndf', SIZE = 8GB, MAXSIZE = UNLIMITED, FILEGROWTH = 512MB);
-- 重复添加至共4~8个文件(一般不超过8个)
```
> 📌 文件大小建议初始设为相同(如8GB),增长步长一致,避免碎片。
#### ✅ 数据文件预分配空间:
不要依赖自动增长!提前为数据库主数据文件和日志文件分配足够空间(比如各50GB+),并关闭自动增长或设较大增量(如512MB)。
---
### 🎯 6. 【监控与维护】
#### ✅ 启用性能计数器监控:
- `SQLServer:Memory Manager\Total Server Memory (KB)`
- `SQLServer:Memory Manager\Target Server Memory (KB)`
- `Page life expectancy`(应 > 300秒)
- `Batch Requests/sec`(反映吞吐量)
#### ✅ 定期更新统计信息 & 重建索引:
```sql
-- 示例:每周凌晨执行
EXEC sp_updatestats;
-- 或使用 Ola Hallengren 脚本进行智能维护
```
---
### 🎯 7. 【金蝶云星空特别注意事项】
金蝶云星空对 SQL Server 有特定要求:
- 推荐使用 **简单恢复模式**(除非你需要 point-in-time recovery)
- 避免开启 “自动创建统计信息” 和 “自动更新统计信息”(由金蝶后台作业控制更佳)
- 确保 `READ_COMMITTED_SNAPSHOT` 开启(减少锁阻塞):
```sql
ALTER DATABASE [YourK3CloudDB] SET READ_COMMITTED_SNAPSHOT ON WITH ROLLBACK IMMEDIATE;
```
---
## 📊 总结:你的服务器优化清单
| 项目 | 当前状态 | 建议设置 | 是否紧急 |
|---|
| 最大内存 | 2TB(危险!) | **80GB** | 🔴 必须立即改 |
| 最小内存 | 0 | 40GB(可选) | 🟡 推荐 |
| 并行度 | 默认(可能24) | **8** | 🟡 推荐 |
| 成本阈值 | 默认5 | **50** | 🟡 推荐 |
| TempDB 文件数 | 未知 | **4~8个等大文件** | 🟢 重要 |
| 锁定页面内存 | 未启用 | **启用**(若为Server系统) | 🟢 推荐 |
| 统计信息/索引维护 | 未知 | **定期自动化** | 🟢 必需 |
---
## 🛠️ 快速执行脚本(复制粘贴到 SSMS 执行)
```sql
-- 1. 设置内存上限 80GB
EXEC sp_configure 'show advanced options', 1;
RECONFIGURE;
EXEC sp_configure 'max server memory (MB)', 81920;
RECONFIGURE;
-- 2. 设置最小内存 40GB(可选)
EXEC sp_configure 'min server memory (MB)', 40960;
RECONFIGURE;
-- 3. 设置并行度和成本阈值
EXEC sp_configure 'max degree of parallelism', 8;
EXEC sp_configure 'cost threshold for parallelism', 50;
RECONFIGURE;
-- 4. 开启读提交快照隔离(替换为你的数据库名)
ALTER DATABASE [Kingdee.K3Cloud] SET READ_COMMITTED_SNAPSHOT ON WITH ROLLBACK IMMEDIATE;
```
---
## ✅ 最后提醒
- 修改内存设置后,观察任务管理器或性能监视器,确认 SQL Server 实际占用内存不再持续增长。
- 如果后续发现内存不够(如 PLE < 100),再逐步上调最大内存(每次+5GB)。
- 对于金蝶这类ERP系统,**稳定性 > 极致性能**,宁可留点余量,也不要榨干资源。
---
如有需要,我可以为你生成完整的“金蝶云星空 + SQL Server 2022 优化部署文档”或提供 Ola Hallengren 维护脚本模板。欢迎继续提问!
# nat会话数60万对hyper-v服务器及路由器进行的优化操作
从你贴出的结果来看,这些配置都已经生效了,而且从 **Windows Server 2025 + Hyper-V + 万兆网络 + 大量虚拟机通信** 的场景来看,总体是合理的。
### 当前状态分析
#### 1. TCP 动态端口范围
修改前:
```text
49152-65535
共16384个端口
```
修改后:
```text
1025-65535
共64511个端口
```
验证:
```cmd
netsh int ipv4 show dynamicport tcp
```
结果:
```text
启动端口 : 1025
端口数 : 64511
```
说明已生效。
适用于:
- Hyper-V主机
- 数据同步服务器
- 大量TCP短连接
- IIS/Nginx反向代理
- RabbitMQ
- MongoDB/MySQL同步
可显著降低临时端口耗尽风险。
---
#### 2. UDP 动态端口范围
你又执行了:
```cmd
netsh int ipv4 set dynamicport udp start=1025 num=64511
```
验证:
```text
启动端口 : 1025
端口数 : 64511
```
已生效。
对于:
- DNS
- SIP
- SNMP
- VXLAN
- 某些监控系统
有帮助。
---
#### 3. TCP Auto-Tuning
修改前:
```text
接收窗口自动调节级别 : disabled
```
修改后:
```text
接收窗口自动调节级别 : normal
```
对于万兆环境建议保持:
```text
normal
```
不要改成:
```text
experimental
```
微软官方也不推荐生产环境使用 experimental。
---
#### 4. RFC1323 Timestamp
当前:
```text
RFC 1323 时间戳 : allowed
```
这里不是 enabled,而是:
```text
allowed
```
表示:
```text
可以协商使用
但不会强制使用
```
这是 Windows Server 2022/2025 的正常默认值。
建议保持:
```text
allowed
```
不要改 disabled。
原因:
- SMB3
- Hyper-V Live Migration
- 高带宽高延迟链路
会受益于 Timestamp。
---
#### 5. ECN
当前:
```text
ECN 功能 : enabled
```
这个比较特殊。
ECN(Explicit Congestion Notification)用于网络拥塞通知。
优点:
```text
减少丢包
提高吞吐
```
缺点:
```text
某些旧交换机
某些旧防火墙
某些运营商设备
兼容性不好
```
如果你网络里有:
- 老华为交换机
- 老H3C交换机
- 老防火墙
建议改回:
```cmd
netsh int tcp set global ecncapability=disabled
```
如果全是新设备,可以保持 enabled。
---
### 关于 winnat
你执行:
```cmd
net stop winnat
```
返回:
```text
没有启动 Windows NAT Driver 服务
```
这是正常的。
说明当前主机没有使用:
```text
Hyper-V NAT
Docker NAT
Container NAT
```
至少没有启用 WinNAT。
无需处理。
---
### 我建议你再检查两个关键项
#### 查看端口耗尽情况
PowerShell:
```powershell
Get-NetTCPConnection | Measure-Object
```
查看当前连接数。
---
#### 查看 TIME\_WAIT 数量
```cmd
netstat -ano | find /c "TIME_WAIT"
```
如果经常超过:
```text
10000+
```
甚至:
```text
30000+
```
那么扩大动态端口范围就非常有价值。
---
### 针对你的 Hyper-V 宿主机
我建议最终配置如下:
```cmd
netsh int tcp set global autotuninglevel=normal
netsh int ipv4 set dynamicport tcp start=1025 num=64511
netsh int ipv4 set dynamicport udp start=1025 num=64511
netsh int tcp set global timestamps=enabled
```
或者保持当前:
```text
RFC1323 时间戳 : allowed
```
即可。
如果你这台服务器承担 20 个以上 Hyper-V 虚拟机,并且有 MySQL、MongoDB、RabbitMQ、文件同步等大量东西南北向流量,我还建议检查:
```powershell
Get-NetAdapterRss
Get-NetAdapterRsc
Get-NetAdapterAdvancedProperty
```
看看万兆网卡是否开启了:
- RSS(Receive Side Scaling)
- VMQ(Virtual Machine Queue)
- VMMQ(Virtual Machine Multi Queue)
- RSC(Receive Segment Coalescing)
这些优化对 Hyper-V 的收益往往比修改 TCP 参数更明显。
从你提供的数据来看,这台 **Windows Server 2025 Hyper-V 宿主机** 的网络配置整体比较健康,没有发现明显异常。
## 一、当前TCP连接数
```powershell
Get-NetTCPConnection | Measure-Object
Count : 203
```
只有:
```text
203个TCP连接
```
对于:
- Hyper-V宿主机
- 20多个虚拟机
- 万兆网络
来说非常低。
因此:
```cmd
netsh int ipv4 set dynamicport tcp start=1025 num=64511
```
实际上暂时用不上,但保留也没有问题。
---
## 二、82599万兆网卡RSS状态
你最重要的网卡:
```text
Intel 82599 10G #1
Intel 82599 10G #2
```
其中:
```text
SLOT 4 端口 2
```
显示:
```text
Enabled : True
NumberOfReceiveQueues : 128
Profile : NUMAStatic
```
说明:
```text
RSS 已开启
```
这是好的。
---
### 但有个异常
#### SLOT 4 端口1
显示:
```text
NumberOfReceiveQueues : 8
```
但是:
```text
RssProcessorArray :
IndirectionTable :
```
为空。
这通常意味着:
```text
RSS未真正工作
或驱动异常
或网卡未承载流量
```
建议检查:
```powershell
Get-NetAdapterStatistics -Name "SLOT 4 端口 1"
Get-NetAdapterStatistics -Name "SLOT 4 端口 2"
```
看看哪个接口真正有流量。
---
## 三、Hyper-V虚拟交换机
你有:
```text
vEthernet (10.1.1.104-nic1)
vEthernet (10.2.2.4-slot4_2)
```
均显示:
```text
NumberOfReceiveQueues : 16
```
说明:
```text
vRSS 已开启
```
这是正确配置。
---
## 四、RSC状态
你执行:
```powershell
Get-NetAdapterRsc
```
结果:
```text
IPv4Enabled : True
IPv4Operational : False
FailureReason : ForwardingEnabled
```
这是正常现象。
原因:
```text
Hyper-V Virtual Switch
开启转发模式
```
RSC会自动失效。
微软设计如此。
因此:
```text
False
```
不是故障。
---
## 五、建议检查VMQ
Hyper-V性能最关键的是:
```powershell
Get-NetAdapterVmq
```
如果看到:
```text
Enabled : True
```
则正常。
如果:
```text
Enabled : False
```
建议开启:
```powershell
Enable-NetAdapterVmq -Name "SLOT 4 端口 2"
```
---
## 六、建议检查VMMQ
Windows Server 2022/2025非常重要。
执行:
```powershell
Get-NetAdapterVmq
```
和:
```powershell
Get-VMSwitch
```
以及:
```powershell
Get-VMSwitchTeam
```
看看是否启用了:
```text
VMMQ
Virtual Machine Multi Queue
```
对于:
```text
20台以上虚拟机
10G以上网卡
```
收益很大。
---
## 七、82599网卡的特殊优化
Intel 82599 是老牌但非常稳定的万兆芯片。
推荐检查:
```powershell
Get-NetAdapterAdvancedProperty -Name "SLOT 4 端口 2"
```
重点关注:
### Jumbo Frame
建议:
```text
9014
```
或:
```text
9000
```
前提:
- 交换机支持
- 对端支持
---
### Interrupt Moderation
建议:
```text
Enabled
```
---
### Receive Side Scaling
建议:
```text
Enabled
```
---
### Flow Control
如果用于Hyper-V内部同步:
建议:
```text
Rx & Tx Enabled
```
---
## 八、根据你目前输出的结论
| 项目 | 状态 |
|---|
| TCP动态端口 | ✅ 正常 |
| UDP动态端口 | ✅ 正常 |
| Auto Tuning | ✅ 正常 |
| RSS | ✅ 已开启 |
| vRSS | ✅ 已开启 |
| RSC | ✅ 正常(Hyper-V导致) |
| TCP连接数 | ✅ 极低 |
| TIME\_WAIT风险 | ✅ 几乎没有 |
| 82599万兆网卡 | ✅ 工作正常 |
| Hyper-V交换机 | ✅ 正常 |
目前看不到需要进一步调整 TCP 参数的地方。
下一步最值得检查的是:
```powershell
Get-NetAdapterVmq
Get-NetAdapterAdvancedProperty -Name "SLOT 4 端口 2"
Get-NetAdapterStatistics -Name "SLOT 4 端口 2"
```
尤其是 VMQ 和 Jumbo Frame 配置,它们对 Hyper-V 虚拟机间的大流量传输影响比前面那几条 `netsh` 命令更大。
不准确,或者更准确地说:
```powershell
Get-NetTCPConnection | Measure-Object
```
只能统计 **当前 Windows 宿主机 TCP/IP 协议栈中的连接**,并不能统计 Hyper-V 虚拟机内部的连接。
你的结果:
```text
Count : 203
```
表示:
```text
宿主机自身只有203个TCP连接
```
包括:
- RDP
- SMB
- DNS
- Hyper-V管理流量
- 宿主机运行的服务
而不包括:
```text
VM内部的TCP连接
VM内部的NAT会话
VM内部的Docker连接
VM内部的应用连接
```
---
### 你的网络结构大概率是
```text
Internet
│
▼
路由器/防火墙
│
▼
Hyper-V宿主机
│
▼
虚拟交换机
│
┌──┼──────────┐
│ │ │
VM1 VM2 VM20
```
如果 NAT 服务运行在某个 VM 里面:
```text
OpenClash
Linux NAT
软路由
RouterOS
pfSense
OpenWRT
```
那么:
```powershell
Get-NetTCPConnection
```
看到的仍然可能只有:
```text
100~500个连接
```
因为 60 万 NAT 会话全部存在于 VM 内部。
---
### 如何确认 NAT 在哪里
查看宿主机是否存在 NAT:
```powershell
Get-NetNat
```
如果返回:
```text
No MSFT_NetNat objects found
```
说明:
```text
宿主机没有承担NAT
```
---
查看宿主机连接跟踪:
```powershell
Get-NetTCPConnection | Group-Object State
```
例如:
```text
Established : 150
TimeWait : 30
Listen : 20
```
说明宿主机压力很小。
---
### 如果 NAT 在 OpenWrt VM
例如:
```text
OpenWrt VM
192.168.1.1
```
查看:
```bash
cat /proc/sys/net/netfilter/nf_conntrack_count
```
或者:
```bash
conntrack -C
```
才能看到:
```text
600000
```
这样的会话数。
---
### 如果 NAT 在 Windows VM
查看:
```powershell
Get-NetNatSession | Measure-Object
```
或者:
```powershell
Get-NetNatSession
```
---
### 对于你的环境
你之前描述:
- Hyper-V
- 40个虚拟机
- OpenClash
- 大量代理流量
- 万兆交换机
我判断:
```text
60万 NAT 会话
```
极有可能在:
- OpenWrt VM
- Linux VM
- RouterOS VM
- pfSense VM
里面,而不是宿主机。
因此:
```powershell
Get-NetTCPConnection | Measure-Object
```
得到的:
```text
203
```
只是宿主机自身连接数,不能反映整体业务流量。
---
如果你想评估 **Hyper-V 宿主机是否会因为 60 万 NAT 会话受到影响**,更有价值的是查看:
```powershell
Get-Counter '\Network Interface(*)\Bytes Total/sec'
Get-Counter '\Hyper-V Virtual Switch(*)\Bytes/sec'
Get-Counter '\Hyper-V Virtual Network Adapter(*)\Bytes/sec'
```
以及:
```powershell
Get-NetAdapterStatistics
```
这样可以看到:
- 实际吞吐量(Gbps)
- PPS(每秒包数)
- 丢包
- 队列压力
这些指标比 `Get-NetTCPConnection` 更能反映 Hyper-V 宿主机在高峰期是否接近瓶颈。
# nat高峰期的检查
从你贴出的数据来看,可以得出几个比较明确的结论。
# 1. 当前根本不在业务高峰期
你采集时:
```text
物理10G网卡:
183738 Bytes/sec
```
换算:
```text
183738 × 8 ≈ 1.47 Mbps
```
不到 2Mbps。
而 Hyper-V 虚拟交换机:
```text
1903091 Bytes/sec
```
换算:
```text
1903091 × 8 ≈ 15.2 Mbps
```
仍然非常低。
对于万兆网:
```text
10 Gbps = 10000 Mbps
```
当前利用率:
```text
15 / 10000 = 0.15%
```
几乎空闲。
因此这些数据只能说明:
```text
采集时服务器负载极低
```
无法反映晚高峰状态。
---
# 2. 203个TCP连接完全正常
宿主机:
```powershell
Get-NetTCPConnection | Group-Object State
```
结果:
```text
Established : 24
Listen : 110
TimeWait : 37
```
说明:
### 宿主机自身压力极低
24个已建立连接基本属于:
- RDP
- DNS
- Hyper-V管理
- SMB
- 监控
级别。
所以:
```text
宿主机没有TCP连接压力
```
---
# 3. 60万NAT会话不在宿主机
从你的拓扑看:
```text
Hyper-V
├─ OpenClash
├─ Ubuntu
├─ RULR
├─ MongoDB
├─ MySQL
└─ ...
```
你以前提到:
```text
60万 NAT Session
```
如果真达到:
```text
600000+
```
那么一定在某台VM内部。
因为宿主机看到的:
```text
Established 24
```
根本不可能对应60万会话。
---
# 4. 真正应该监控什么
对于你的场景:
```text
Windows Server 2025
Hyper-V
40台VM
万兆交换机
```
最有价值的指标不是:
```powershell
Get-NetTCPConnection
```
而是:
### PPS
每秒包数
查看:
```powershell
Get-Counter '\Network Interface(*)\Packets Received/sec'
Get-Counter '\Network Interface(*)\Packets Sent/sec'
```
---
### VMQ队列
查看:
```powershell
Get-NetAdapterVmq
```
---
### CPU中断
查看:
```powershell
Get-Counter '\Processor Information(*)\% Interrupt Time'
```
---
### DPC延迟
查看:
```powershell
Get-Counter '\Processor Information(*)\% DPC Time'
```
---
# 5. 你这个环境最大的风险是什么
其实不是端口数。
你已经改成:
```text
1025-65535
64511个动态端口
```
够用了。
真正需要关注的是:
### Intel 82599
这是非常经典的万兆卡。
但:
```text
82599 不支持 VMMQ
```
只支持:
```text
RSS
VMQ
SR-IOV
```
不支持新一代:
```text
VMMQ
vRSS增强
```
所以当:
```text
30~40台虚拟机
数十万连接
```
同时跑时,
瓶颈往往出现在:
```text
CPU中断
VMQ队列
```
而不是TCP端口。
---
# 6. 建议晚高峰采集
晚上业务高峰时执行:
```powershell
Get-NetAdapterStatistics
```
记录一次。
然后间隔30秒:
```powershell
Get-NetAdapterStatistics
```
再记录一次。
我帮你计算:
```text
实际吞吐量
PPS
单包大小
```
就能判断:
- 是否接近82599极限
- 是否出现小包风暴
- 是否需要开启SR-IOV
- 是否需要升级到X710/X550/E810
---
# 7. 你的当前状态
根据目前所有输出:
| 项目 | 状态 |
|---|
| TCP动态端口 | 正常 |
| UDP动态端口 | 正常 |
| AutoTuning | 正常 |
| RSS | 已开启 |
| Hyper-V vRSS | 已开启 |
| 宿主机连接数 | 极低 |
| 万兆网利用率 | 极低 |
| NAT会话压力 | 不在宿主机 |
| TCP参数瓶颈 | 未发现 |
| 网络瓶颈 | 未发现 |
因此目前可以确定:
```text
Get-NetTCPConnection | Measure-Object
得到的203
只能代表宿主机自身连接数
与虚拟机里的60万NAT会话没有直接关系
```
如果要评估那 60 万 NAT 会话对宿主机的影响,需要在晚高峰时采集 VM 所在虚拟交换机的 PPS、吞吐量和 CPU 中断数据,而不是看 TCP 连接数。
[](https://bost.lesrec.cn/uploads/images/gallery/2026-06/fgIowUYnxKXPDxqh-EpNzZubwSv.png)
从你提供的 Ubuntu NAT 虚拟机数据来看,目前距离系统极限还非常远。
### 当前参数
#### 1. 本地动态端口范围
```bash
cat /proc/sys/net/ipv4/ip_local_port_range
1024 65000
```
可用端口数:
```text
65000 - 1024 + 1
= 63977 个
```
已经接近 Linux 推荐最大范围。
---
#### 2. 当前 conntrack 会话数
```bash
conntrack -C
26223
```
即:
```text
26223 个连接跟踪项
```
---
#### 3. conntrack 上限
```bash
cat /proc/sys/net/netfilter/nf_conntrack_max
1048576
```
即:
```text
1048576 个
≈ 104万
```
---
### 使用率计算
```text
26223 / 1048576
≈ 2.5%
```
仅使用了:
```text
2.5%
```
还有:
```text
97.5%
```
剩余空间。
---
## 结论一:当前不存在 conntrack 瓶颈
如果系统因为 conntrack 满而出问题,会出现:
```bash
dmesg | grep conntrack
```
类似:
```text
nf_conntrack: table full, dropping packet
```
而你目前:
```text
26223 / 1048576
```
差距巨大。
---
## 结论二:当前不存在 Linux 端口耗尽
Linux NAT 最容易碰到的是:
```text
源IP固定
+
端口耗尽
```
因为:
```text
一个公网IP
最多约64000个源端口
```
你当前:
```text
端口范围
1024~65000
≈63977个端口
```
已经足够大。
---
### 理论极限
如果:
```text
1个公网IP
```
进行 SNAT:
```text
10.1.1.1:50001
10.1.1.1:50002
...
```
理论最多:
```text
63977 个并发连接
```
到同一个目标IP:PORT。
---
### 但 conntrack 有 104 万
为什么还能支持几十万连接?
因为:
```text
不同目标IP
不同目标端口
```
可以复用源端口。
例如:
```text
1.1.1.1:443
8.8.8.8:443
114.114.114.114:443
```
即使源端口相同也没问题。
conntrack 是按五元组区分的:
```text
源IP
源端口
目的IP
目的端口
协议
```
---
## 如果你说高峰期有 60 万 NAT 会话
那么我建议高峰期查看:
### 查看实时 conntrack
```bash
watch -n 1 'conntrack -C'
```
或者:
```bash
while true
do
date
conntrack -C
sleep 5
done
```
---
### 查看 conntrack 使用率
```bash
echo $(( $(conntrack -C) * 100 / $(cat /proc/sys/net/netfilter/nf_conntrack_max) ))
```
---
### 查看连接状态
```bash
conntrack -S
```
重点看:
```text
insert
insert_failed
drop
early_drop
```
如果:
```text
insert_failed > 0
```
说明 conntrack 已经开始吃紧。
---
### 查看 TCP 状态分布
```bash
ss -ant | awk '{print $1}' | sort | uniq -c
```
或者:
```bash
ss -s
```
重点看:
```text
ESTAB
TIME-WAIT
SYN-RECV
```
---
## 需要特别关注的一点
你前面提到:
```text
2台 Windows Server 2025
Hyper-V
40台虚拟机
大量数据交互
```
如果承担 NAT 的是 Ubuntu 虚拟机,那么真正需要监控的不是:
```text
Windows 动态端口
```
而是:
```text
nf_conntrack_count
nf_conntrack_max
CPU softirq
网卡 PPS
TIME_WAIT 数量
SYN_RECV 数量
```
因为在大规模 NAT 场景中,最先出问题的通常是:
```text
CPU软中断
>
conntrack
>
端口范围
```
而不是 Windows 宿主机的动态端口。
建议在晚上业务高峰时再执行下面这一组命令:
```bash
date
uptime
conntrack -C
cat /proc/sys/net/netfilter/nf_conntrack_max
ss -s
cat /proc/sys/net/ipv4/ip_local_port_range
sar -n DEV 1 5
mpstat -P ALL 1 5
```
从这些数据基本可以准确判断:
- 是否接近 60 万会话;
- 是否存在 conntrack 压力;
- 是否出现 CPU softirq 瓶颈;
- 是否需要继续扩大 conntrack 或优化 NAT 架构。
# hyper-v 70万nat会话数流量分析
结合你前面提供的所有数据(Hyper-V、sar、conntrack、iptables NAT),已经基本可以定位问题方向了。
# 一、当前流量路径
你的架构大概是:
```text
互联网
│
▼
rulr-4 / rulr-5(NAT代理)
│
├── rulr2-01
├── rulr2-02
└── rulr2-03
```
外部约 60 万 NAT 会话:
```text
rulr-4 ≈ 36万
rulr-5 ≈ 34万
```
合计:
```text
≈ 70万连接
```
与描述的60万级连接基本一致。
---
# 二、最重要的发现
从 sar -n SOCK 看:
## rulr-4
```text
367779
365949
367271
369945
```
约:
```text
36~37万 Socket
```
---
## rulr-5
```text
338756
341389
344627
344251
```
约:
```text
33~34万 Socket
```
---
但是后端:
## rulr2-01
```text
803
810
```
只有:
```text
800个连接
```
---
## rulr2-02
```text
118000
122000
```
约:
```text
12万连接
```
---
## rulr2-03
```text
117000
123000
```
约:
```text
12万连接
```
---
说明:
```text
rulr2-02
rulr2-03
承担主要业务连接
rulr2-01
几乎没接到流量
```
负载均衡根本没均匀。
---
# 三、iptables输出暴露的问题
你贴出的 NAT 表:
```text
75M 3632M DNAT tcp dpt:6031
```
这一条特别异常:
```text
75M packets
3632M bytes
```
而其它规则:
```text
6100
6101
6102
...
```
只有几千包。
---
说明:
6031端口承担了绝大部分业务。
例如:
```text
6031
↓
172.18.0.200
↓
容器
↓
rulr2-02/rulr2-03
```
---
因此真正热点在:
```text
6031
```
不是整个代理。
---
# 四、网络是否到瓶颈
根据你之前的 sar:
eth0
```text
rxkB/s ≈ 200
txkB/s ≈ 180
```
即:
```text
200 KB/s
```
换算:
```text
≈ 1.6 Mbps
```
---
即便考虑采样误差:
```text
< 10 Mbps
```
---
而宿主机是:
```text
Intel 82599
10G
```
所以:
```text
10Gbps
↓
实际只有几Mbps
```
差了上千倍。
---
结论:
❌ 不是带宽瓶颈
---
# 五、Hyper-V数据也证明不是网卡瓶颈
你抓到:
```text
Packets Received/sec
3066
```
仅:
```text
3000 PPS
```
---
10G网卡正常能承受:
```text
100万 PPS以上
```
---
当前:
```text
3000 PPS
```
连 1% 都不到。
---
# 六、CPU中断情况
你抓到:
```text
% DPC Time
Total:
0.52%
```
---
说明:
```text
网卡中断压力极低
```
如果真是网卡瓶颈:
```text
DPC
20%
30%
40%
```
都常见。
---
你这里只有:
```text
0.5%
```
非常健康。
---
# 七、真正可疑的地方
从目前证据看:
网络没满
网卡没满
CPU没满
conntrack没满
端口没满
---
最可疑的是:
## NAT状态表查找开销
你目前:
```text
rulr-4
≈37万连接
rulr-5
≈34万连接
```
---
虽然:
```text
nf_conntrack_max=1048576
```
没到上限。
但是:
```text
30~40万活跃连接
```
已经足以让:
```text
conntrack hash
NAT lookup
```
消耗明显 CPU。
---
建议查看:
```bash
conntrack -S
```
重点看:
```text
insert_failed
drop
early_drop
search_restart
```
---
# 八、进一步验证
在晚高峰(20:00~22:00)执行:
```bash
sar -n TCP,ETCP 60
```
看:
```text
active/s
passive/s
retrans/s
```
---
特别关注:
```text
retrans/s
```
如果:
```text
>100
>1000
```
说明开始拥塞。
---
再看:
```bash
sar -n DEV 60
```
重点:
```text
%ifutil
```
---
如果:
```text
<10%
```
则绝对不是带宽问题。
---
# 九、我目前的判断
综合所有证据:
| 项目 | 状态 |
|---|
| 10G物理网卡 | 正常 |
| Hyper-V交换机 | 正常 |
| 宿主机CPU | 正常 |
| DPC中断 | 正常 |
| 虚拟机带宽 | 正常 |
| nf\_conntrack\_max | 充足 |
| ip\_local\_port\_range | 充足 |
| NAT连接数 | 偏高 |
| 后端负载均衡 | 明显不均衡 |
最大的异常反而是:
```text
rulr2-01 ≈ 800连接
rulr2-02 ≈ 12万连接
rulr2-03 ≈ 12万连接
```
这说明后端负载均衡没有真正做到 1:1:1 分流。
下一步我建议直接查看 rulr-4/rulr-5 上负责分流到 rulr2-01、02、03 的具体 iptables(或 haproxy/nginx)配置,包括:
```bash
iptables-save
```
或者:
```bash
iptables -t nat -S
```
中涉及 `rulr2-01、rulr2-02、rulr2-03` 的 DNAT 规则。
把这部分贴出来,我可以直接帮你计算实际流量命中比例,并判断为什么 rulr2-01 几乎没有接到会话。
# 创建 PowerShell 脚本,19点到23点每半小时执行1次,统计网卡连接数
建议采用 **PowerShell + BAT + 计划任务(Task Scheduler)** 的方式,因为你列出的命令都是 PowerShell Cmdlet,直接写到 BAT 中会比较麻烦。
## 1. 创建 PowerShell 脚本
保存为:
```text
D:\temp\get_connection.ps1
```
内容如下:
```powershell
$LogFile = "D:\temp\get_connection.log"
Add-Content $LogFile ""
Add-Content $LogFile "============================================================"
Add-Content $LogFile "$(Get-Date -Format 'yyyy-MM-dd HH:mm:ss')"
Add-Content $LogFile "============================================================"
Add-Content $LogFile ""
Add-Content $LogFile "[Get-NetTCPConnection | Measure-Object]"
Get-NetTCPConnection | Measure-Object | Out-String | Add-Content $LogFile
Add-Content $LogFile ""
Add-Content $LogFile "[Get-NetAdapterVmq]"
Get-NetAdapterVmq | Format-Table -AutoSize | Out-String | Add-Content $LogFile
Add-Content $LogFile ""
Add-Content $LogFile "[Get-NetAdapterStatistics]"
Get-NetAdapterStatistics | Format-Table -AutoSize | Out-String | Add-Content $LogFile
Add-Content $LogFile ""
Add-Content $LogFile "[Get-NetTCPConnection | Group-Object State]"
Get-NetTCPConnection | Group-Object State | Format-Table -AutoSize | Out-String | Add-Content $LogFile
Add-Content $LogFile ""
Add-Content $LogFile "[Network Interface Bytes Total/sec]"
Get-Counter '\Network Interface(*)\Bytes Total/sec' |
Select-Object -ExpandProperty CounterSamples |
Format-Table InstanceName,CookedValue -AutoSize |
Out-String | Add-Content $LogFile
Add-Content $LogFile ""
Add-Content $LogFile "[Hyper-V Virtual Switch Bytes/sec]"
Get-Counter '\Hyper-V Virtual Switch(*)\Bytes/sec' |
Select-Object -ExpandProperty CounterSamples |
Format-Table InstanceName,CookedValue -AutoSize |
Out-String | Add-Content $LogFile
Add-Content $LogFile ""
Add-Content $LogFile "[Network Interface Packets Sent/sec]"
Get-Counter '\Network Interface(*)\Packets Sent/sec' |
Select-Object -ExpandProperty CounterSamples |
Format-Table InstanceName,CookedValue -AutoSize |
Out-String | Add-Content $LogFile
Add-Content $LogFile ""
Add-Content $LogFile "[Hyper-V Virtual Network Adapter Bytes/sec]"
Get-Counter '\Hyper-V Virtual Network Adapter(*)\Bytes/sec' |
Select-Object -ExpandProperty CounterSamples |
Format-Table InstanceName,CookedValue -AutoSize |
Out-String | Add-Content $LogFile
```
---
## 2. 创建 BAT 启动脚本
保存为:
```text
D:\temp\get_connection.bat
```
内容:
```bat
@echo off
powershell.exe -NoProfile -ExecutionPolicy Bypass -File "D:\temp\get_connection.ps1"
```
测试:
```cmd
D:\temp\get_connection.bat
```
查看:
```text
D:\temp\get_connection.log
```
是否生成日志。
---
## 3. 创建计划任务
打开:
```text
任务计划程序
(Task Scheduler)
```
创建任务:
### 常规
```text
名称:
Get_Connection_Monitor
使用最高权限运行
无论用户是否登录都运行
```
---
### 触发器
新增 8 个触发器:
| 时间 |
|---|
| 19:30 |
| 20:00 |
| 20:30 |
| 21:00 |
| 21:30 |
| 22:00 |
| 22:30 |
| 23:00 |
操作:
```text
启动程序
```
程序:
```text
D:\temp\get_connection.bat
```
---
## 4. PowerShell 一键创建计划任务(推荐)
管理员 PowerShell 执行:
```powershell
$action = New-ScheduledTaskAction `
-Execute "D:\temp\get_connection.bat"
$times = @(
"19:30",
"20:00",
"20:30",
"21:00",
"21:30",
"22:00",
"22:30",
"23:00"
)
foreach ($t in $times)
{
$trigger = New-ScheduledTaskTrigger `
-Daily `
-At $t
Register-ScheduledTask `
-TaskName ("GetConnection_" + $t.Replace(":","")) `
-Action $action `
-Trigger $trigger `
-RunLevel Highest `
-Force
}
```
---
## 5. 建议增加 TCP 关键指标
为了分析你当前 Hyper-V + NAT + 70万连接场景,建议额外记录:
```powershell
netstat -ano | find /c "ESTABLISHED"
```
```powershell
Get-NetTCPSetting
```
```powershell
Get-NetOffloadGlobalSetting
```
```powershell
Get-NetAdapterRss
```
```powershell
Get-NetAdapterVmq
```
```powershell
Get-VMNetworkAdapter -ManagementOS
```
添加后的完整D:\\temp\\get\_connection.ps1文件内容:
```powershell
$LogFile = "D:\temp\get_connection.log"
Add-Content $LogFile ""
Add-Content $LogFile "===================================================================="
Add-Content $LogFile "$(Get-Date -Format 'yyyy-MM-dd HH:mm:ss')"
Add-Content $LogFile "===================================================================="
# TCP连接总数
Add-Content $LogFile ""
Add-Content $LogFile "[Get-NetTCPConnection | Measure-Object]"
Get-NetTCPConnection | Measure-Object | Out-String | Add-Content $LogFile
# TCP状态统计
Add-Content $LogFile ""
Add-Content $LogFile "[Get-NetTCPConnection | Group-Object State]"
Get-NetTCPConnection | Group-Object State |
Sort-Object Count -Descending |
Format-Table Count,Name -AutoSize |
Out-String | Add-Content $LogFile
# ESTABLISHED数量
Add-Content $LogFile ""
Add-Content $LogFile "[ESTABLISHED Count]"
(netstat -ano | findstr ESTABLISHED | Measure-Object -Line).Lines |
Out-String | Add-Content $LogFile
# VMQ状态
Add-Content $LogFile ""
Add-Content $LogFile "[Get-NetAdapterVmq]"
Get-NetAdapterVmq |
Format-Table -AutoSize |
Out-String | Add-Content $LogFile
# RSS状态
Add-Content $LogFile ""
Add-Content $LogFile "[Get-NetAdapterRss]"
Get-NetAdapterRss |
Format-Table -AutoSize |
Out-String | Add-Content $LogFile
# 网卡统计
Add-Content $LogFile ""
Add-Content $LogFile "[Get-NetAdapterStatistics]"
Get-NetAdapterStatistics |
Format-Table -AutoSize |
Out-String | Add-Content $LogFile
# TCP参数
Add-Content $LogFile ""
Add-Content $LogFile "[Get-NetTCPSetting]"
Get-NetTCPSetting |
Format-Table -AutoSize |
Out-String | Add-Content $LogFile
# 网卡卸载状态
Add-Content $LogFile ""
Add-Content $LogFile "[Get-NetOffloadGlobalSetting]"
Get-NetOffloadGlobalSetting |
Format-List |
Out-String | Add-Content $LogFile
# Hyper-V虚拟网卡
Add-Content $LogFile ""
Add-Content $LogFile "[Get-VMNetworkAdapter -ManagementOS]"
try {
Get-VMNetworkAdapter -ManagementOS |
Format-Table -AutoSize |
Out-String | Add-Content $LogFile
}
catch {
Add-Content $LogFile "Hyper-V module not available."
}
# 网络流量
Add-Content $LogFile ""
Add-Content $LogFile "[Network Interface Bytes Total/sec]"
Get-Counter '\Network Interface(*)\Bytes Total/sec' |
Select-Object -ExpandProperty CounterSamples |
Format-Table InstanceName,CookedValue -AutoSize |
Out-String | Add-Content $LogFile
# 网卡PPS
Add-Content $LogFile ""
Add-Content $LogFile "[Network Interface Packets Sent/sec]"
Get-Counter '\Network Interface(*)\Packets Sent/sec' |
Select-Object -ExpandProperty CounterSamples |
Format-Table InstanceName,CookedValue -AutoSize |
Out-String | Add-Content $LogFile
Add-Content $LogFile ""
Add-Content $LogFile "[Network Interface Packets Received/sec]"
Get-Counter '\Network Interface(*)\Packets Received/sec' |
Select-Object -ExpandProperty CounterSamples |
Format-Table InstanceName,CookedValue -AutoSize |
Out-String | Add-Content $LogFile
# Hyper-V Virtual Switch流量
Add-Content $LogFile ""
Add-Content $LogFile "[Hyper-V Virtual Switch Bytes/sec]"
Get-Counter '\Hyper-V Virtual Switch(*)\Bytes/sec' |
Select-Object -ExpandProperty CounterSamples |
Format-Table InstanceName,CookedValue -AutoSize |
Out-String | Add-Content $LogFile
# Hyper-V Virtual Adapter流量
Add-Content $LogFile ""
Add-Content $LogFile "[Hyper-V Virtual Network Adapter(*)\Bytes/sec]"
Get-Counter '\Hyper-V Virtual Network Adapter(*)\Bytes/sec' |
Select-Object -ExpandProperty CounterSamples |
Format-Table InstanceName,CookedValue -AutoSize |
Out-String | Add-Content $LogFile
# CPU
Add-Content $LogFile ""
Add-Content $LogFile "[CPU]"
Get-Counter '\Processor(*)\% Processor Time' |
Select-Object -ExpandProperty CounterSamples |
Format-Table InstanceName,CookedValue -AutoSize |
Out-String | Add-Content $LogFile
# 网络队列长度
Add-Content $LogFile ""
Add-Content $LogFile "[Network Output Queue Length]"
Get-Counter '\Network Interface(*)\Output Queue Length' |
Select-Object -ExpandProperty CounterSamples |
Format-Table InstanceName,CookedValue -AutoSize |
Out-String | Add-Content $LogFile
# Hyper-V VM Switch丢包
Add-Content $LogFile ""
Add-Content $LogFile "[Hyper-V Switch Packets/sec]"
try {
Get-Counter '\Hyper-V Virtual Switch(*)\Packets/sec' |
Select-Object -ExpandProperty CounterSamples |
Format-Table InstanceName,CookedValue -AutoSize |
Out-String | Add-Content $LogFile
}
catch {
Add-Content $LogFile "Counter not available."
}
Add-Content $LogFile ""
Add-Content $LogFile "END"
```
这两个对于判断 Hyper-V 在 70 万 NAT 连接场景下是否存在 RSS/VMQ 瓶颈非常有帮助。
# Windows 11 安装 IP-Guard 客户端后Microsoft Edge现崩溃
如果 **Windows 11 安装 IP-Guard 客户端后,Microsoft Edge 出现崩溃、闪退或无法启动**,通常是以下几类原因导致:
## 一、常见原因分析
### 1. IP-Guard 浏览器插件兼容性问题(最常见)
IP-Guard 会注入以下功能:
- 网页审计
- 文件外发控制
- 截图监控
- 剪贴板监控
- 水印功能
这些功能通常通过:
```text
Browser Extension
DLL Injection
Kernel Driver
```
实现。
Windows 11 新版 Edge(Chromium 内核)升级后,可能与 IP-Guard 旧版本不兼容。
常见现象:
```text
Edge启动即关闭
Edge白屏
Edge打开网页崩溃
Edge多标签页崩溃
```
---
### 2. Edge GPU加速冲突
很多终端管控软件会与:
```text
Intel UHD
NVIDIA
AMD
```
显卡驱动产生冲突。
查看事件日志经常看到:
```text
Application Error
msedge.exe
d3d11.dll
igd10iumd64.dll
nvwgf2umx.dll
```
---
### 3. WebView2运行库冲突
Edge 和很多办公软件都依赖:
Microsoft Edge WebView2 Runtime
IP-Guard版本较旧时可能导致:
```text
WebView2崩溃
Edge崩溃
Outlook崩溃
Teams崩溃
```
---
### 4. DLL注入失败
查看:
```cmd
tasklist /m | findstr ipg
```
可能看到:
```text
ipg*.dll
```
被加载到:
```text
msedge.exe
```
进程中。
如果 DLL 与 Edge 当前版本不兼容,就会导致崩溃。
---
## 二、查看崩溃日志
### 方法1:事件查看器
运行:
```cmd
eventvwr.msc
```
进入:
```text
Windows日志
└ 应用程序
```
筛选:
```text
错误
Application Error
```
重点查看:
```text
故障应用程序名称:
msedge.exe
故障模块名称:
xxxx.dll
```
例如:
```text
ipgmon.dll
ipgflt.dll
ipgbrowser.dll
```
基本可以确认是IP-Guard导致。
---
### 方法2:可靠性监视器
运行:
```cmd
perfmon /rel
```
查看:
```text
Microsoft Edge
已停止工作
```
详细信息。
---
## 三、快速验证是否为IP-Guard导致
管理员CMD:
```cmd
taskkill /f /im ipg*.exe
```
或停止相关服务:
```cmd
services.msc
```
找到:
```text
IP-Guard
IPG Agent
IPG Monitor
```
停止后测试Edge。
如果恢复正常:
```text
基本可确认是IP-Guard兼容性问题
```
---
## 四、Edge修复
### 修复浏览器
打开:
```text
设置
└ 应用
└ 已安装应用
└ Microsoft Edge
```
选择:
```text
修改
Repair
```
或者执行:
```cmd
"C:\Program Files (x86)\Microsoft\Edge\Application\Installer\setup.exe" --repair
```
---
### 清理用户配置
关闭Edge:
```cmd
taskkill /f /im msedge.exe
```
备份后删除:
```text
%LOCALAPPDATA%\Microsoft\Edge\User Data
```
重新启动。
---
## 五、关闭GPU加速测试
启动:
```cmd
msedge.exe --disable-gpu
```
如果正常:
说明显卡加速与IP-Guard冲突。
然后:
```text
设置
└ 系统和性能
└ 使用硬件加速
```
关闭。
---
## 六、重装 WebView2
卸载:
Microsoft Edge WebView2 Runtime
然后从微软官网下载最新版重新安装:
[Microsoft Edge WebView2 官方下载页](https://developer.microsoft.com/microsoft-edge/webview2/?utm_source=chatgpt.com)
---
## 七、检查IP-Guard版本
重点确认:
```text
IP-Guard版本
Windows 11版本
Edge版本
```
例如:
```text
IP-Guard 4.x
+
Windows 11 24H2
+
Edge 140+
```
经常出现兼容问题。
建议联系厂商获取:
```text
最新Agent
最新浏览器插件
最新驱动
```
---
## 八、企业环境推荐排查命令
以管理员运行:
```powershell
Get-WinEvent -LogName Application -MaxEvents 100 |
Where-Object {$_.LevelDisplayName -eq "Error"} |
Select-Object TimeCreated,ProviderName,Id,Message
```
查看 Edge 崩溃:
```powershell
Get-WinEvent -FilterHashtable @{
LogName='Application'
ProviderName='Application Error'
} | Select -First 20
```
查看加载模块:
```cmd
tasklist /m /fi "imagename eq msedge.exe"
```
---
如果您能提供以下信息:
1. IP-Guard具体版本号(例如 4.x、5.x、6.x)
2. Windows 11版本(23H2、24H2等)
3. Edge版本(设置→关于 Microsoft Edge)
4. 事件查看器中 msedge.exe 的“故障模块名称”
我可以进一步判断是:
- IP-Guard浏览器插件冲突
- 驱动冲突
- WebView2冲突
- GPU加速冲突
- Windows 11补丁兼容问题
并给出针对性的修复方案。
# Windows Server 2022 创建WebDAV共享
\# Windows Server 2022 创建WebDAV共享(目录 F:\\本地知识库)完整步骤
\## 一、安装IIS + WebDAV角色功能
1\. 打开 \*\*服务器管理器 → 添加角色和功能\*\*
2\. 角色页面勾选:\*\*Web服务器(IIS)\*\*,一路下一步
3\. 在「Web服务器角色服务」里额外勾选:
\- 常见HTTP功能:全部默认
\- \*\*WebDAV发布\*\*(核心,必须勾选)
4\. 下一步完成安装,等待组件部署完毕。
\## 二、IIS中新建网站,绑定F:\\本地知识库
1\. 打开 \*\*Internet 信息服务(IIS)管理器\*\*
2\. 左侧「网站」右键 → \*\*添加网站\*\*
\- 网站名称:`KnowledgeWebDAV`(自定义)
\- 物理路径:`F:\\本地知识库`
\- IP地址:选服务器内网固定IP(如192.168.0.83)
\- 端口:8080(避免占用80,和你RAGFlow配置一致)
\- 主机名:留空 → 确定创建
\## 三、启用WebDAV功能(关键步骤)
1\. 左侧选中刚创建的 `KnowledgeWebDAV` 网站
2\. 中间功能列表双击 \*\*WebDAV授权规则\*\*
3\. 右侧点击 \*\*启用WebDAV\*\*
\### 配置WebDAV访问权限
1\. 右侧「添加允许规则」
\- 允许访问:\*\*指定用户\*\*(填写域账号 `shuncom\\7004`,或本地账号)
\- 权限:勾选 \*\*读取、写入\*\*
2\. 若需要只读给RAGFlow,仅勾选「读取」即可。
\## 四、关闭匿名访问,强制账号密码登录
1\. 网站主页双击 \*\*身份验证\*\*
2\. 右键 \*\*匿名身份验证 → 禁用\*\*
3\. 确保 \*\*基本身份验证\*\* 状态为「已启用」
> 注意:WebDAV Linux客户端普遍只兼容「基本身份验证」,不要用Windows身份验证。
\## 五、设置目录浏览(可选,方便Windows客户端访问)
1\. 双击「目录浏览」→ 右侧启用,打开文件夹列表展示。
\## 六、Windows防火墙放行8080端口
1\. 高级防火墙 → 入站规则 → 新建规则
2\. 端口 → TCP 8080
3\. 允许连接,域/专用/公网全勾选
4\. 名称:WebDAV-8080,完成。
\## 七、权限兜底:F:\\本地知识库 NTFS权限
1\. 右键 `F:\\本地知识库` → 属性 → 安全
2\. 添加账号 `shuncom\\7004`,赋予:
\- 读取 & 执行
\- 列出文件夹内容
\- 读取
3\. 高级 → 勾选「替换子容器和对象的权限项」应用到全部子文件。
\## 八、RAGFlow WebDAV参数对应填写
1\. WebDAV Server URL:`http://192.168.0.83:8080`
2\. Username:`shuncom\\7004`
3\. Password:账号对应密码
4\. Remote Path:`/`
> 物理路径直接绑定F:\\本地知识库,远端根路径填写 `/` 即可,无需额外目录。
\## 九、测试连通(先在Windows测试,再Linux服务器测试)
\### Windows资源管理器
地址栏输入:
```
http://192.168.0.83:8080
```
弹出账号框输入 `shuncom\\7004` + 密码,能看到文件夹内所有文档即正常。
\### Ubuntu RAGFlow服务器测试连通性
```bash
\# 测试WebDAV接口连通
curl http://192.168.0.83:8080 --user shuncom\\7004:你的密码
```
能返回目录列表HTML代表服务正常,不会出现同步total=0的问题。
\## 常见踩坑
1\. 同步扫描文件为0:
\- 禁用匿名访问、开启基本身份验证;
\- URL不要用`.local`域名,直接写服务器内网IP;
\- Remote Path 填写 `/`,不要多写层级。
2\. Linux挂载/访问401权限拒绝:
\- WebDAV授权规则未添加对应账号;
\- NTFS文件夹缺少读取权限;
\- 仅启用Windows身份验证,未开基本验证。
3\. 端口不通:防火墙未放行TCP 8080入站规则。
# Robocopy 完整教程(Windows Server 2025 / Win10/11 通用)
\## 重要前置说明
✅ \*\*Robocopy 是 Windows 系统自带工具,不需要安装!\*\*
系统路径:`C:\\Windows\\System32\\robocopy.exe`
Windows Server 2008R2 及以上、Win10/11 默认内置,无需下载安装。
> 你的场景:DFS 文件服务器、NTFS权限完整备份、配合 Veeam,替代 FreeFileSync 跨盘同步、保留ACL。
\## 一、快速验证是否可用
以\*\*管理员身份打开 PowerShell / CMD\*\*
```
robocopy /?
```
弹出帮助文档 = 正常可用。
\## 二、核心参数对照表(适配你的 DFS 文件服务器场景)
\### 最关键参数(复制NTFS权限必备)
| 参数 | 作用 |
|------|------|
| `/MIR` | 镜像模式:目标和源保持一致;新增文件复制、删除目标多余文件(谨慎!) |
| `/COPYALL` | 复制【所有文件信息】:数据、属性、时间戳、\*\*所有者、组、DACL、SACL\*\*(完整NTFS安全权限) |
| `/COPY:DATSOU` | 和 `/COPYALL` 等效;D=数据 A=属性 T=时间 S=安全ACL O=所有者 U=审计SACL |
| `/B` | 备份模式,绕过文件权限限制,可锁定文件(VSS快照文件/被占用文件必备) |
| `/R:3` | 失败重试3次(默认100万次,必须修改) |
| `/W:5` | 重试间隔5秒 |
| `/NP` | 不显示进度百分比(日志整洁) |
| `/LOG:D:\\sync\_log\\robocopy\_log.txt` | 输出日志到文件 |
| `/V` | 详细输出,查看哪些文件被复制 |
> ⚠️ 重点:\*\*`/COPYALL` 必须管理员权限运行,否则权限复制失效!\*\*
> ⚠️ SMB共享UNC路径(`\\\\shuncom.local\\dfs`) 无法稳定复制【所有者】,优先使用本地盘符E: D:
\## 三、常用模板命令(直接复制使用)
\### 模板1:标准镜像备份(推荐你的业务:NVMe E盘 → RAID6 D盘归档)
管理员CMD/PowerShell执行
```
robocopy E:\DFS_SHARE D:\DFS_BACKUP /MIR /COPYALL /B /R:3 /W:5 /V /LOG:D:\robocopy_log.txt
```
解释:
1\. `E:\\DFS\_SHARE` 源目录(NVMe三副本存储本地路径)
2\. `D:\\DFS\_BACKUP` 备份目标(RAID6机械归档盘)
3\. `/MIR` 镜像同步(源删除的文件,目标同步删除;测试环境先用模板2!)
\### 模板2:增量同步【不删除目标多余文件,安全测试用】
```
robocopy E:\DFS_SHARE D:\DFS_BACKUP /COPYALL /B /R:3 /W:5 /V /LOG:D:\robocopy_log.txt
```
> 没有 `/MIR`:只会新增/更新文件,不会删除目标目录旧文件,适合初次测试。
\### 模板3:只同步新增修改文件,排除部分文件夹
```
robocopy E:\DFS_SHARE D:\DFS_BACKUP /COPYALL /B /R:3 /W:5 /XD "E:\DFS_SHARE\临时文件" "E:\DFS_SHARE\缓存"
```
`/XD` 排除指定目录
\## 四、返回码判断(脚本自动化关键)
Robocopy退出代码\*\*0~7 均为正常,不是错误\*\*
\- 0:无文件需要复制
\- 1:文件成功复制
\- 8及以上:发生错误(权限失败、磁盘离线等)
PowerShell判断示例:
```
robocopy E:\DFS_SHARE D:\DFS_BACKUP /MIR /COPYALL /B
$exitCode = $LASTEXITCODE
if($exitCode -ge 8){
Write-Host "同步出现严重错误!"
}else{
Write-Host "同步完成,正常"
}
```
\## 五、适配你环境的【定时自动同步方案】
\### 方案1:创建bat脚本,任务计划程序调用,编码选择:ANSI(重点!不要 UTF8)
新建 `DFS\_Backup.bat`
```
@echo off
chcp 936 >nul
setlocal enabledelayedexpansion
:: 路径不要带中文,或者确保ANSI保存;建议后续尽量使用英文目录名规避编码坑
set "Source=\\shuncom.local\dfs\99.顺舟云盘"
set "Target=D:\其他资料备份\Shun-Users\192.168.0.84\Shares\Shun-Users"
set "LogDir=D:\其他资料备份\Shun-Users"
set "LogPath=%LogDir%\robocopy_%date:~0,4%%date:~5,2%%date:~8,2%.log"
:: 自动创建日志目录
if not exist "%LogDir%" mkdir "%LogDir%"
robocopy "%Source%" "%Target%" ^
/MIR /COPY:DATS /B /R:3 /W:5 /V /NP /LOG:"%LogPath%"
:: 退出码判断
set "exitcode=%errorlevel%"
echo.
echo ==============================================
echo Robocopy执行返回码:%exitcode%
echo 0~7 = 正常;>=8 = 异常错误
echo ==============================================
pause
```
1. 1. 保存脚本
2. \*\*Windows任务计划程序\*\*新建任务
- 勾选【使用最高权限运行】(重中之重,否则ACL权限复制失败)
- 设置触发周期(每日凌晨执行)
- 操作:启动程序,选择这个bat文件
2. 运行时实时跟踪日志
```
Get-Content .\robocopy_20260730.log -Wait
```
\## 六、重点避坑(对应你FreeFileSync遇到的NTFS权限问题)
1\. ❌ \*\*普通权限运行 → /COPYALL失效,NTFS安全属性不复制\*\*
✅ 必须管理员启动CMD/PowerShell,任务计划勾选【最高权限】
2\. ❌ 直接同步 `\\\\shuncom.local\\DFS` 网络UNC共享
✅ 优先在文件服务器本机使用本地盘符E:/D:同步;SMB协议限制无法完整迁移文件所有者SID
3\. ❌ 目标分区不是NTFS
✅ exFAT/FAT32不支持ACL,权限直接丢失
4\. ❌ 目标目录开启权限继承
同步完成后,新文件上层继承权限会覆盖单独设置的文件ACL,需要业务侧规划权限模型
\## 七、Robocopy VS FreeFileSync(你的场景对比)
1\. Robocopy:Windows原生,NTFS ACL/所有者复制稳定性更强,适合服务器长期自动化备份;
2\. FreeFileSync:图形界面友好,但\*\*跨SMB共享复制权限存在缺陷\*\*;
> 建议:图形调试用FreeFileSync,\*\*生产定时自动备份使用Robocopy脚本\*\*
\## 八、进阶:搭配VSS,同步被占用/打开的文件
如果文件被用户打开占用,Robocopy默认跳过,可以搭配系统卷影副本,需要我给你完整的VSS+Robocopy一键脚本吗?
# 5000个域用户怎么管理?PowerShell几分钟搞定AD日常运维
在很多企业里,Active Directory(AD)已经运行了十几年。从员工账号管理,到电脑统一管理,再到ERP、MES、OA、PLM等系统的身份认证,AD几乎已经成为企业IT基础设施的重要组成部分。但我发现一个有趣的现象:很多IT工程师每天都在管理AD,却依然习惯:
-
-
-
-
-
人数少的时候问题不大。当企业规模达到:
-
-
-
再继续靠鼠标运维,效率就会越来越低。这时候,PowerShell的价值就体现出来了。同样是账号管理,手工操作可能需要半天,PowerShell往往只需要几行命令。
例如:
-
-
-
-
-
-
这些原本需要数小时完成的工作,几分钟就能处理完毕。本篇文章结合实际运维经验,整理了AD管理员最常用的PowerShell命令
## 0. 准备工作
```
# 导入 AD 模块(PowerShell 7 需显式导入)
Import-Module ActiveDirectory
# 指定域控执行(避免连到非预期 DC)
Get-ADUser -Identity zhangsan -Server DC01.contoso.com
```
## 1. 用户管理
```
# 查询单个用户及属性
Get-ADUser -Identity zhangsan -Properties *
# 查找已禁用 / 已过期账户
Get-ADUser -Filter {Enabled -eq $false} -Properties whenChanged
Get-ADUser -Filter {AccountExpirationDate -lt (Get-Date)}
# 查找最近未登录账户(90天未登录)
$cutoff = (Get-Date).AddDays(-90)
Get-ADUser -Filter {lastLogonTimestamp -lt $cutoff} -Properties lastLogonTimestamp |
Select-Object Name, SamAccountName, @{n='LastLogon';e={[datetime]::FromFileTime($_.lastLogonTimestamp)}}
# 新建用户
New-ADUser -Name ”张三” -SamAccountName ”zhangsan” -UserPrincipalName ”zhangsan@contoso.com” `
-Path ”OU=员工,DC=contoso,DC=com” -AccountPassword (ConvertTo-SecureString ”P@ssw0rd!” -AsPlainText -Force) `
-Enabled $true -ChangePasswordAtLogon $true
# 启用 / 禁用 / 解锁
Enable-ADAccount zhangsan
Disable-ADAccount zhangsan
Unlock-ADAccount zhangsan
# 重置密码
Set-ADAccountPassword -Identity zhangsan -NewPassword (ConvertTo-SecureString ”NewP@ss!” -AsPlainText -Force) -Reset
Set-ADUser -Identity zhangsan -ChangePasswordAtLogon $true
# 下次登录强制改密
# 移动用户 / 删除(先禁用再删)
Move-ADObject -Identity ”CN=zhangsan,OU=员工,DC=contoso,DC=com” -TargetPath ”OU=离职,DC=contoso,DC=com”
Remove-ADUser zhangsan -Confirm
```
## 2. 组管理
```
Get-ADGroup -Filter * -Properties Description
Get-ADGroupMember ”Domain Admins” -Recursive
# 递归查看成员
Add-ADGroupMember -Identity ”Domain Admins” -Members zhangsan
Remove-ADGroupMember -Identity ”Domain Admins” -Members zhangsan -Confirm
# 查看用户属于哪些组
Get-ADPrincipalGroupMembership zhangsan
```
## 3. 计算机账户
```
Get-ADComputer -Filter {Enabled -eq $false}
# 查停用计算机
Get-ADComputer -Identity WS001 -Properties LastLogonDate, OperatingSystem
# 清理失效计算机(30天未登录)
$cutoff = (Get-Date).AddDays(-30)
Get-ADComputer -Filter {LastLogonDate -lt $cutoff} | Remove-ADComputer -Confirm
```
## 4. 密码策略与锁定排查
```
# 默认域密码策略
Get-ADDefaultDomainPasswordPolicy
Set-ADDefaultDomainPasswordPolicy -MaxPasswordAge 90 -MinPasswordLength 12
# 排查账户锁定来源(核心:查 4740 事件)
$user = ”zhangsan”
Get-WinEvent -LogName Security -FilterXPath ”*[System[EventID=4740]]” -MaxEvents 20 |
Where-Object { $_.Properties[0].Value -eq $user } |
Select-Object TimeCreated, @{n='Source';e={$_.Properties[1].Value}} | Format-Table -Auto
```
## 5. 复制与域控健康(日常必查)
```
# 复制汇总(最常用,一行看出全林复制状态)
repadmin /replsummary
# 单台 DC 入站/出站复制
repadmin /showrepl DC01
repadmin /queue DC01
# 强制立即复制
repadmin /syncall /AdeP
# 域控健康检查
dcdiag /v
dcdiag /test:replications
dcdiag /test:dns
# PowerShell 版复制状态
Get-ADReplicationPartnerMetadata -Target DC01 -Partition '*' -PartnerType Both |
Select-Object Server, Partner, LastReplicationSuccess, ConsecutiveFailureCount
```
## 6. FSMO 角色
```
Get-ADDomainController -Filter * | Select-Object Name, Domain, OperationMasterRoles
Move-ADDirectoryServerOperationMasterRole -Identity DC02 -OperationMasterRole SchemaMaster
# 或者用传统命令查看
netdom query fsmo
```
## 7. DNS 管理
```
Clear-DnsServerCache -ComputerName DC01
Get-DnsServerResourceRecord -ZoneName ”contoso.com” -Name ”web” -RRType A
Add-DnsServerResourceRecordA -ZoneName ”contoso.com” -Name ”web” -IPv4Address 10.0.0.10
Remove-DnsServerResourceRecord -ZoneName ”contoso.com” -RRType A -Name ”web” -Force
Get-DnsServerZone -ComputerName DC01
# 查看所有区域
Get-DnsServerDiagnostics | Select-Object EnableLoggingForQuery, EnableLoggingForZoneTransfer
# 查看 DNS 记录变更
dnscmd DC01 /enumrecords contoso.com /continue
```
## 8. GPO 组策略
```
Get-GPO -All | Select-Object DisplayName, Owner, ModificationTime
Get-GPOReport -Name ”默认域策略” -ReportType HTML -Path ”C:\temp\gpo.html”
# 导出报告
Backup-GPO -Name ”默认域策略” -Path ”C:\backup\gpo”
# 备份
New-GPO -Name ”禁用U盘” | New-GPLink -Target ”OU=员工,DC=contoso,DC=com”
# 建策略并链接
# 强制刷新(客户端执行)
gpupdate /force
# 查看某机器生效的策略结果
gpresult /r /scope computer
```
## 9. 时间同步(域控时间错乱会直接导致 Kerberos 认证失败)
```
w32tm /query /status
# 查看同步状态
w32tm /query /source
# 查看时间源
w32tm /config /manualpeerlist:”ntp.aliyun.com,0x1” /syncfromflags:manual /update
# 改时间源
w32tm /resync
# 立即同步
Restart-Service w32time
# 重启时间服务
```
## 10. 站点与子网
```
Get-ADReplicationSite -Filter * | Select-Object Name, Options, SiteObjectBL
Get-ADReplicationSubnet -Filter *
New-ADReplicationSite -Name ”Shanghai-Site”
New-ADReplicationSubnet -Name ”10.10.0.0/24” -Site ”Shanghai-Site”
```
## 11. 日志与审计(常见事件 ID)
```
# 4740 账户被锁、4720 新用户、4732 加组、4724 改密码、4768 Kerberos 请求
Get-WinEvent -LogName Security -MaxEvents 1000 -FilterXPath ”*[System[EventID=4720]]” |
Select-Object TimeCreated, @{n='User';e={$_.Properties[0].Value}}
# 查域控 DNS/系统错误日志
Get-EventLog -LogName System -EntryType Error -Newest 50 | Where-Object {$_.Source -match 'DNS|NETLOGON|NTDS'}
```
## 12. 日常巡检脚本骨架
```
$report = @()
# 1. 复制状态
$report += repadmin /replsummary | Out-String
# 2. 无法登录的账户(密码过期)
$report += ”`n=== 密码快过期/已过期的账户 ===”
$report += Get-ADUser -Filter {Enabled -eq $true} -Properties msDS-UserPasswordExpiryTimeComputed |
Where-Object { $_.msDS-UserPasswordExpiryTimeComputed -ne $null -and [datetime]::FromFileTime($_.msDS-UserPasswordExpiryTimeComputed) -lt (Get-Date).AddDays(7) } |
Select-Object SamAccountName, @{n='Expiry';e={[datetime]::FromFileTime($_.msDS-UserPasswordExpiryTimeComputed)}} | Out-String
# 3. 时间同步
$report += ”`n=== 时间状态 ===”
$report += w32tm /query /status | Out-String
$report | Out-File ”C:\temp\dc_audit_$(Get-Date -Format yyyyMMdd).txt”
```
---
几点实用建议:
- 先 `Import-Module ActiveDirectory`;PowerShell 5.1(Windows 自带)比 7 兼容性更稳,管理脚本建议用 5.1。
- 锁定排查先看事件日志里 4740 的 `Caller Computer Name`,比猜更准。
- 日常最值得盯的 3 个指标:复制失败(repadmin)、时间偏移(w32tm)、账户大量锁定(4740 事件)。
PowerShell不仅仅是一门脚本语言,更是一名Windows运维工程师迈向自动化运维的必经之路。学会它之后,你会发现:
以前需要半天完成的工作,现在可能几分钟就能搞定;
以前需要熬夜处理的任务,现在可能定时脚本就能自动完成。
后续我还会持续分享:
✅ PowerShell自动化运维实战
✅ Active Directory最佳实践
✅ Windows Server运维技巧
✅ Exchange管理命令大全
✅ DNS与DHCP故障排查
✅ 域控高可用部署方案
✅ AD与ERP、OA、企业微信统一身份认证实践**
**
欢迎关注本公众号。我会持续分享20多年制造业信息化实践中的真实经验、技术干货与避坑指南。让技术少走弯路,让数字化真正创造价值。
# 此工作站和主域之间的信任关系失败怎么办?域信任关系故障处理全攻略
如果你管理过Windows域环境,大概率见过这样一个让人头疼的错误:
```
此工作站和主域之间的信任关系失败。
```
看似简单的一句话,却可能让用户无法登录电脑,无法访问ERP、MES、PLM、文件服务器,甚至导致整条产线无法正常办公。
很多运维人员第一次遇到时都会一脸懵:
-
-
-
-
为什么电脑就是无法登录域?实际上,这个报错的根本原因往往是:
1,计算机账户被删除
2,计算机密码不同步
3,域控恢复后密码回滚
4,快照回退导致机器账号失效
5,AD清理失效计算机误操作
6,域控迁移或重建过程异常
在实际生产环境中,我见过不少企业因为一次域控恢复、一次服务器迁移,导致上百台客户端同时出现信任关系故障。今天老季将结合实际项目经验,从故障原理、排查思路、修复命令到批量处理方案,带大家彻底搞懂AD域信任关系故障。
## 1. 报错含义
域成员计算机与域控制器之间的"安全通道"(Secure Channel)断了,即计算机账户的密码在两侧不一致。
- 失去信任关系:本机(LSA 本地机密)保存的计算机账户密码,与 AD 域控数据库中保存的不一致
- 安全数据库没有对应计算机账户:域控在 AD 数据库中找不到(或验证不过)这台机器的计算机账户
- 注意:域用户密码过期不会报这个错。这两个报错专指"计算机账户"层面,与用户账号无关。
## 2. 根本原因
计算机账户密码运作机制:加域时机器生成一个随机密码,本机和 AD 各存一份,默认每 30 天自动轮换一次,由机器自己发起。只要两侧状态不同步就会脱域。
| |
|---|
| 最常见。机器回滚到旧快照,本机里是旧密码,AD 里已是新密码 |
| |
| |
| 机器长期离线,密码轮换期内域侧/机侧状态漂移,或对象被清理 |
| 用旧备份恢复 AD 数据库(未做权威恢复),计算机账户密码被回退 |
| |
---
```
:DC01 替换为实际域控主机名
``````
netdom resetpwd /server:DC01 /userd:域名\administrator /passwordd:*
```
或 PowerShell:
```
Reset-ComputerMachinePassword -Server DC01 -Credential 域名\administrator
``````
Test-ComputerSecureChannel -Repair -Credential 域名\administrator
```
执行后重启,即可正常登录。
版本说明:
- Win10 自带 `netdom`(RSAT)与 `Reset-ComputerMachinePassword`
- Win7 原生没有 `Test-ComputerSecureChannel -Repair`(需 PowerShell 3.0/WMF 升级),建议用 netdom
### 方法 2:AD 侧重置计算机账户
适合本地管理员密码也没有的场景。
域控上打开 ADUC(Active Directory 用户和计算机)→ 找到该计算机对象 → 右键"重置账户(Reset Account)"→ 客户端重启后用域管理员登录重新建立通道。
### 方法 3:退出域重加域(兜底方案)
本地管理员登录 → 计算机属性 → 改为工作组(如 WORKGROUP)→ 重启 → 再改回域名 → 重启。
副作用:实际是新建计算机账户,SID 变化。机器上原域用户的缓存配置文件可能因 SID 变化生成新配置目录(如 `username.domain001`),需要手工迁移数据。
### 方法 4:AD 侧导出/导入机密(不推荐)
快照回滚场景的进阶修法,从正常域成员导出机密再导入故障机,操作复杂且涉及敏感数据,一般用方法 1/3 更快。
## 4. 预防措施
1. 虚拟机规范:不回滚已加域虚机的快照;必须回滚后立刻检查修复;模板机必须 sysprep 后再加域
2.
3. - GPO:计算机配置 → 管理模板 → 系统 → 域成员 → "域成员:定期更改计算机账户密码" 设为已禁用
4.
```
reg add "HKLM\SYSTEM\CurrentControlSet\Services\Netlogon\Parameters" /v DisablePasswordChange /t REG_DWORD /d 1 /f
```
- 也可用 `net accounts` 查看/调整 `MaximumPasswordAge`(默认 30 天) - ⚠️ 关闭轮换会降低安全性,适合快照频繁的测试环境;生产环境建议保留默认1. 重装/改名规范:重装系统换新机器名,或先在 AD 里删除旧计算机对象再加入域
2. 保留本地管理员密码:用 LAPS 统一管理,确保故障时能本地登录修复,避免只能重加域
3. 域控备份规范化:用 Windows Server Backup + 正确的 AD 恢复流程,禁止拿快照文件回滚整台域控
4. 定期巡检:批量执行 `Test-ComputerSecureChannel` 健康检查,提前发现即将脱域的机器
## 5. 快速决策表
| |
|---|
| 方法 1(netdom / Reset-ComputerMachinePassword) |
| |
| |
| 预防措施 2(对该 OU 单独下发禁用轮换 GPO) |
| 先查域控本身(是否被回滚/非权威恢复),再批量修复 |